三轮演进,同一套代码库:V1 把发布做出来,V2 把发布做成状态机,V3 把可靠性做成闭环。 本文是系列第三篇,前作:蓝绿发布的实现(V1)、发布引擎状态机化(V2)。
一、这是什么:一个给"人肉运维"收口的平台
先回答最基本的问题。pl-platform 是一套自研的部署运维一体化平台:前端 Vue 3 单页应用,后端 Spring Boot 3.5 单体,通过 SSH 操控目标服务器上的 Docker 与 Nginx,把「构建 → 部署 → 切流量 → 清理 → 监控」这条链路收敛成一次确定性的点击。
三轮演进的脉络值得先交代,因为它决定了这篇文章讲什么:
V2 交付之后我做过一轮自查,列了一份"再不改迟早出事"的清单:AES 密钥和 JWT secret 复用、运行期没有卡单兜底、任务被拒绝就等于失败、没有业务指标、平台自己连日志都没留下。V3 就是照着这份清单改的——所以这篇文章不太像功能介绍,更像一份"可靠性改造的施工记录"。
二、它做什么:五个能力域
2.1 工作台:平台自己的体检报告
打开第一屏不是功能列表,而是平台的自我诊断:
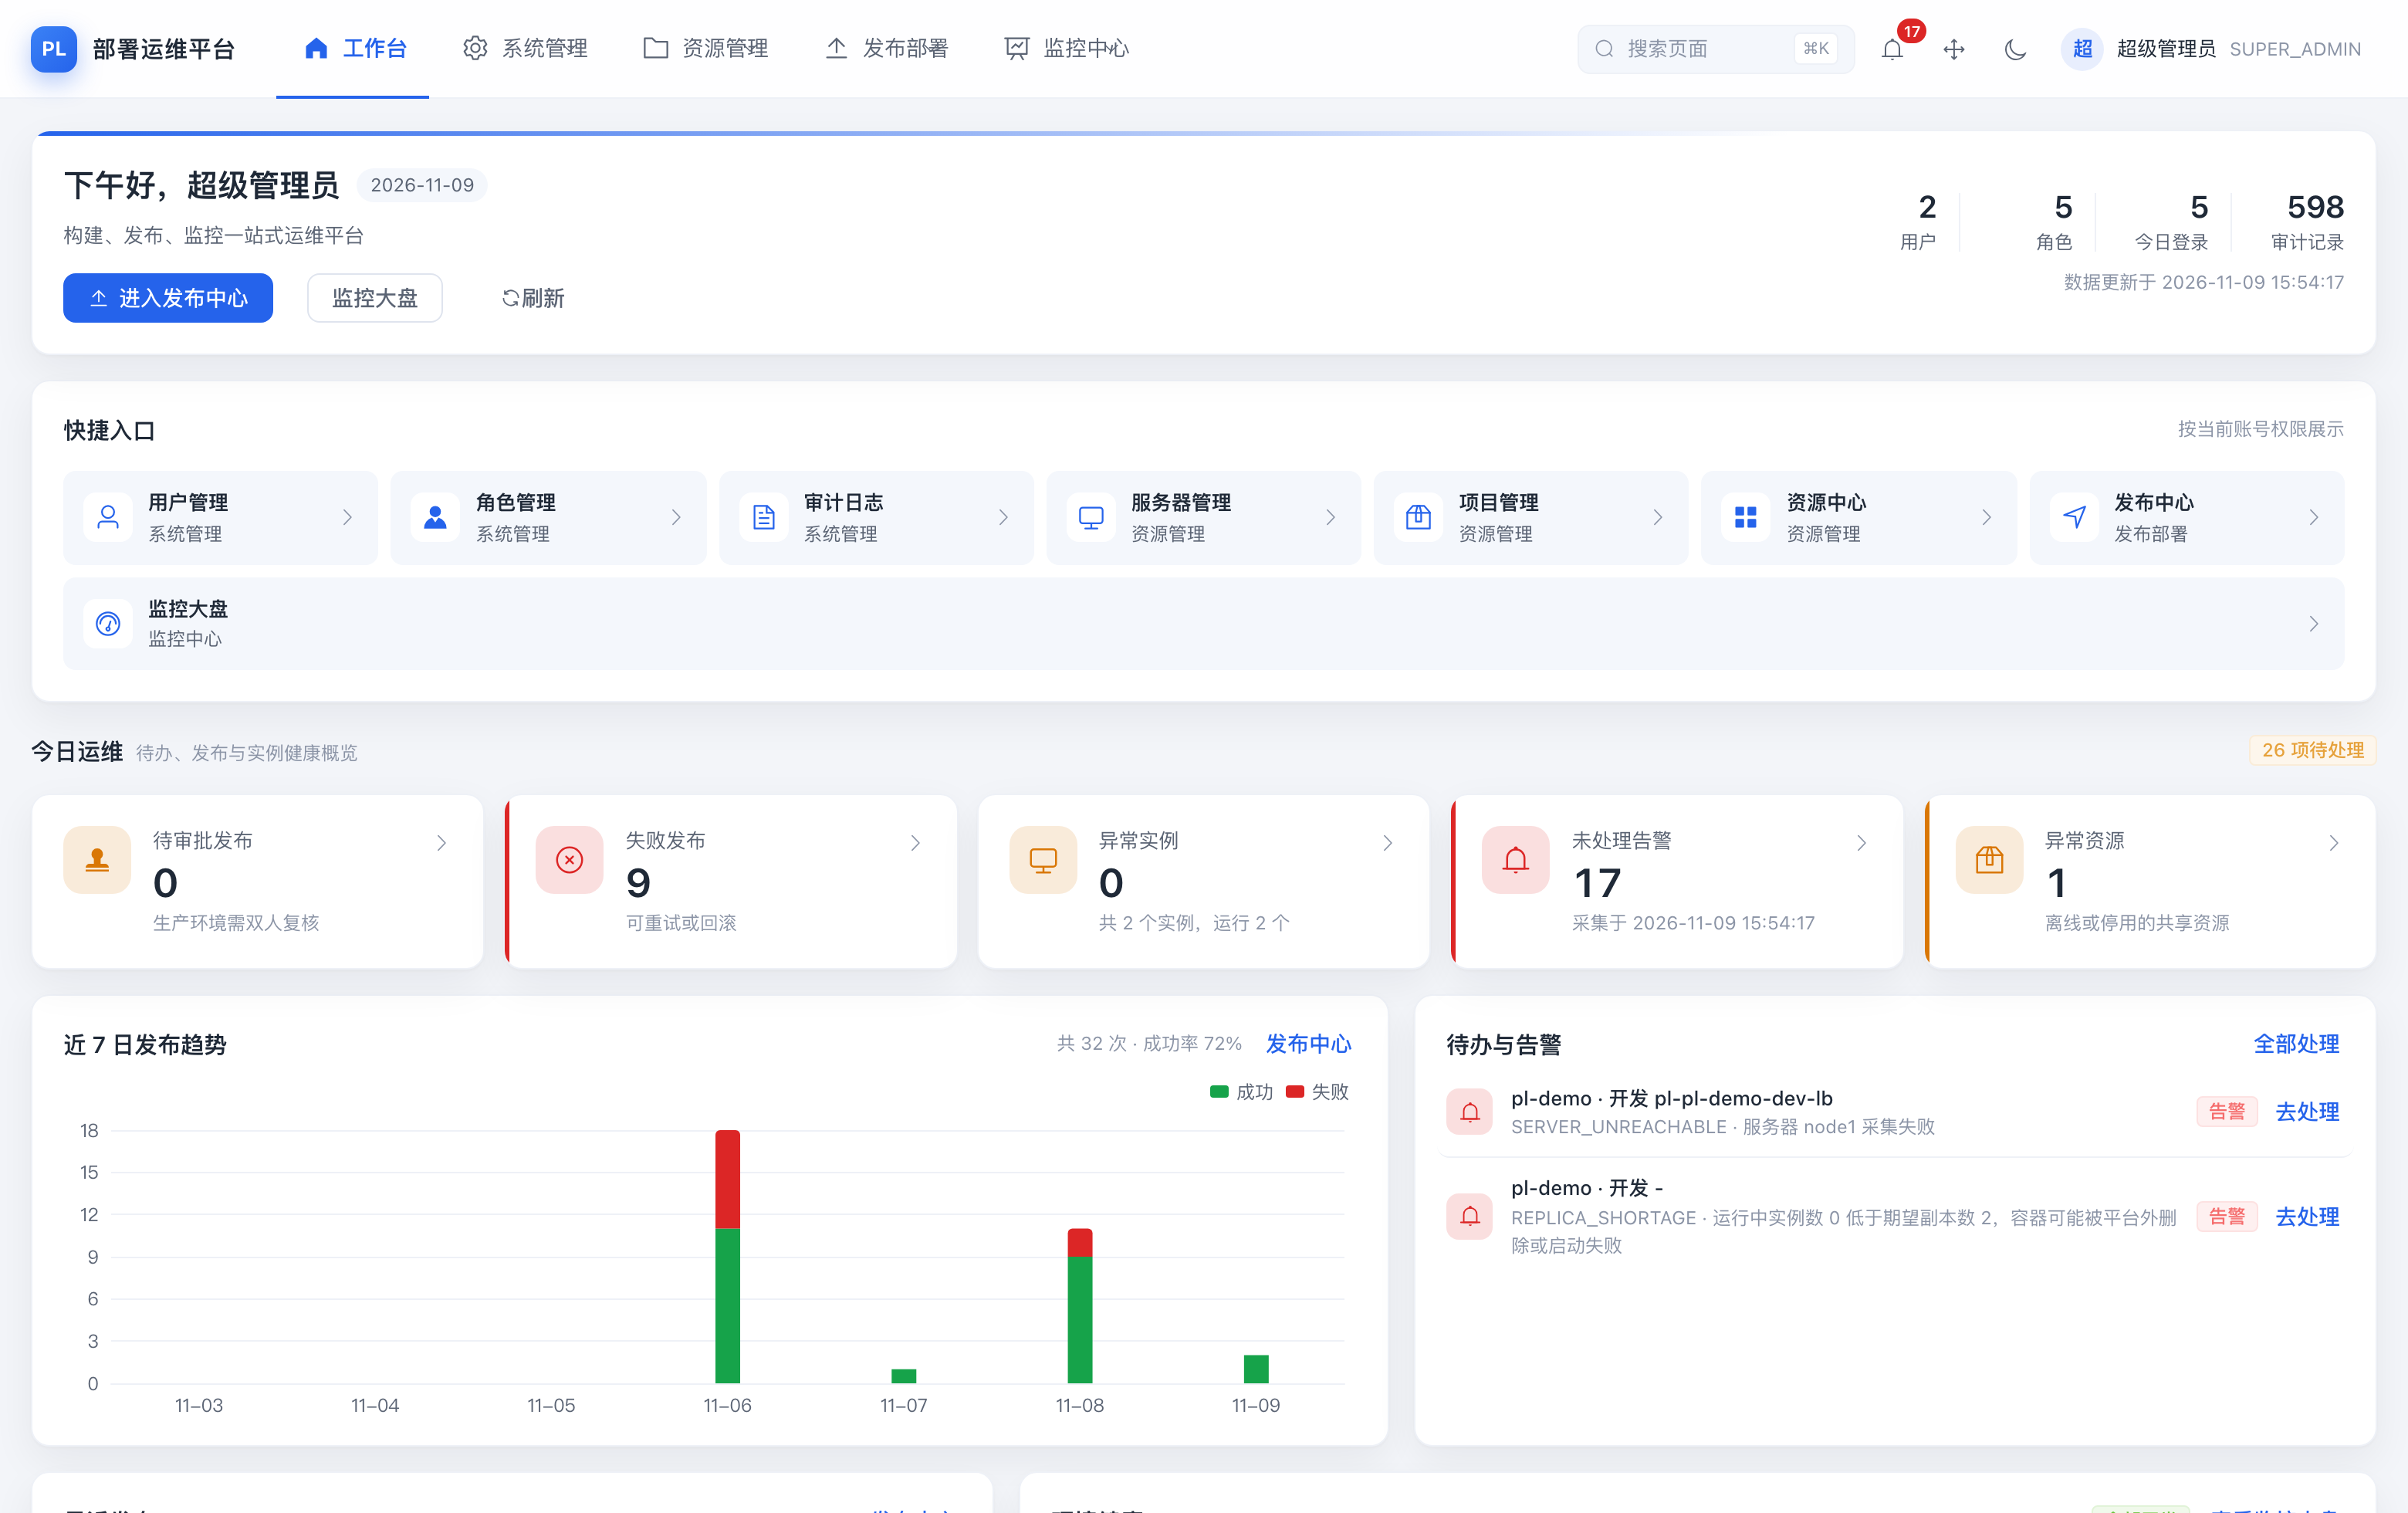
用户 / 角色 / 今日登录 / 审计记录构成基础 KPI;「今日运维」一行是真正的运维语义:待审批发布、失败发布(可重试或回滚)、异常实例、未处理告警、异常资源;近 7 日发布趋势按成败分色出柱状图。运维平台最重要的自省能力——"我现在健康吗、哪里有火"——应该在一屏之内回答完。
2.2 资源管理:从"纳管服务器"到"纳管六类资源"
V2 之前资源中心只有 MySQL 和 Redis。V3 把它扩展成六类外部资源的统一登记处:
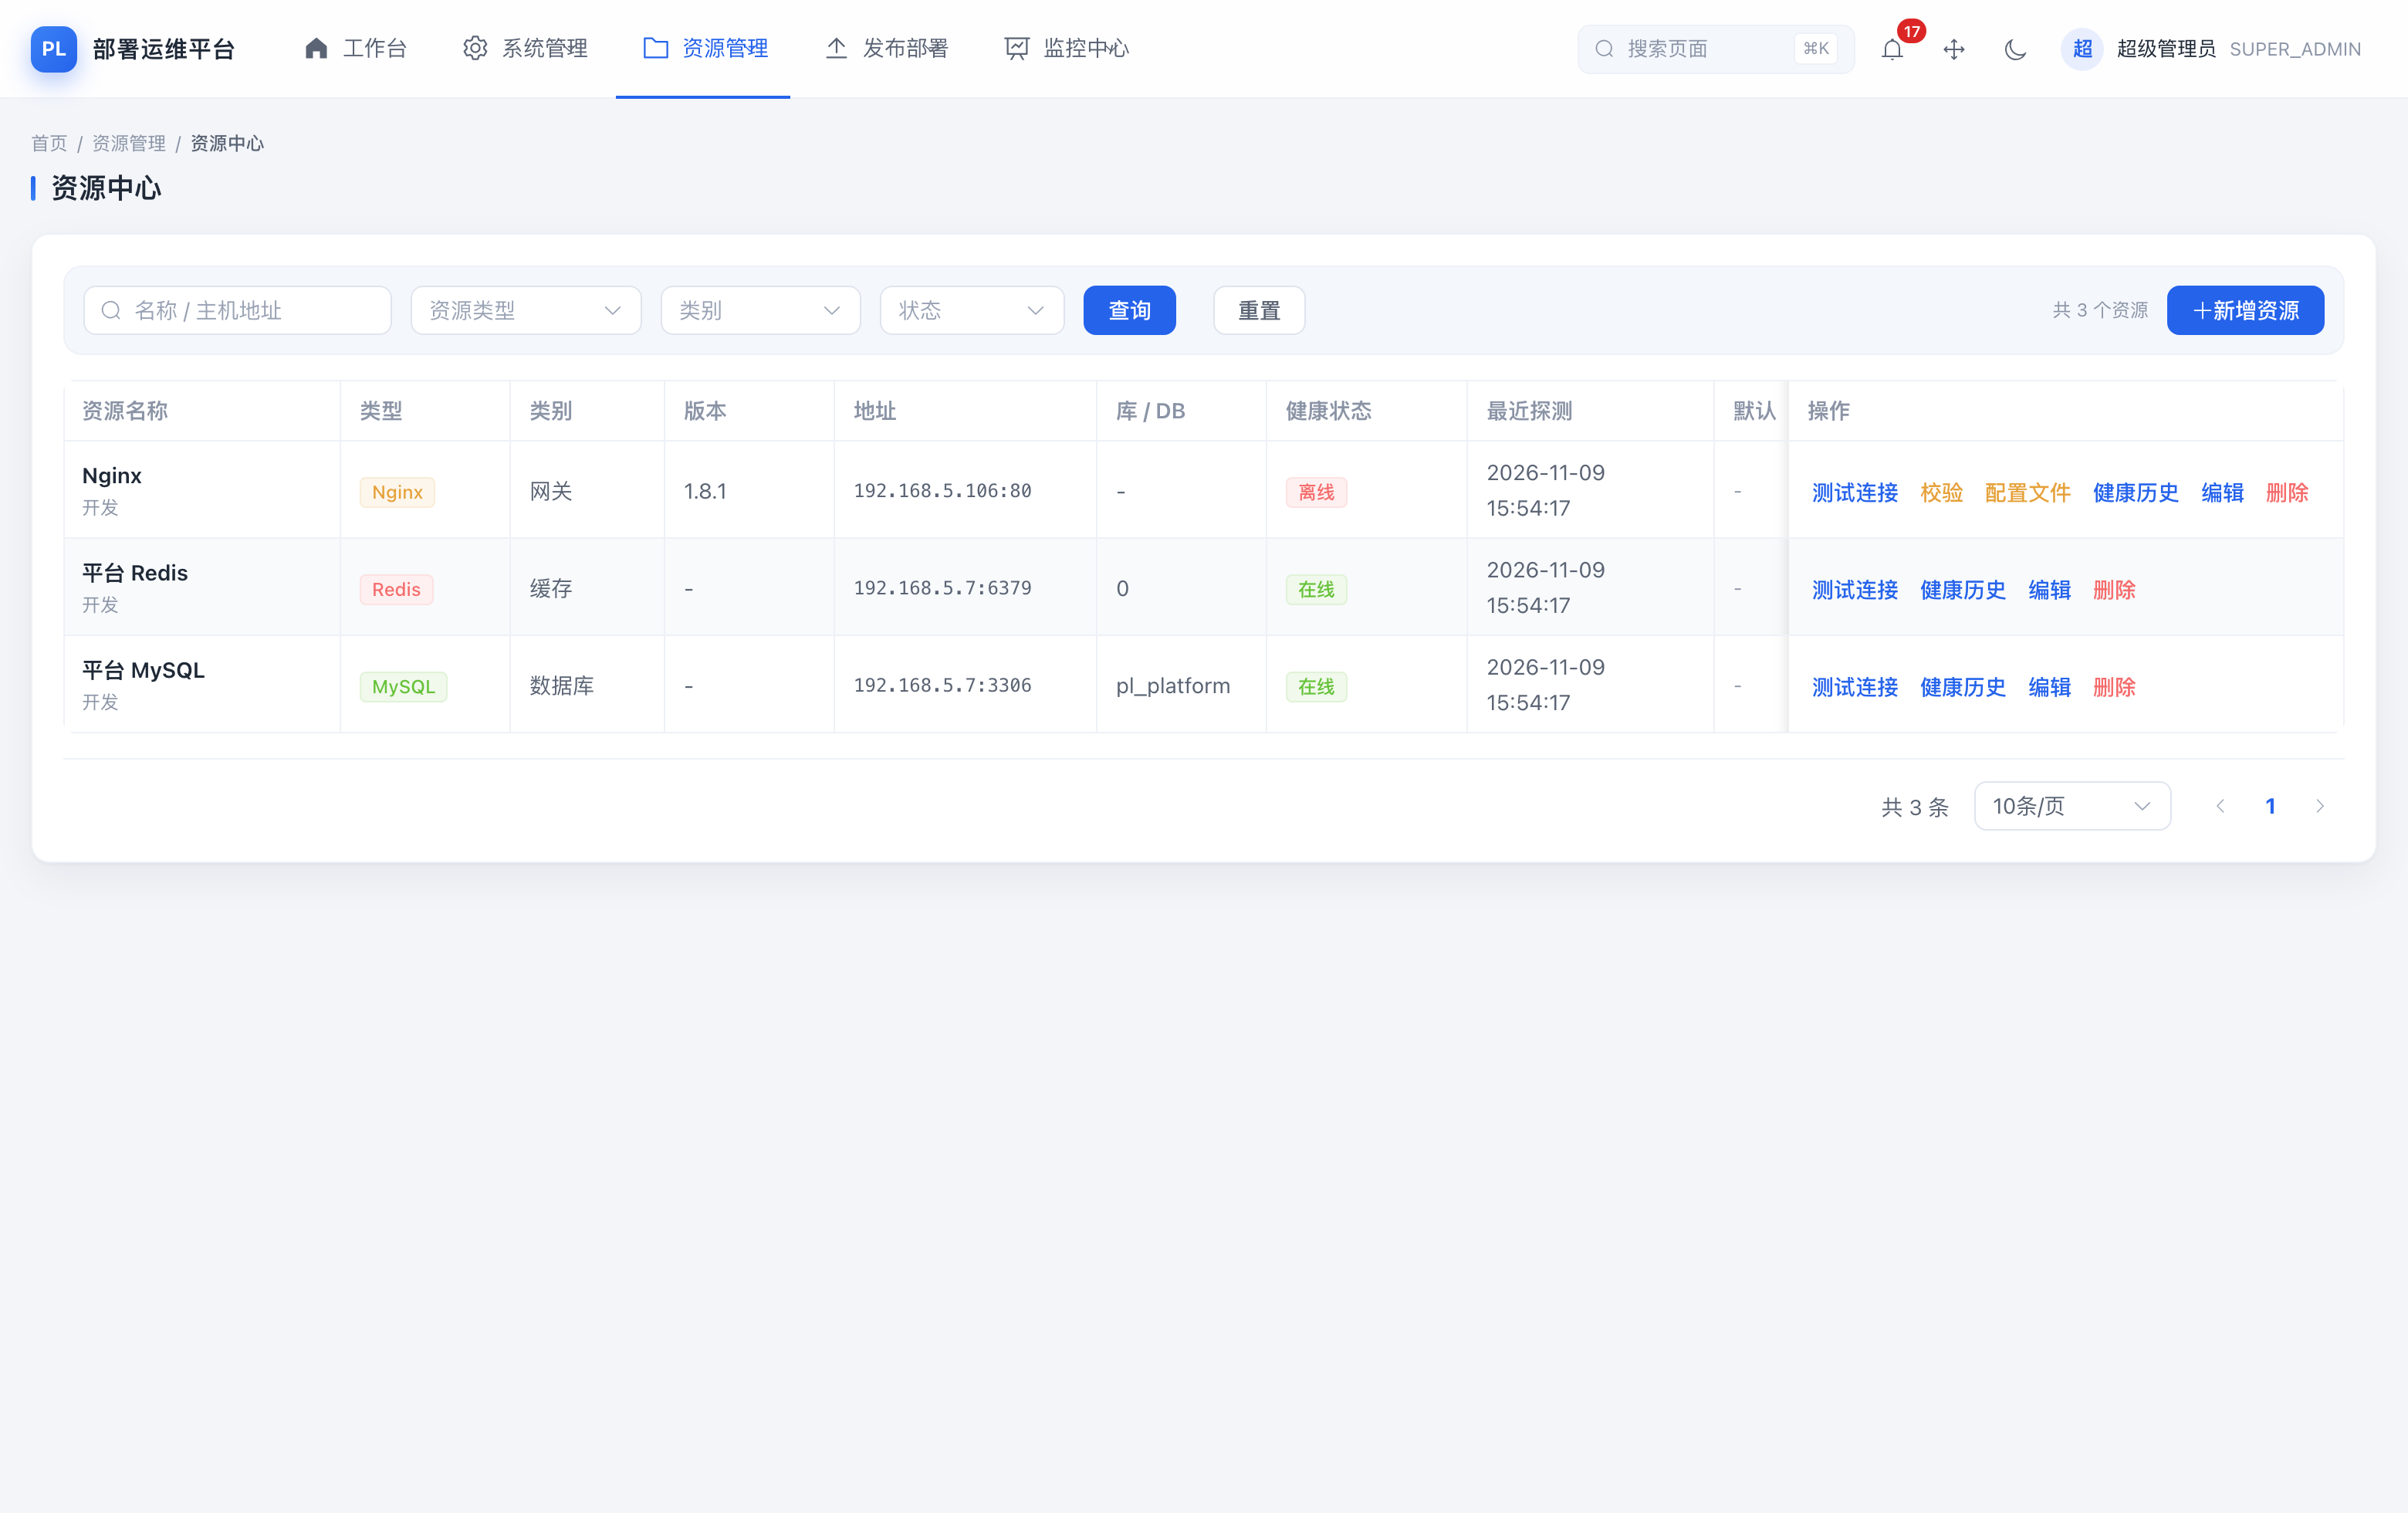
每类资源支持 TCP / HTTP 两种健康检查模式,每次探测落一条历史记录(保留 30 天),页面上有"测试连接 / 校验 / 配置文件 / 健康历史"一排操作。这个设计的意图是:平台只负责"把应用跑起来",不负责安装升级中间件——MySQL、Redis、Nginx 是公司统一维护的外部资源,平台登记它们、探测它们、在发布时把它们交给应用。
2.3 环境配置:变量注入升级为"声明式依赖"
环境与资源的绑定从"关联一下"升级成了依赖声明,每个绑定携带三个语义字段:
required:是否为必需资源——必需资源掉线时发布直接终止;auto_inject:是否自动注入连接变量;variable_mapping:变量名映射,{"HOST": "DB_HOST"}把标准变量{alias}_HOST改名成应用习惯的样子。
按资源类别注入不同的变量组(DATABASE 给 JDBC_URL,CACHE 给 URL,STORAGE 给 ENDPOINT/ACCESS_KEY/SECRET_KEY/BUCKET),发布前可以预览完整变量表,密码脱敏为 ******。应用容器拿到的永远是标准化的环境变量,不感知资源换了哪台机器。
2.4 发布部署:六阶段流水线 + 节点级可视化
发布中心是整个平台的核心。V3 的一次真实发布长这样:
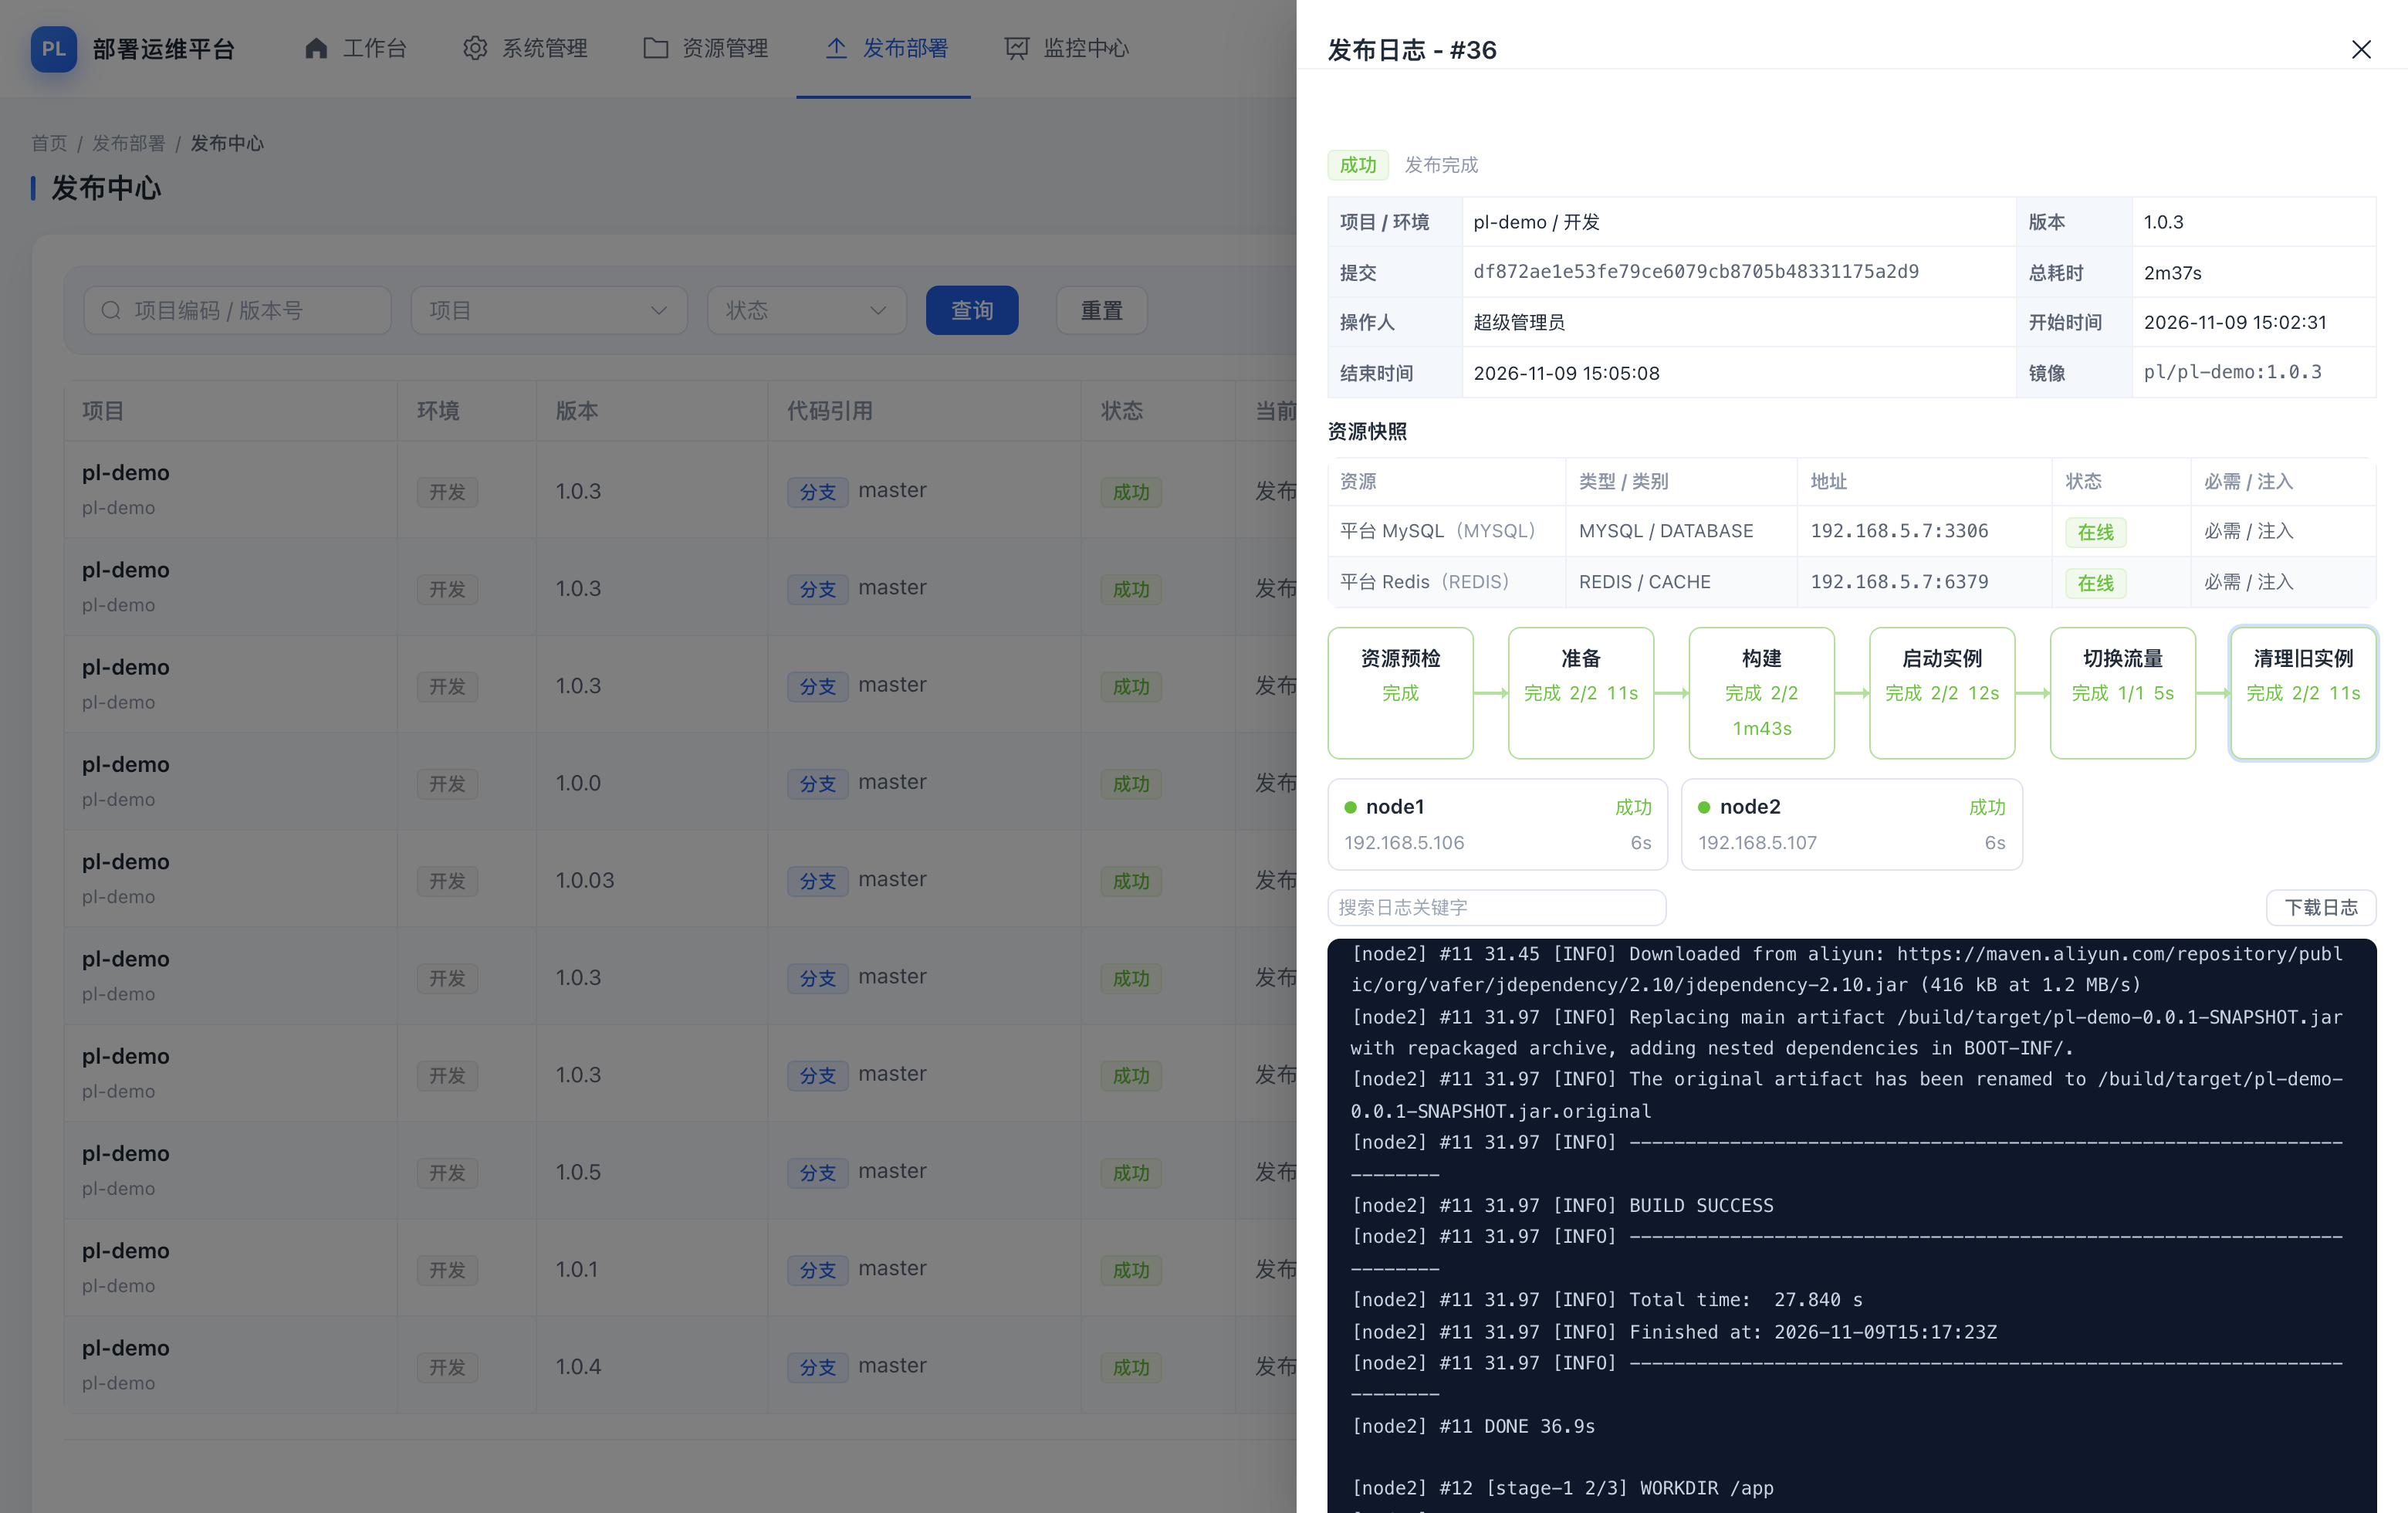
顶部六个阶段卡片:资源预检 → 准备 → 构建 → 启动实例 → 切换流量 → 清理实例,每个阶段按「阶段 × 服务器」展示节点状态和耗时(图中 node1/node2 各 6 秒);中部是这次发布固化的资源快照(MySQL、Redis,在线状态与"必需/注入"标记);下方日志按节点前缀 [node2] 可过滤,WebSocket 实时推送。
发起发布时可以在提交前先跑一次预检:
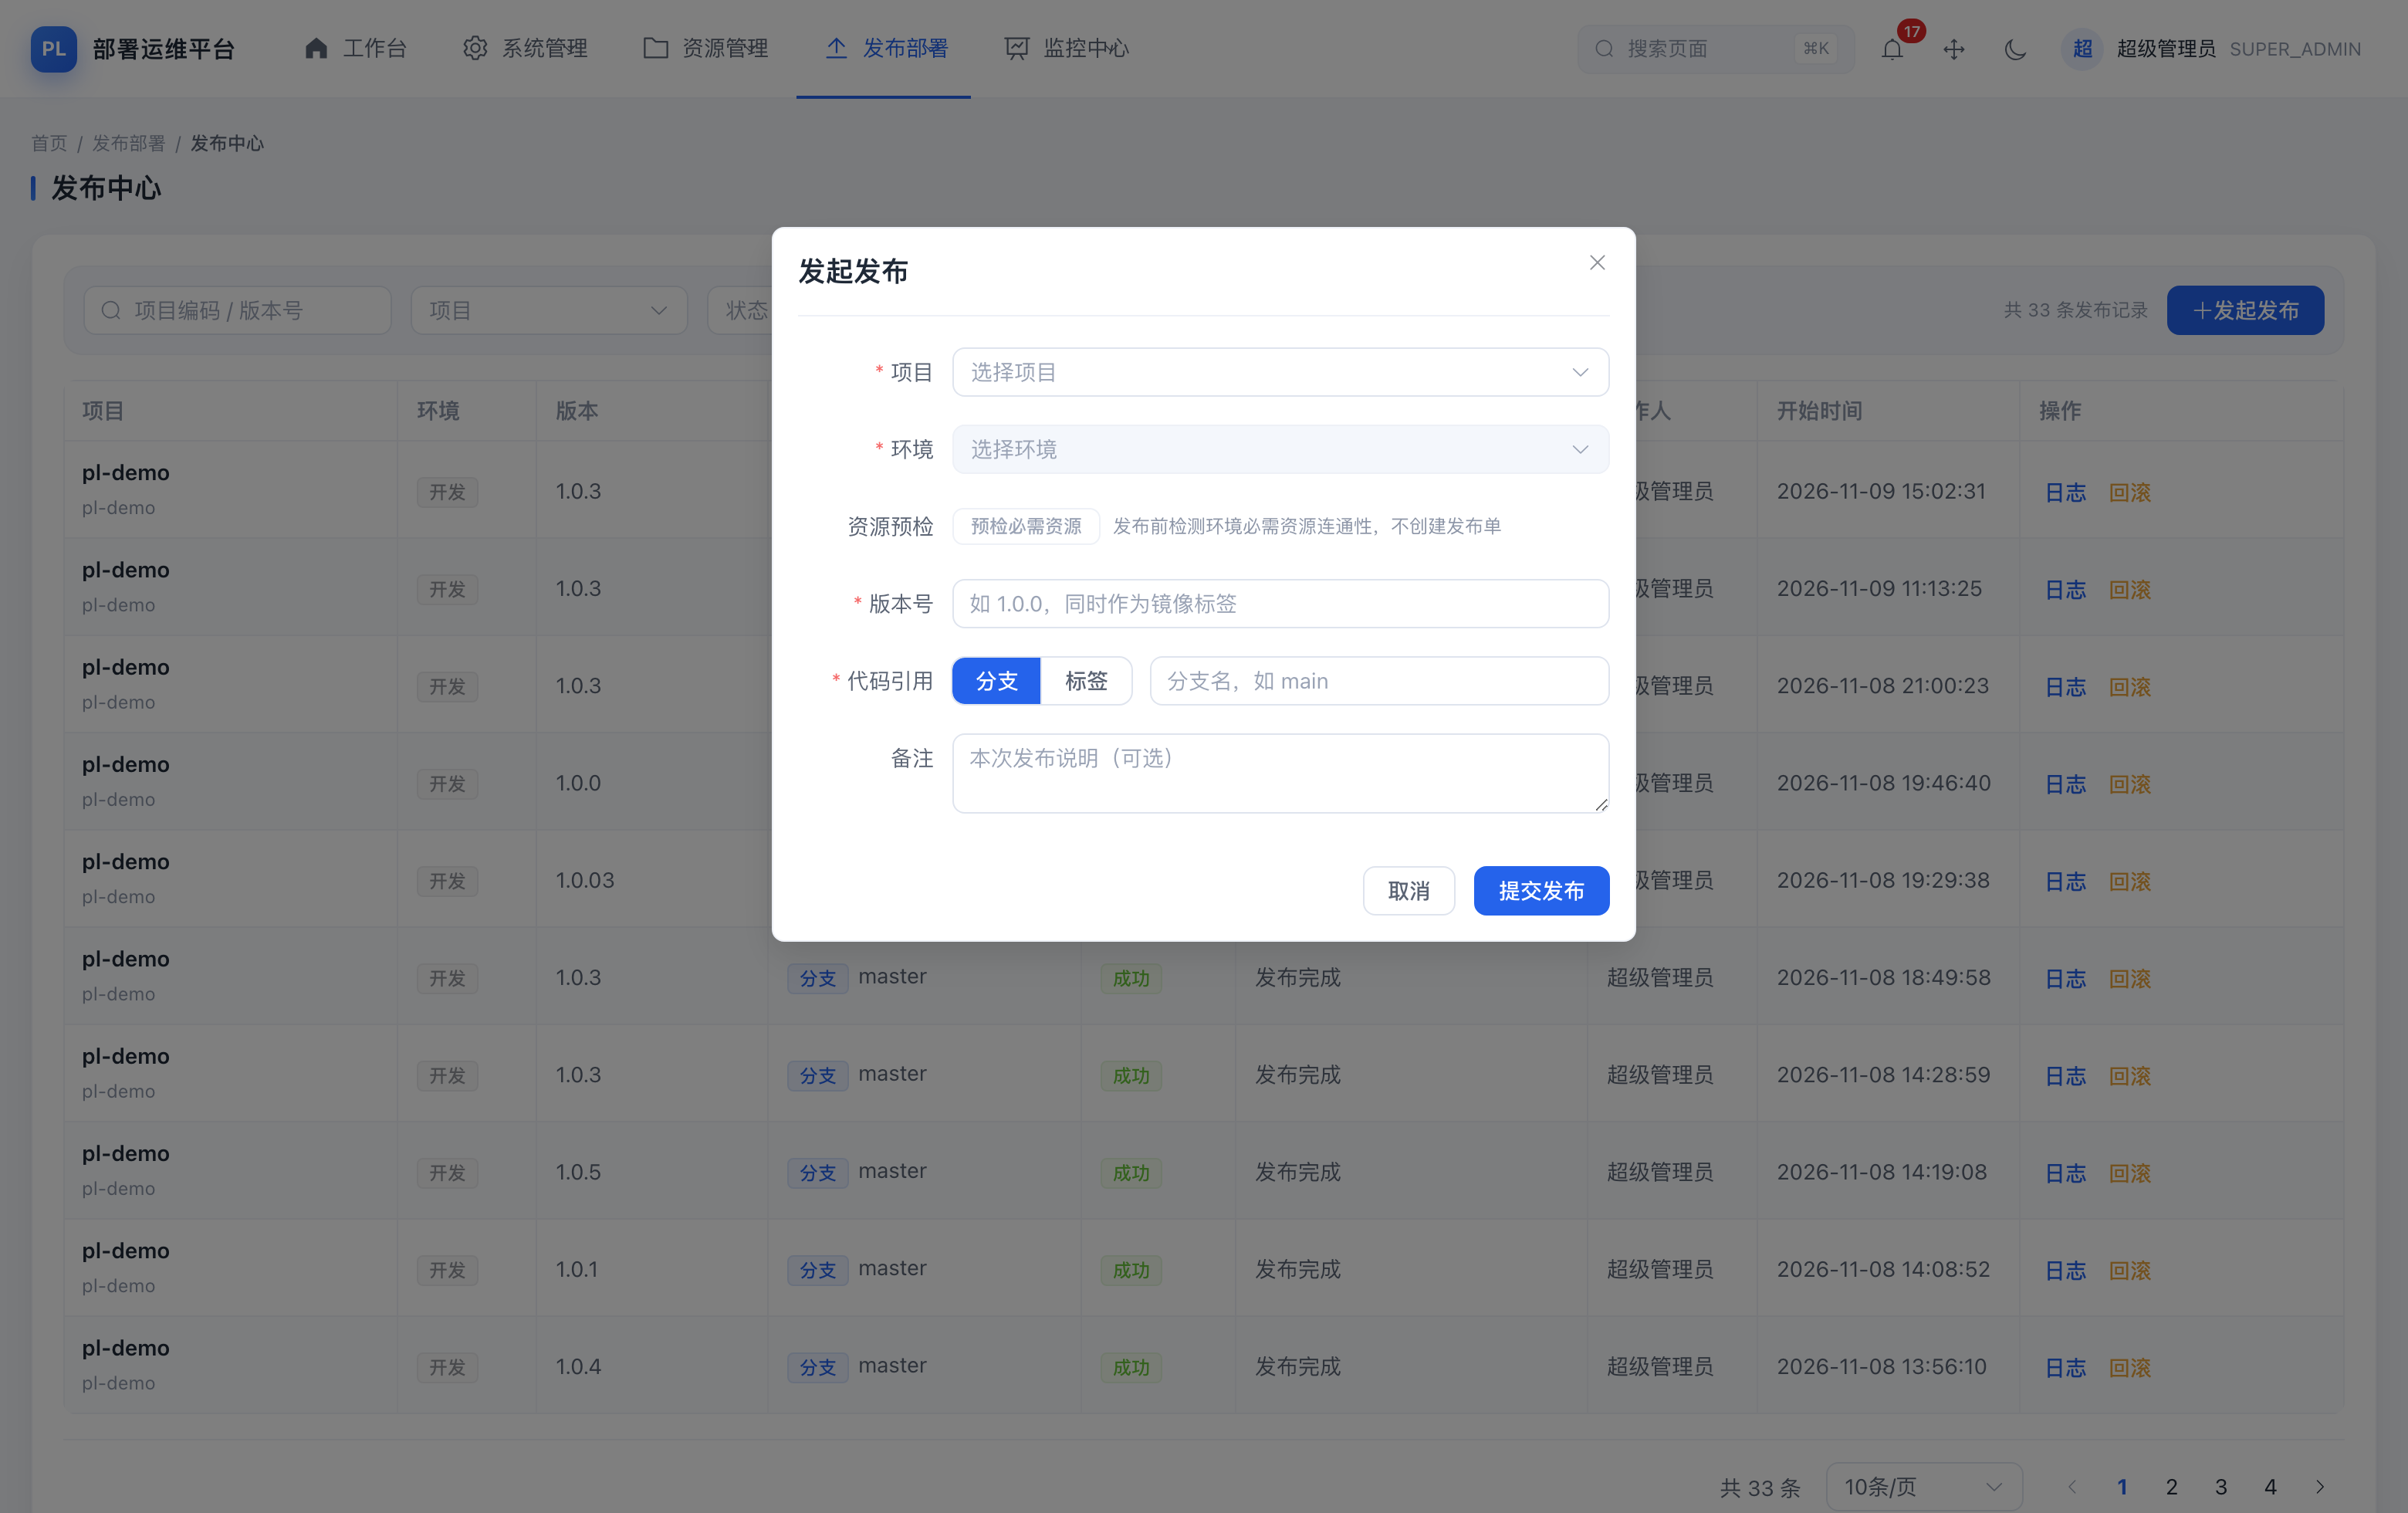
2.5 监控中心:实例、告警、资源健康三个页签
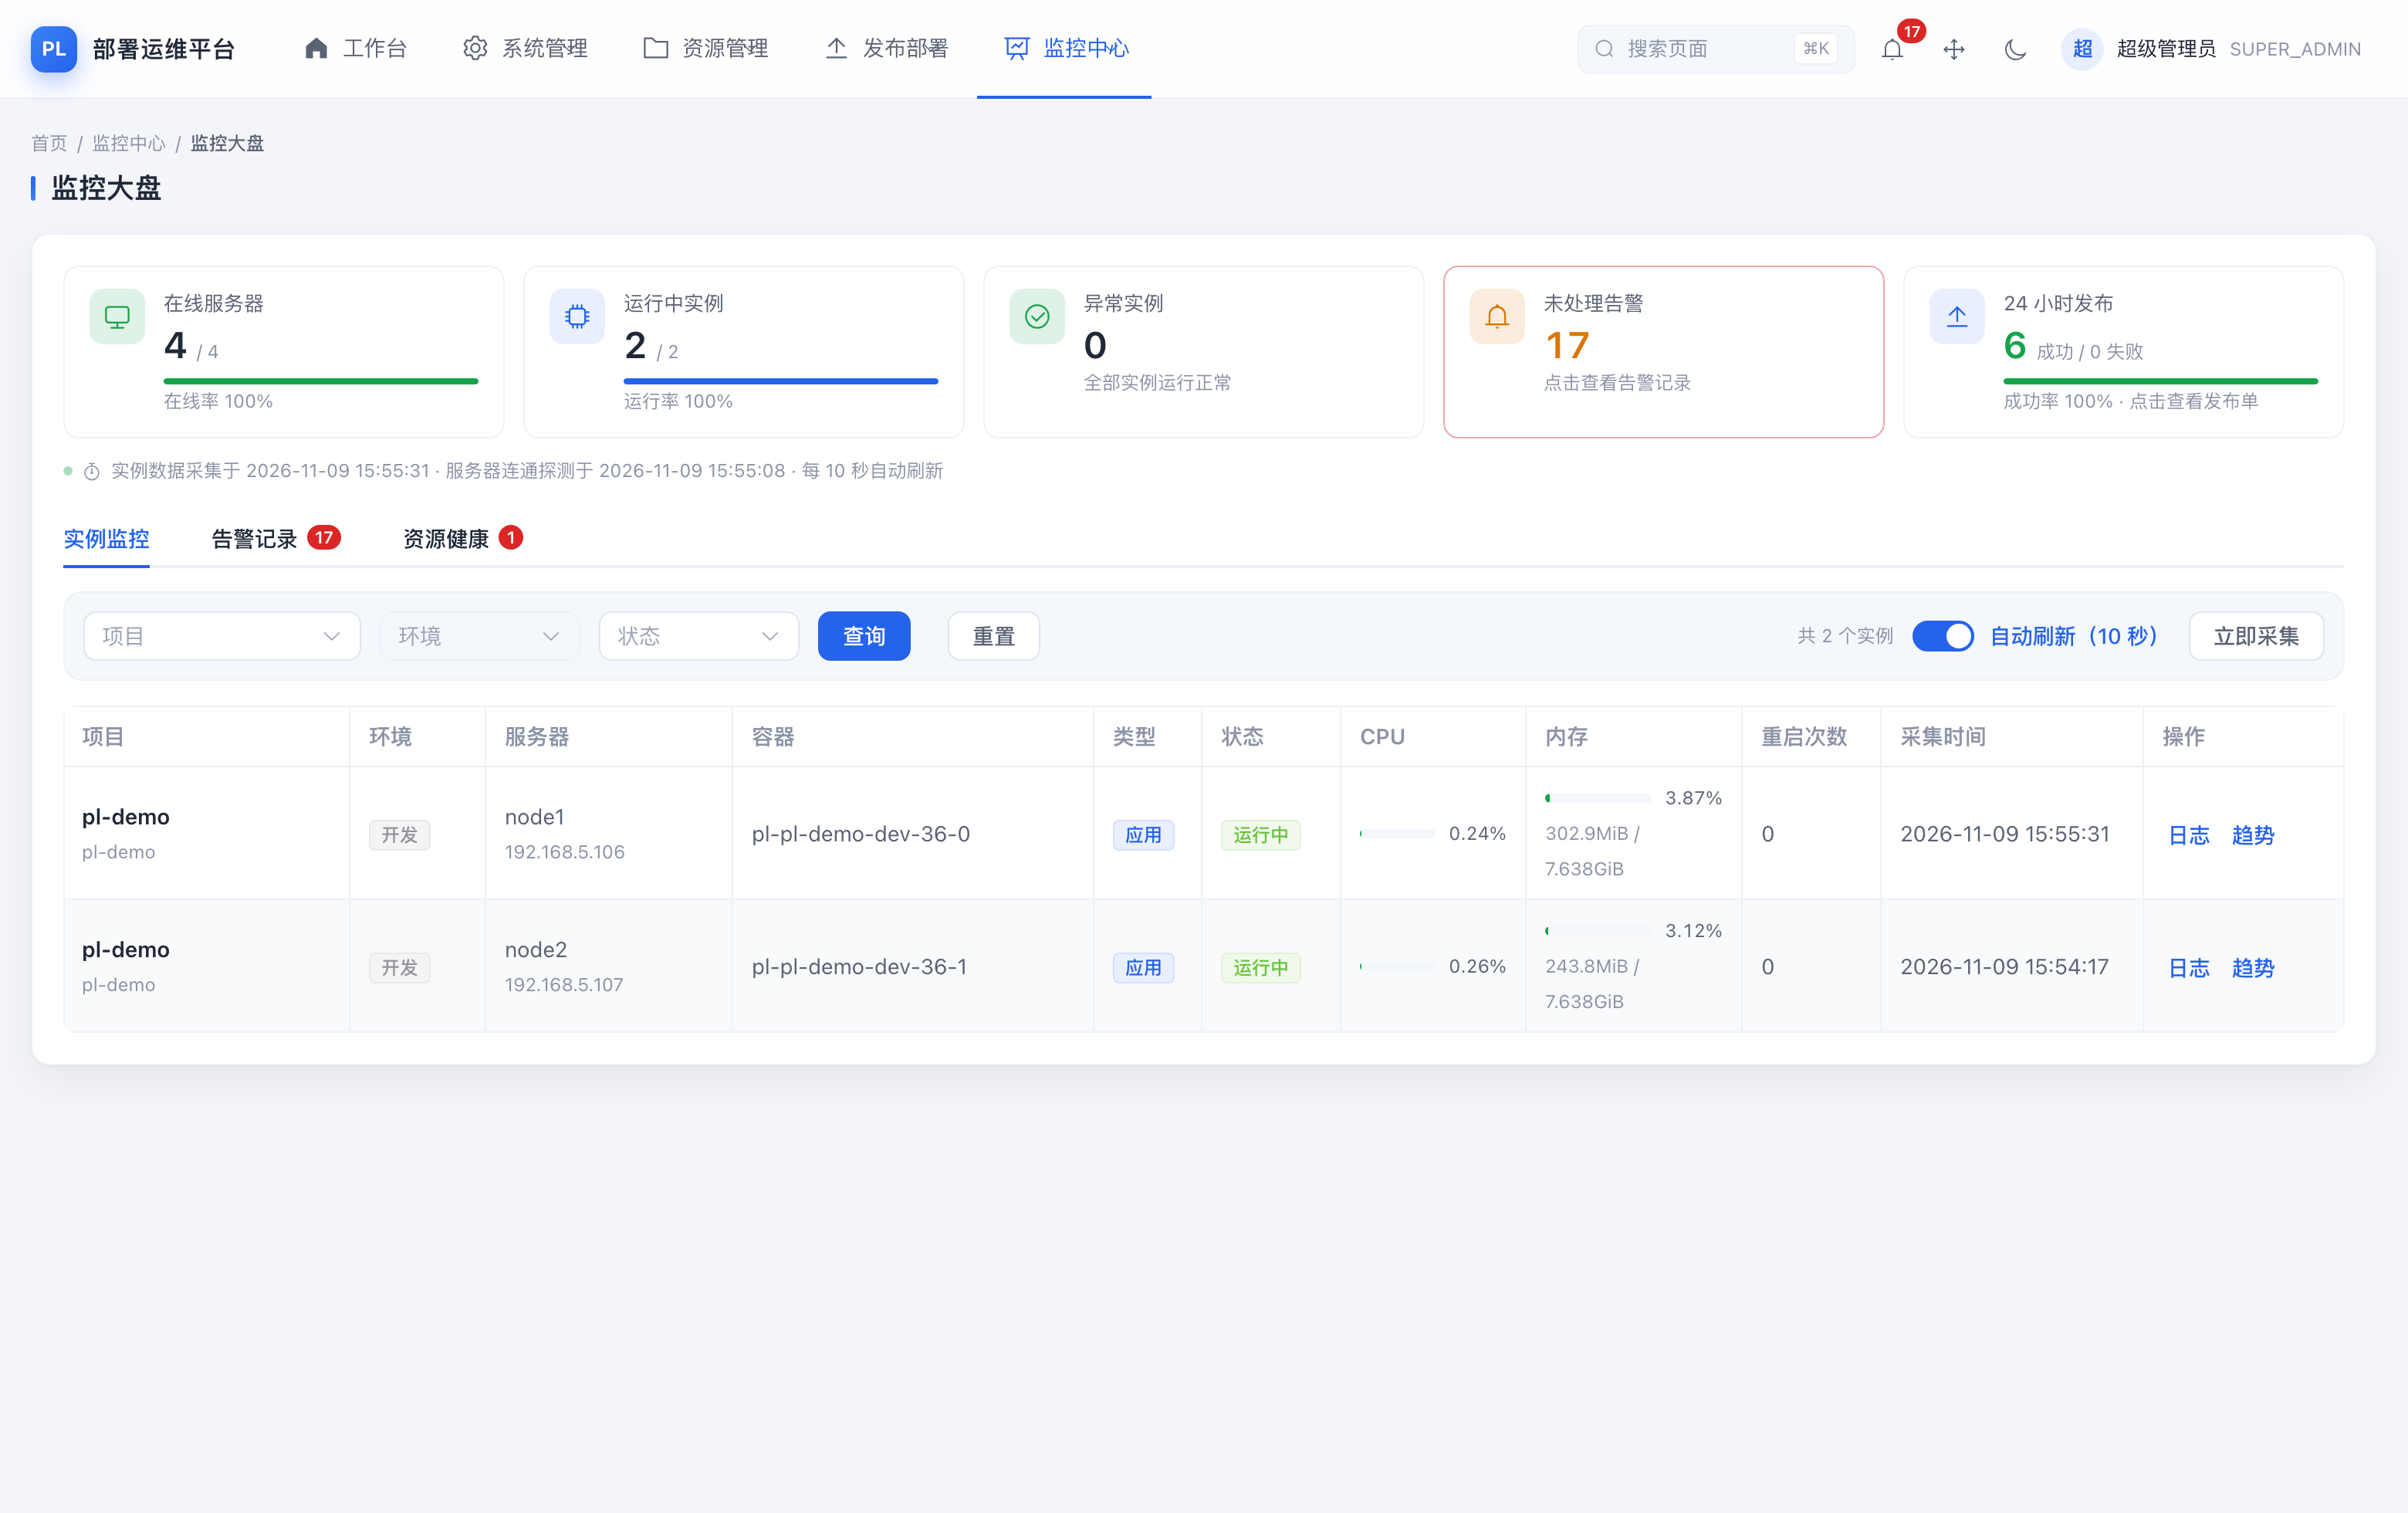
实例监控 30 秒一轮采集(Docker 标签自动发现实例),指标每 5 分钟落一次历史采样;告警记录与资源健康并列成第三个页签——异常资源清单会标注"受影响的环境数",让"MySQL 掉了"变成"3 个环境的发布会被预检拦截"。
三、怎么做:六个核心实现
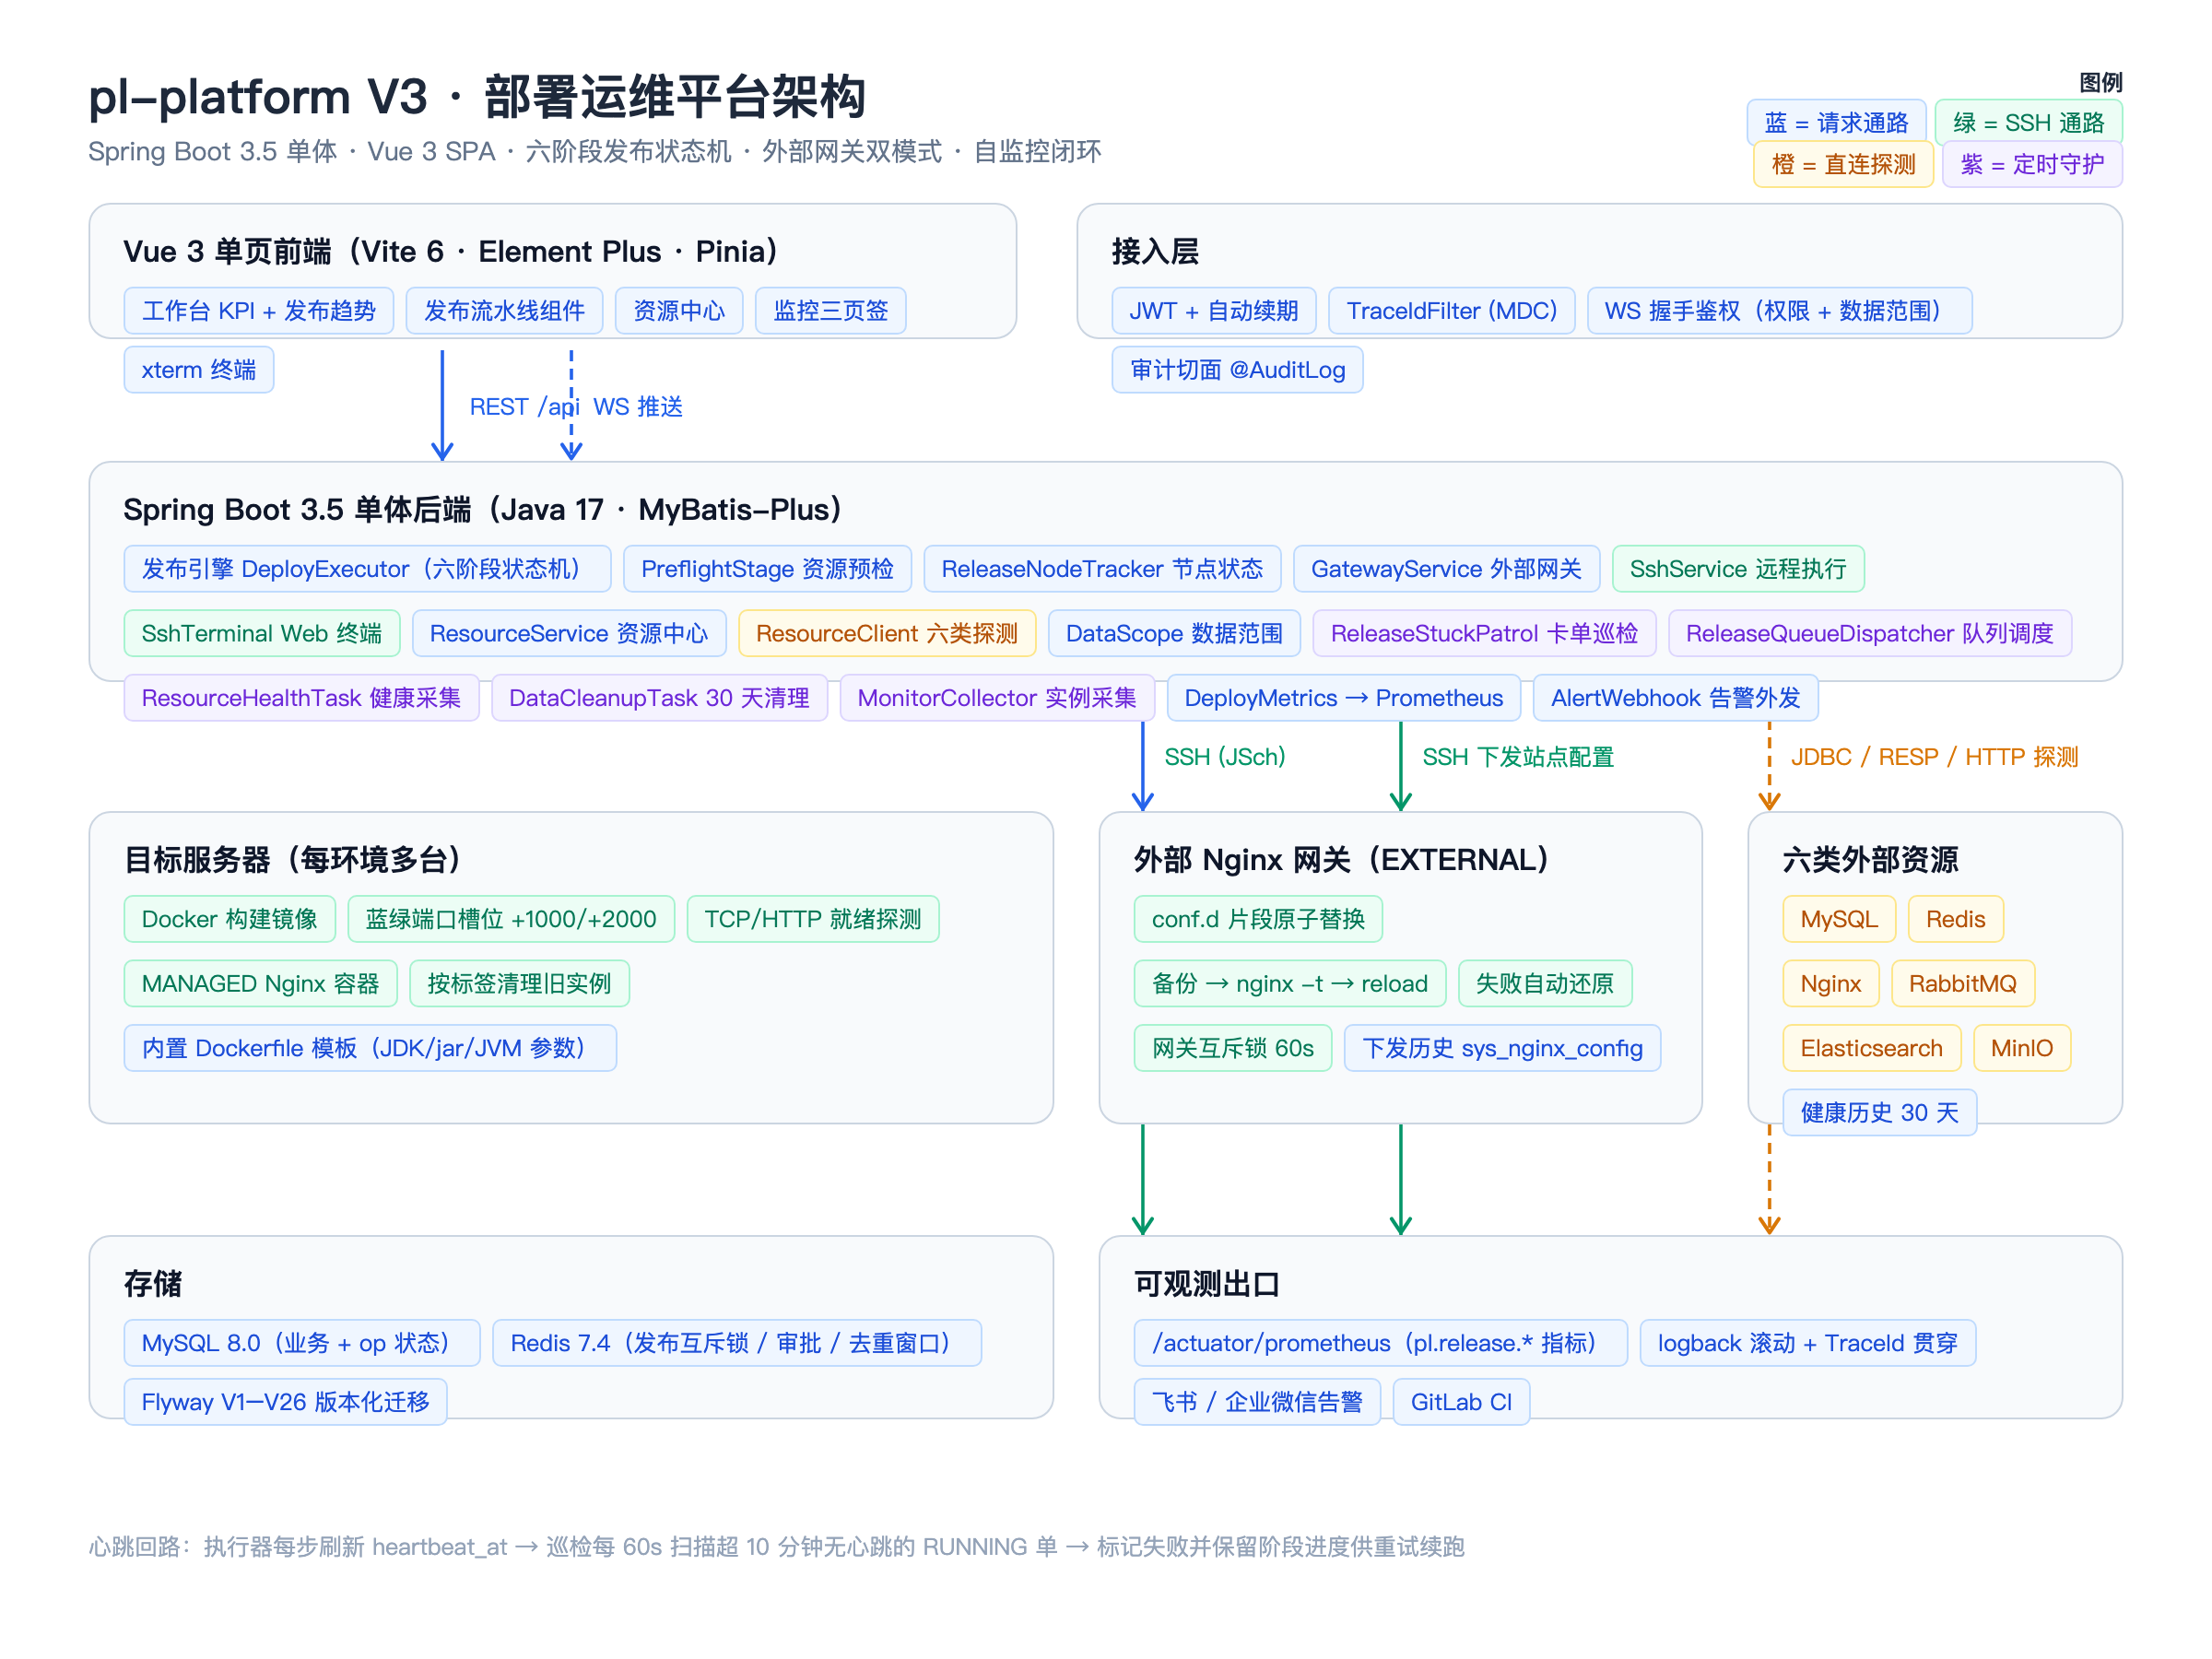
3.1 六阶段状态机:预检成为第一个阶段
public enum DeployStage {
/** 预检环境绑定的必需资源可用性,并写入发布资源快照 */
PREFLIGHT,
/** 校验配置、加载服务器、选择端口槽位、生成实例计划 */
PREPARE,
/** 逐台服务器拉取代码并构建镜像 */
BUILD,
/** 启动新实例并等待端口就绪(旧实例仍在服务) */
START,
/** 切换 Nginx upstream 指向新实例 */
SWITCH_LB,
/** 清理旧实例与旧网关上的负载均衡容器 */
CLEANUP,
/** 全部完成(仅成功终态标记,不作为可执行阶段) */
DONE;
private static final DeployStage[] EXECUTABLE =
{PREFLIGHT, PREPARE, BUILD, START, SWITCH_LB, CLEANUP};
/** 判断「已完成阶段」是否已推进到指定阶段(含) */
public static boolean completedAtLeast(String completed, DeployStage stage) {
return completed != null && valueOf(completed).ordinal() >= stage.ordinal();
}
}sys_release.stage 持久化的是"最后一个已完成的阶段",断点续跑从下一阶段继续。在首位插入 PREFLIGHT 有个隐蔽的兼容问题:存量发布单的 stage 是 PREPARE 及之后,按 ordinal 比较自然视为"已通过预检",不需要任何数据迁移——枚举顺序即业务语义,这是状态机设计里少有的可以"免费"扩展的位置。
整条流水线与背后的守护机制全景如下:
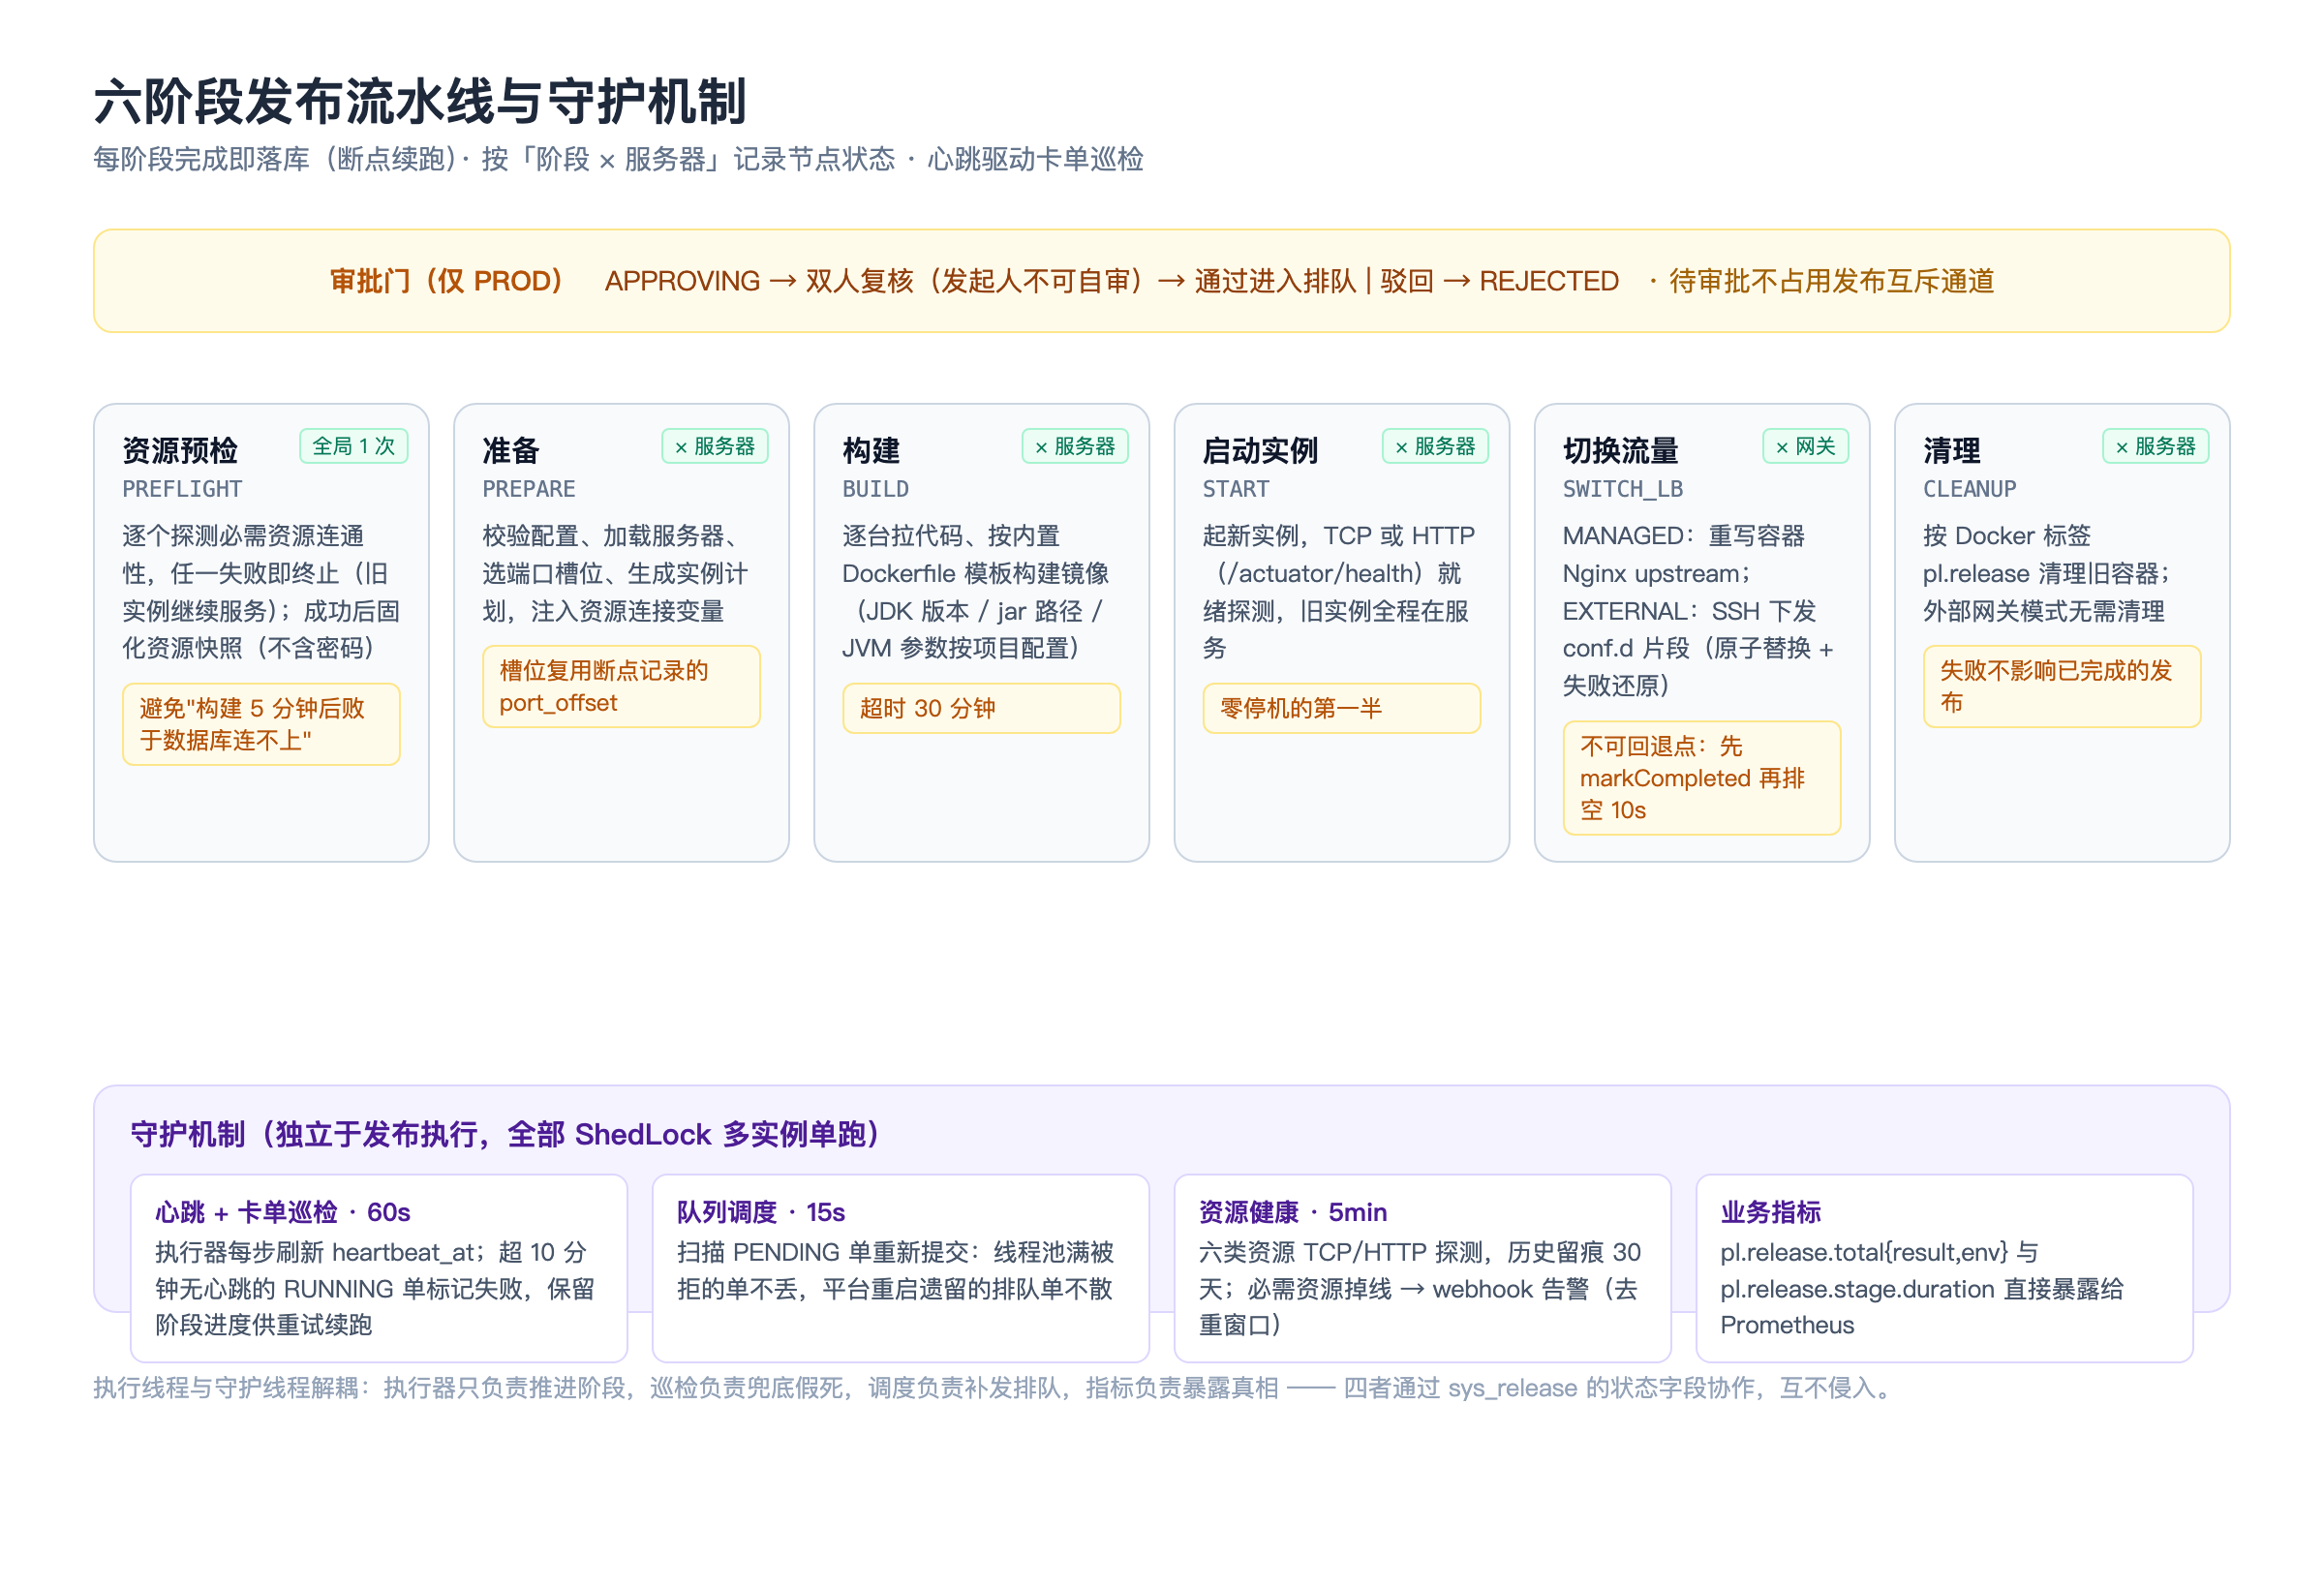
预检阶段的执行逻辑(PreflightStage)值得贴出来,因为"失败前置"的价值全部在里面:
for (EnvResourceVO binding : bindings) {
    boolean checked = binding.required() && binding.autoInject();
    if (checked) {
        ResourceTestResult result = resourceService.test(binding.resourceId());
        if (!result.success()) {
            // 任一必需资源不可用:终止发布,旧实例继续服务
            throw new BusinessException("必需资源 " + name + " 不可用:" + result.message());
        }
    }
    // 无论是否参与预检,都固化进资源快照(不含密码)
    snapshot.add(snapshotEntry(binding, resource, name));
}
release.setResourceSnapshot(objectMapper.writeValueAsString(snapshot));
ctx.persist();两条设计原则:预检失败是"不该发生的失败"提前发生——数据库连不上的发布单,不应该先花 5 分钟构建再失败;资源快照随单固化——半年后复盘这次发布,当时连的是哪个库、端口多少、是否在线,一目了然,而不用去翻当时的资源表。
3.2 心跳 + 卡单巡检:给"永远转圈"的发布单一颗子弹
这是 V3 最重要的一处修复。V2 有个尴尬的死角:发布执行依赖线程池,如果线程被 OOM 打断、或进程被容器编排静默重启(没走到优雅关闭),发布单会永远停在 RUNNING——前端一直转圈,唯一的恢复手段是手改数据库。
V3 的解法分两半。第一半是心跳:执行器每完成一个动作就刷新 heartbeat_at(DeployContext.persist() 与日志落库时顺带写入),一行代码的成本,换来"这张单还活着"的证据。第二半是巡检:
/** 心跳超时阈值:超过该时间无心跳视为发布线程已终止 */
private static final long HEARTBEAT_TIMEOUT_MINUTES = 10L;
@Scheduled(fixedDelay = 60_000L, initialDelay = 60_000L)
@SchedulerLock(name = "releaseStuckPatrol", lockAtMostFor = "2m", lockAtLeastFor = "30s")
public void patrol() {
LocalDateTime deadline = LocalDateTime.now().minusMinutes(HEARTBEAT_TIMEOUT_MINUTES);
List<SysRelease> stuck = releaseMapper.selectList(new LambdaQueryWrapper<SysRelease>()
.eq(SysRelease::getStatus, "RUNNING")
.and(w -> w.lt(SysRelease::getHeartbeatAt, deadline)
.or(q -> q.isNull(SysRelease::getHeartbeatAt)
.lt(SysRelease::getStartedAt, deadline))));
for (SysRelease release : stuck) {
releaseMapper.update(null, new LambdaUpdateWrapper<SysRelease>()
.eq(SysRelease::getId, release.getId())
// 并发保护:仅当仍处于 RUNNING 时才终止,避免覆盖刚被恢复/完成的状态
.eq(SysRelease::getStatus, "RUNNING")
.set(SysRelease::getStatus, "FAILED")
.set(SysRelease::getCurrentStep, "执行中断(进程重启或线程异常终止),恢复窗口已过")
.set(SysRelease::getFinishedAt, LocalDateTime.now()));
}
}三个细节值得说:
UPDATE 带
status='RUNNING'条件——巡检是异步的,标记失败的瞬间发布单可能刚好完成或被恢复,条件更新保证不会覆盖终态。这是"定时任务 + 业务状态"组合里最容易漏的并发保护。标记 FAILED 而不是自动续跑——假死的发布单处于未知状态(远端容器可能起了一半),自动续跑的风险大于收益;但阶段进度还在,用户点重试就从断点继续。把"要不要继续"的决定权还给人。
heartbeat_at为空的兜底——存量单没有心跳字段值,用started_at兜底比较,保证老数据也能被巡检覆盖。
启动时的恢复逻辑(@EventListener(ApplicationReadyEvent) 扫 RUNNING 单续跑)与巡检互补:重启窗口内的卡单由恢复接管,窗口外的由巡检终结。两个机制的阈值衔接,就是"恢复窗口"的实际含义。
3.3 队列调度器:被拒绝 ≠ 失败
V2 里线程池满时提交任务会抛异常,用户看到"发布失败"——但那张单从来没有跑过,说"失败"是撒谎。V3 把语义拆正了:
@Scheduled(fixedDelay = 15_000L, initialDelay = 15_000L)
@SchedulerLock(name = "releaseQueueDispatcher", lockAtMostFor = "1m", lockAtLeastFor = "5s")
public void dispatch() {
    Page<SysRelease> page = releaseMapper.selectPage(new Page<>(1, BATCH_SIZE),
            new LambdaQueryWrapper<SysRelease>()
                    .eq(SysRelease::getStatus, "PENDING")
                    .orderByAsc(SysRelease::getId));
    for (SysRelease release : page.getRecords()) {
        deployService.submit(release.getId());
    }
}
每 15 秒扫一遍 PENDING 单重新提交。线程池满载被拒的单保持排队等下一轮;平台重启前遗留的排队单也由这里收编。重复提交的风险由既有的 Redis SETNX 在途标记兜住。"排队"是一种可持续的状态,"失败"才需要人来处理——这两个状态分开之后,用户对系统的信任感完全不同。
3.4 外部 Nginx 网关:平台不垄断流量入口
V2 的负载均衡是平台自管的 Nginx 容器(MANAGED)。现实是多数公司有统一的外部 Nginx,运维团队不会把流量入口交给你。V3 引入 EXTERNAL 模式:环境绑定一个 NGINX 类型的资源,平台通过 SSH 把 conf.d 站点片段下发给外部网关。
下发脚本是这段逻辑的核心,直接贴全文(DeployScripts.externalLbScript):
set -e
mkdir -p '<siteDir>' '<backupDir>'
TARGET='<siteDir>/pl-demo-dev.conf'
BACKUP=""
if [ -f "$TARGET" ]; then BACKUP='<backupDir>/pl-demo-dev.conf.'"$(date +%Y%m%d%H%M%S)"'; cp "$TARGET" "$BACKUP"; fi
restore() { if [ -n "$BACKUP" ] && [ -f "$BACKUP" ]; then cp -f "$BACKUP" "$TARGET"; else rm -f "$TARGET"; fi; }
printf '%s' '<configBase64>' | base64 -d > "$TARGET.tmp"
mv "$TARGET.tmp" "$TARGET"
if ! nginx -t; then restore; exit 1; fi
if ! nginx -s reload; then restore; nginx -s reload || true; exit 1; fi
五个动作构成一条完整的安全链:
先备份已有配置(带时间戳);
写临时文件再
mv——mv在同一文件系统内是原子的,nginx 永远读不到半个文件;nginx -t失败即还原——配置语法错误不会影响线上;reload 失败也还原,并尽力把旧配置 reload 回来;
只写平台自有的
pl-*.conf,不触碰他人文件;同时获取网关级互斥锁(Redis SETNX,60s TTL),两个环境同时下发不会互相踩踏。
每次下发写一条 sys_nginx_config 历史(配置内容、SHA-256 checksum、备份路径、操作人),页面上可以回看任意一次下发。对外部系统的写操作,可回滚 + 可审计是底线。
3.5 节点状态机:把"阶段 × 服务器"二维展开
V2 的阶段进度是线性的(走到第几阶段),但真实发布是二维的:BUILD 阶段 node1 成功、node2 失败,线性进度表达不了。V3 用 ReleaseNodeTracker 按「阶段 × 服务器」追踪,每次变更以 JSON 快照持久化到发布单并推送前端:
public void success(String stage, SysServer server) {
    NodeState state = nodes.get(key(stage, server));
    if (state == null) { start(stage, server); state = nodes.get(key(stage, server)); }
    state.status = SUCCESS;
    state.durationMs = elapsed(state);
    put(state);   // 触发持久化 + WebSocket 推送
}
前端 ReleasePipeline 组件直接消费这份 JSON:阶段卡片显示 2/2 完成进度,点击任一阶段过滤出该阶段的节点,日志行用 [node2] 前缀联动选中节点。断线重连后从 HTTP 拉一次快照即可恢复完整流水线图,不需要回放任何日志。
3.6 可观测性与安全:把上次欠的账一次还清
这组改动单看每条都不大,合起来是"平台自己可被运维"的分水岭:
业务指标——不再只有 JVM 指标,发布成功率与阶段耗时直接进 Prometheus:
/** 发布单终态:result = SUCCESS / FAILED */
public void recordTerminal(String result, String env) {
counters.computeIfAbsent(result + "|" + env,
k -> Counter.builder("pl.release.total")
.tags("result", result, "env", env)
.register(registry))
.increment();
}
/** 阶段耗时:P95 由 Prometheus 聚合,不需要自己存 */
public void recordStage(String stage, String result, long elapsedMs) {
timers.computeIfAbsent(stage + "|" + result,
k -> Timer.builder("pl.release.stage.duration")
.tags(stage, result).register(registry))
.record(Duration.ofMillis(elapsedMs));
}密钥轮换——V2 的 AES 密钥由 JWT secret 派生,两者复用意味着 secret 泄露即全部 SSH 凭据失守,且轮换 JWT secret 会让所有已存凭据解不开。V3 独立出 pl.crypto.keys 并支持 keyId 版本化:新密文带 keyId 前缀,按 id 选钥解密;无前缀的存量密文回退旧钥,轮换不再破坏历史数据。
其他:logback-spring.xml 滚动日志 + TraceIdFilter(MDC 贯穿一次发布的全部日志行);整单执行 45 分钟强制终止,防止单张卡单长期占用执行线程;/actuator/** 放行给内网监控抓取;DataCleanupTask 统一清理 30 天前的资源健康历史。
四、结果如何:当前真实运行数据
以下数据来自平台此刻的真实状态,非演示数据:
一次双节点发布的阶段耗时分布(来自发布 #36 的流水线图):预检 <1s、准备 11s、构建 64s、启动 12s、切换流量 8s、清理 11s。构建占据 60% 以上耗时——这也印证了下一步应该做镜像仓库(构建一次、处处分发),而不是继续优化其他阶段。
验证方法与 V2 一致:mvn test 走端口槽位、状态机、脚本生成的单元测试;前端 npm run build 过 CI;发布链路用配套演示项目 pl-demo 做真实双节点验证——包括人为制造"必需资源掉线"场景,确认预检在构建开始前就终止发布、旧实例全程未受影响。
五、局限与下一步
诚实列出还没做的:
构建仍然逐台执行。N 台机器构建 N 次,慢且存在各节点产物不一致的理论风险。引入镜像仓库(Harbor 或 registry:2)后"构建一次、处处 pull",回滚也更纯粹。这是下一步的性价比之王——上面 64 秒的构建耗时是最直接的动机。
告警阈值仍不可配。CPU / 内存的告警线硬编码在后端,不同业务规格的机器应该有不同的阈值,应随资源登记一起配置。
慢 SQL 诊断还没有接入 AI。performance_schema 的数据已经齐了,接一层 LLM 做根因解释("这个查询缺索引,预估扫描 40 万行")是把数据变成洞察的最后一步。
集成测试仍缺位。单元测试覆盖了脚本生成与状态机,但"SSH 打真容器 + nginx reload 真生效"的端到端验证仍靠手工。Testcontainers 起一个 nginx 靶机做冒烟测试,是发布引擎的最后一道护栏。
回头看,V1 回答了"能不能做",V2 回答了"怎么做对",V3 回答的是"坏了怎么办"。预检把可预知的失败提前,心跳巡检把不可预知的假死兜底,队列调度把暂时的拒绝留住,指标把一切变成数字。一个平台的可信度,就是在这些"出事之后"的路径上一层层垒起来的。
运维平台的价值不在于平时跑得多顺,而在于出事的那一分钟里,它是帮你定位问题,还是成为你需要排查的第二个问题。

