这是一套自研运维平台的第二次大版本演进:发布引擎从 558 行巨石类拆成五阶段状态机并支持断点续跑,新增 PROD 审批流、发布日志 WebSocket 推送、资源中心(MySQL/Redis 纳管与慢 SQL 诊断)、监控历史采样与告警外发,并补齐单元测试与 GitLab CI。本文按"是什么、做什么、怎么做、结果如何"展开,含架构图、核心代码与真实运行数据。
摘要
这套平台(pl-platform)我在去年写过第一版:Spring Boot 3 + Vue 3,通过 SSH 操控 Docker,把蓝绿发布做到了实测零停机。但它有两个我一直心里有数的问题——发布引擎是一个 558 行的巨石类,以及整个项目零测试。
这次迭代(V2)把这两块硬骨头啃了,同时补上了第一版欠的账。先看演进对照:
下文按「是什么 → 做什么 → 怎么做 → 结果如何」展开。
一、这是什么
1.1 一句话定义
一个通过 SSH 操控 Docker 的轻量级发布与运维平台:服务器与数据库资源纳管、多环境发布(蓝绿零停机 + 审批 + 断点续跑)、实例与中间件监控、RBAC 与审计。目标场景是不想上 K8s、又受够了手工发版的 1~10 台服务器规模的小团队。
1.2 技术栈
1.3 规模与边界
后端 156 个 Java 文件(11 个 Controller、20 个 Service 实现、7 个流水线 Stage 类),前端 36 个源文件;
数据库结构经 18 个 Flyway 脚本演进,V11–V18 是本次迭代新增;
刻意不做的三件事不变:不做容器编排(Nginx upstream 足够)、不做 CI 全家桶(只做最后一公里)、不做多租户(RBAC + 数据范围覆盖隔离)。
二、它做什么:六个能力域
2.1 工作台与资源纳管
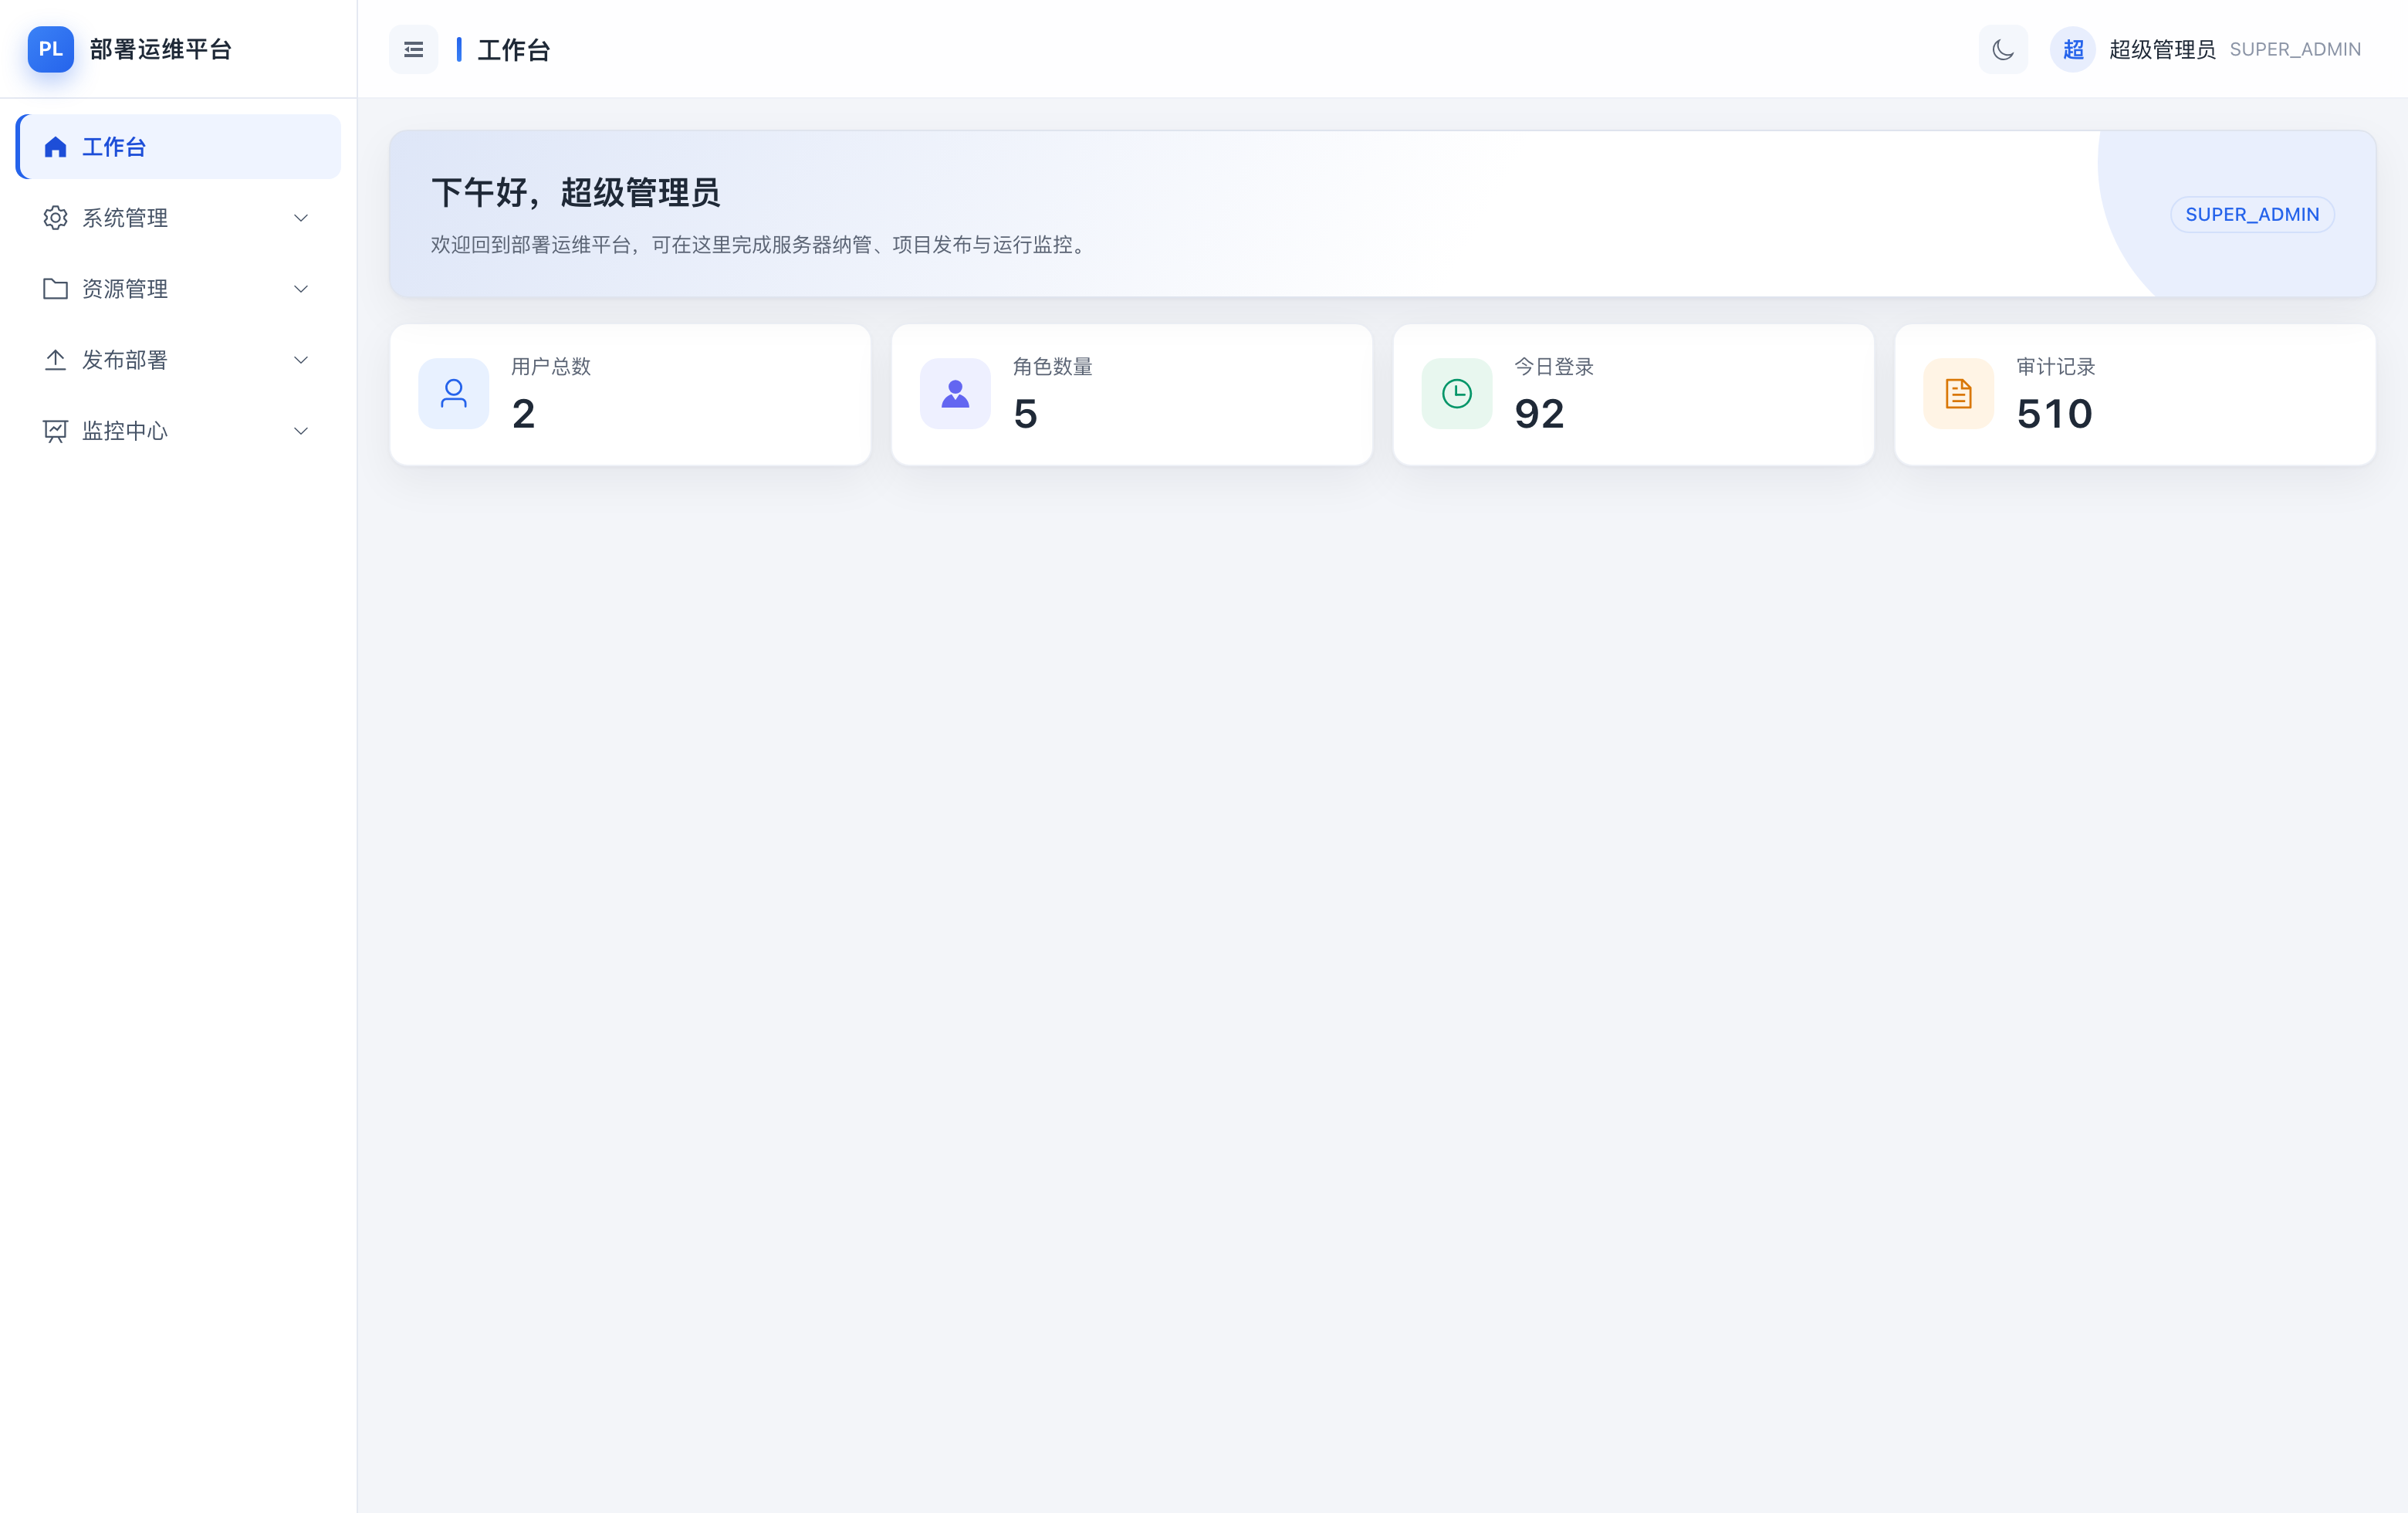
工作台汇总运行指标;服务器管理与 V1 一致(登记、连通性测试、Web 终端、凭据不回显)。
2.2 资源中心(新增)
MySQL / Redis 等外部中间件作为可复用资源统一登记:名称、类型、地址、账号、环境标签,密码走 AES-GCM 加密存储。每轮采集刷新健康状态,页面直接显示"在线/离线"与最近探测时间。
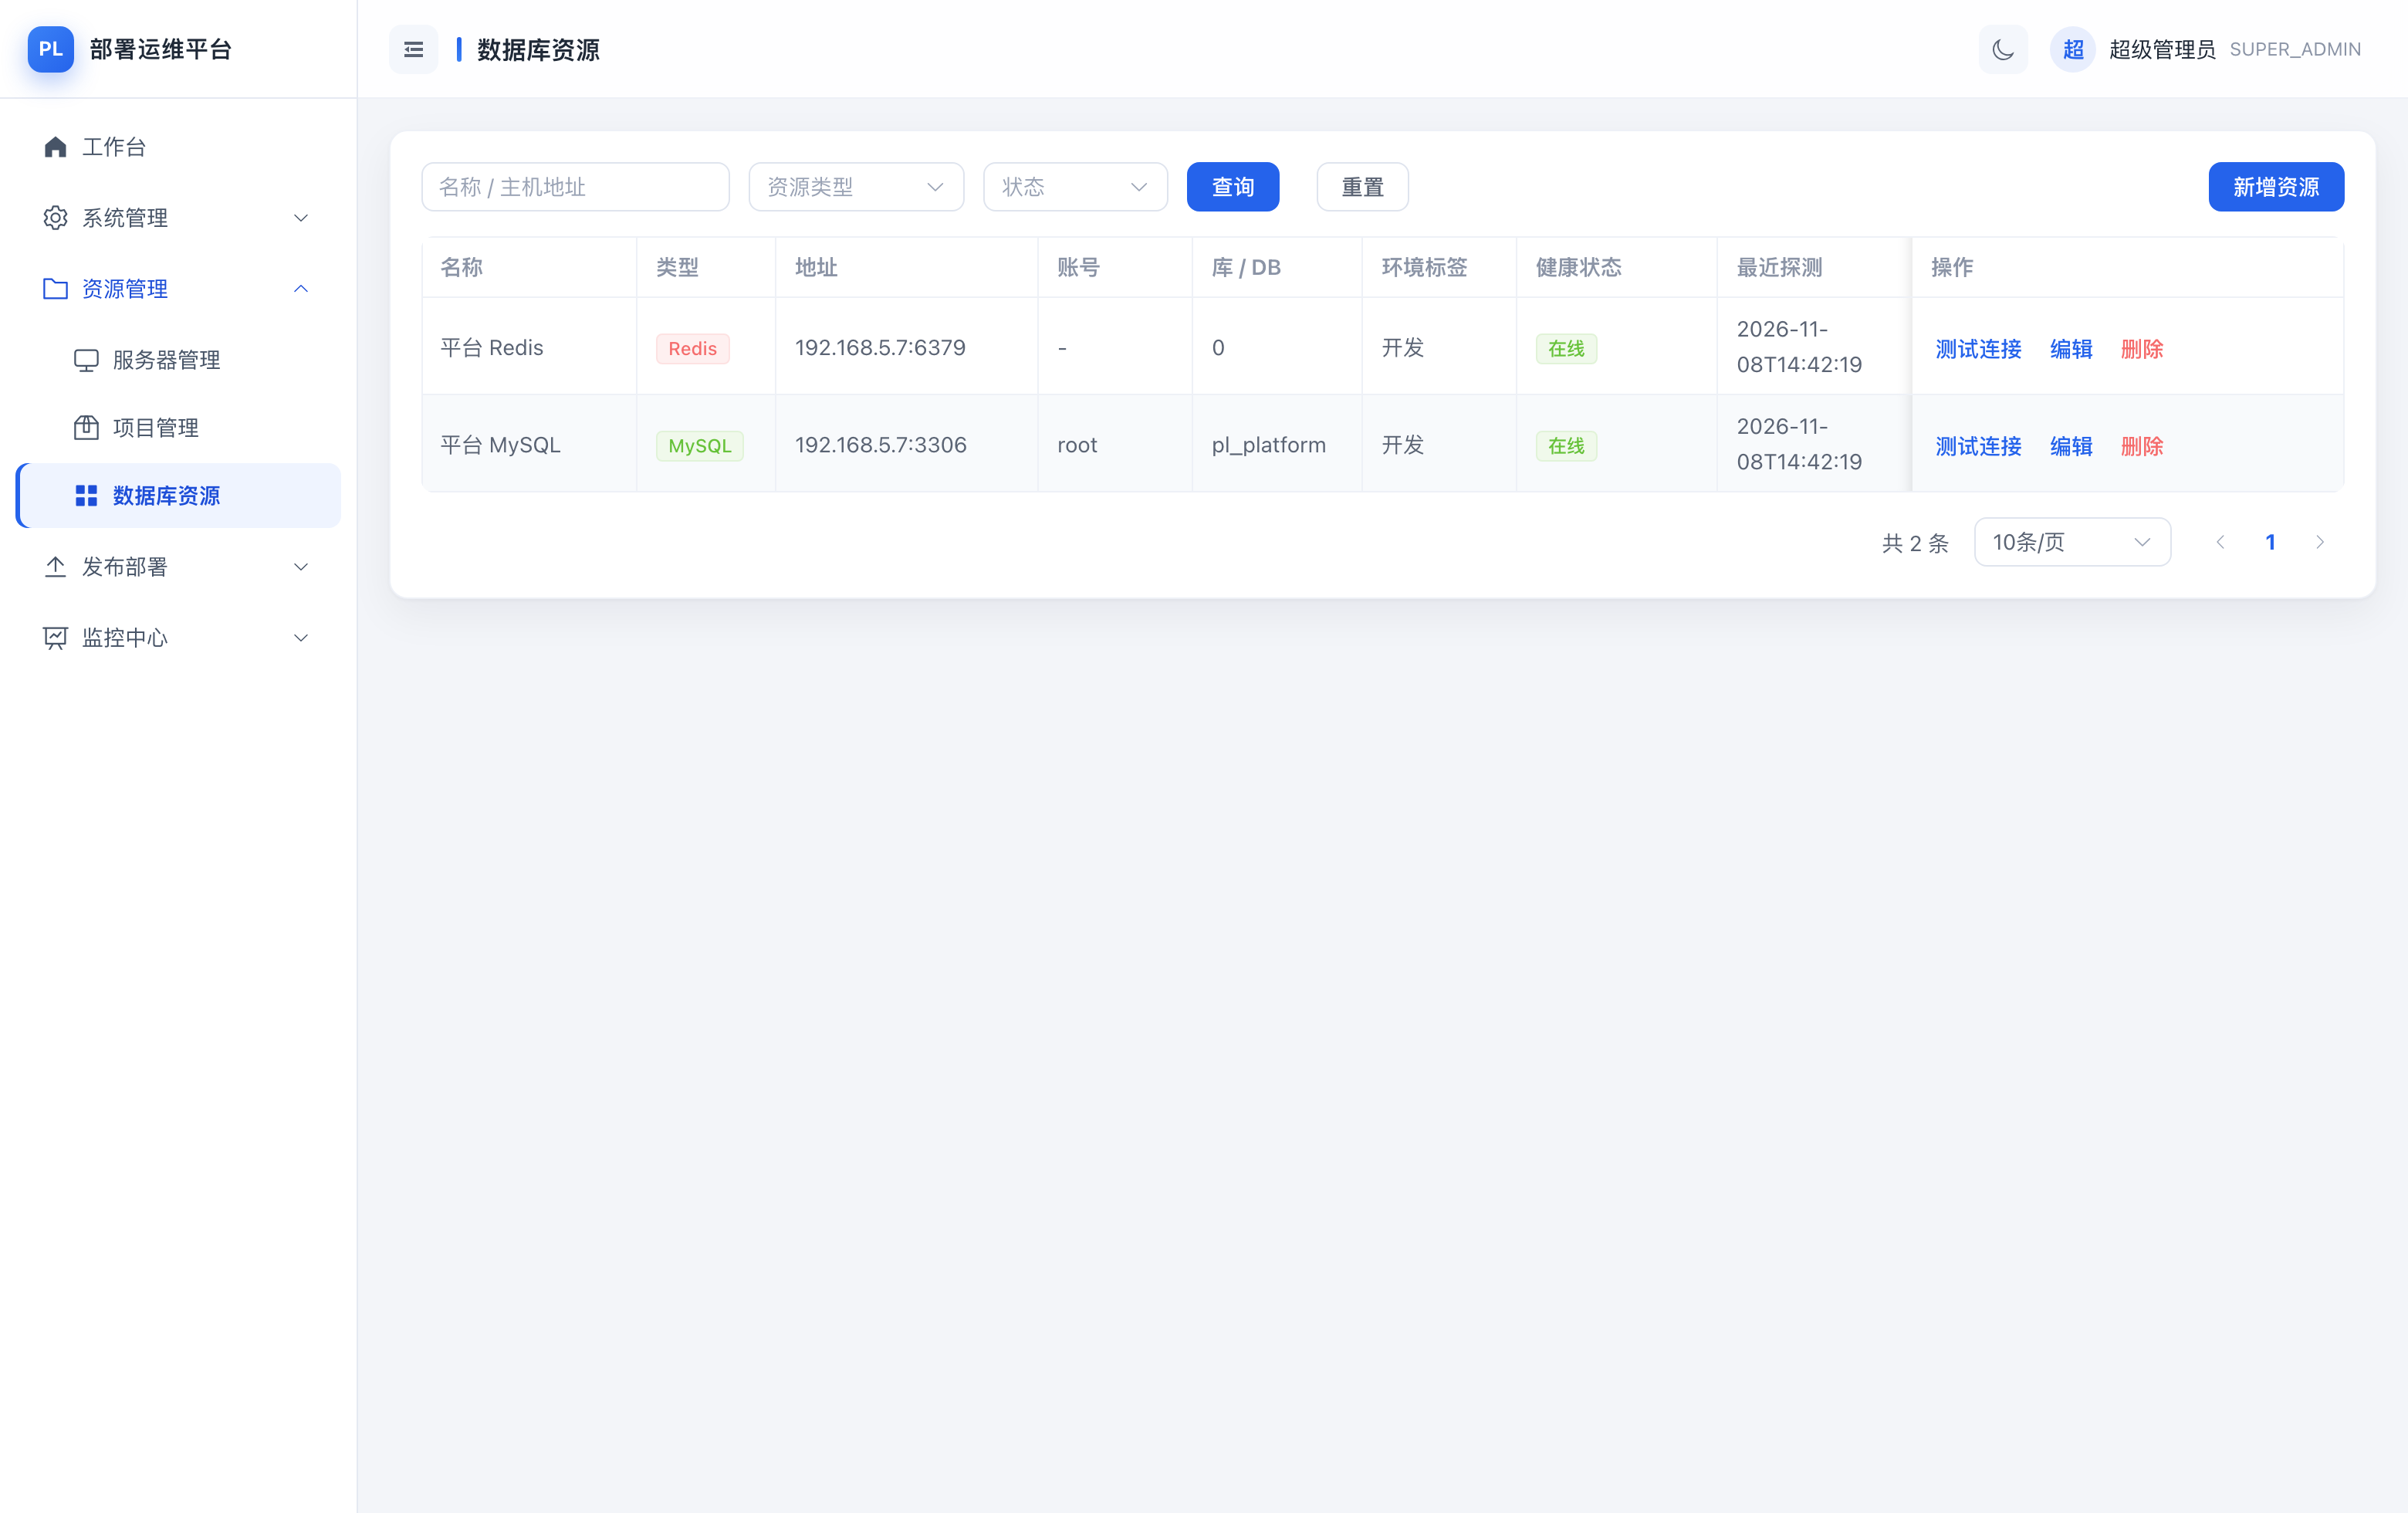
截图里的两台资源正是平台自身依赖的 MySQL 和 Redis——吃自己的狗粮,资源中心的探测与指标采集每天都在平台自己的依赖上运行。
2.3 发布中心(重构 + 审批)
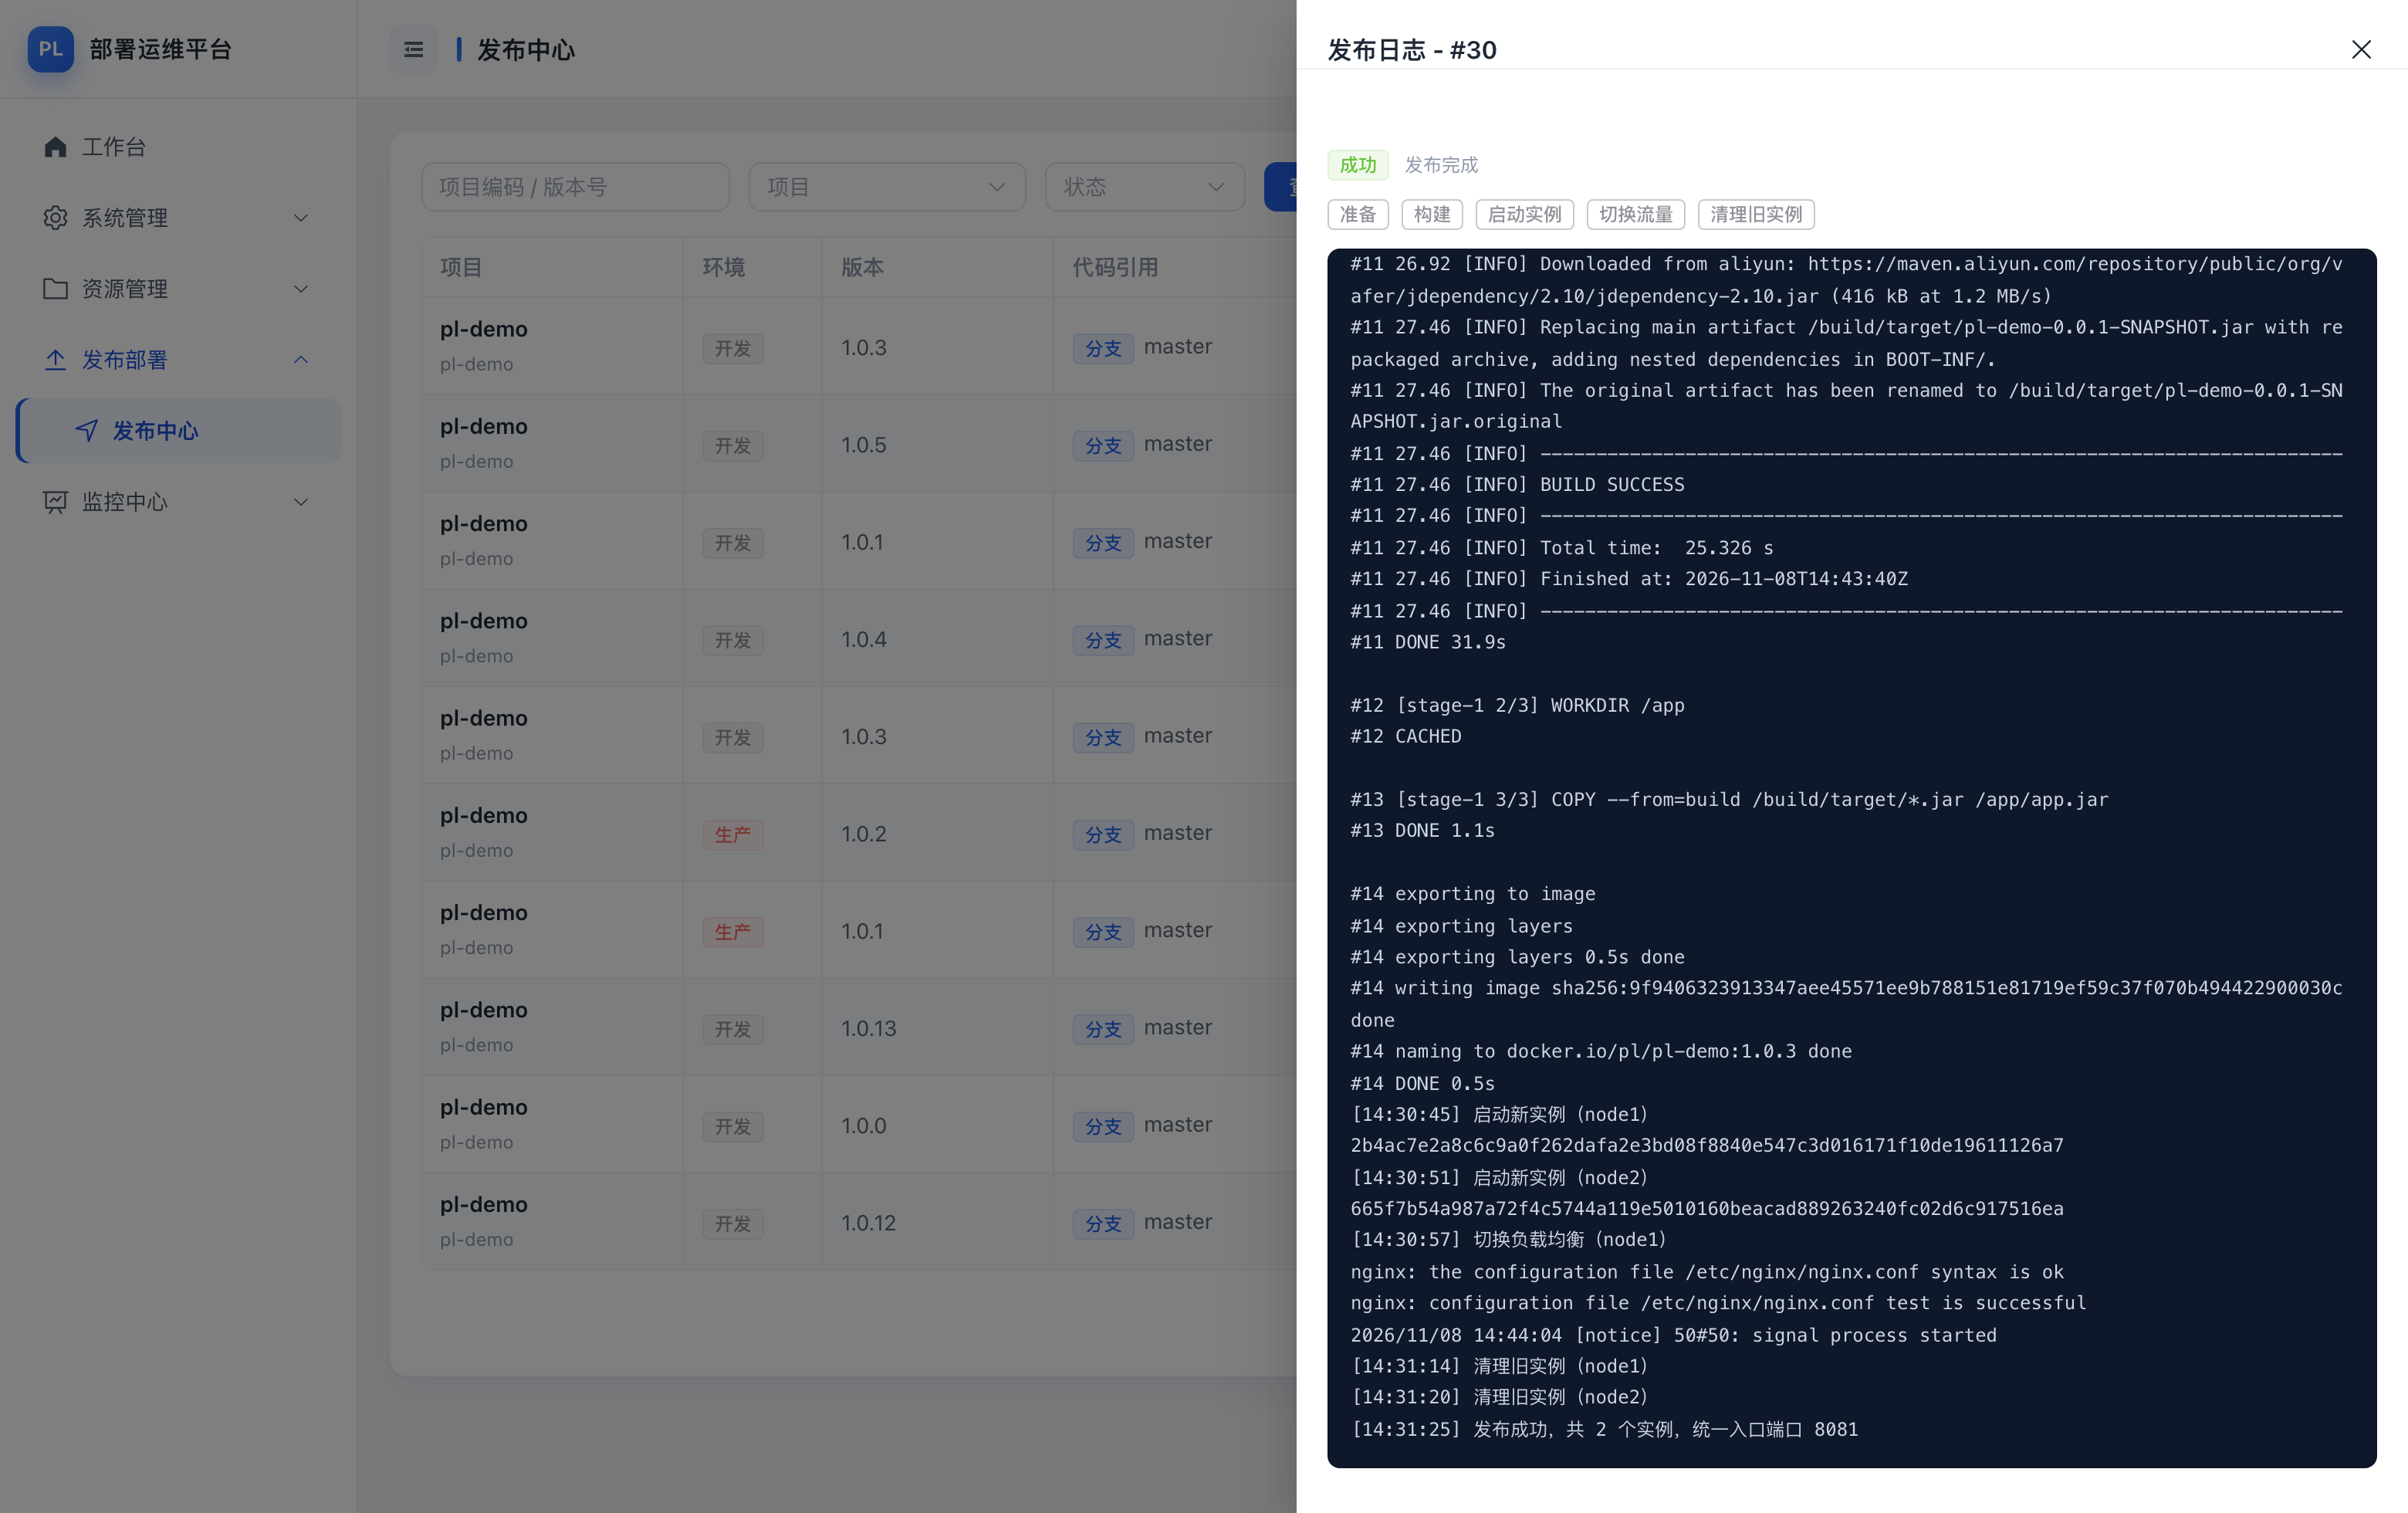
发布单列表的状态从 3 种变成 6 种:排队中 / APPROVING / RUNNING / SUCCESS / FAILED / REJECTED。PROD 环境的发布单需要审批,驳回后状态为"已驳回";失败的发布单出现重试按钮——点击后从失败阶段断点续跑,而不是从头再来。
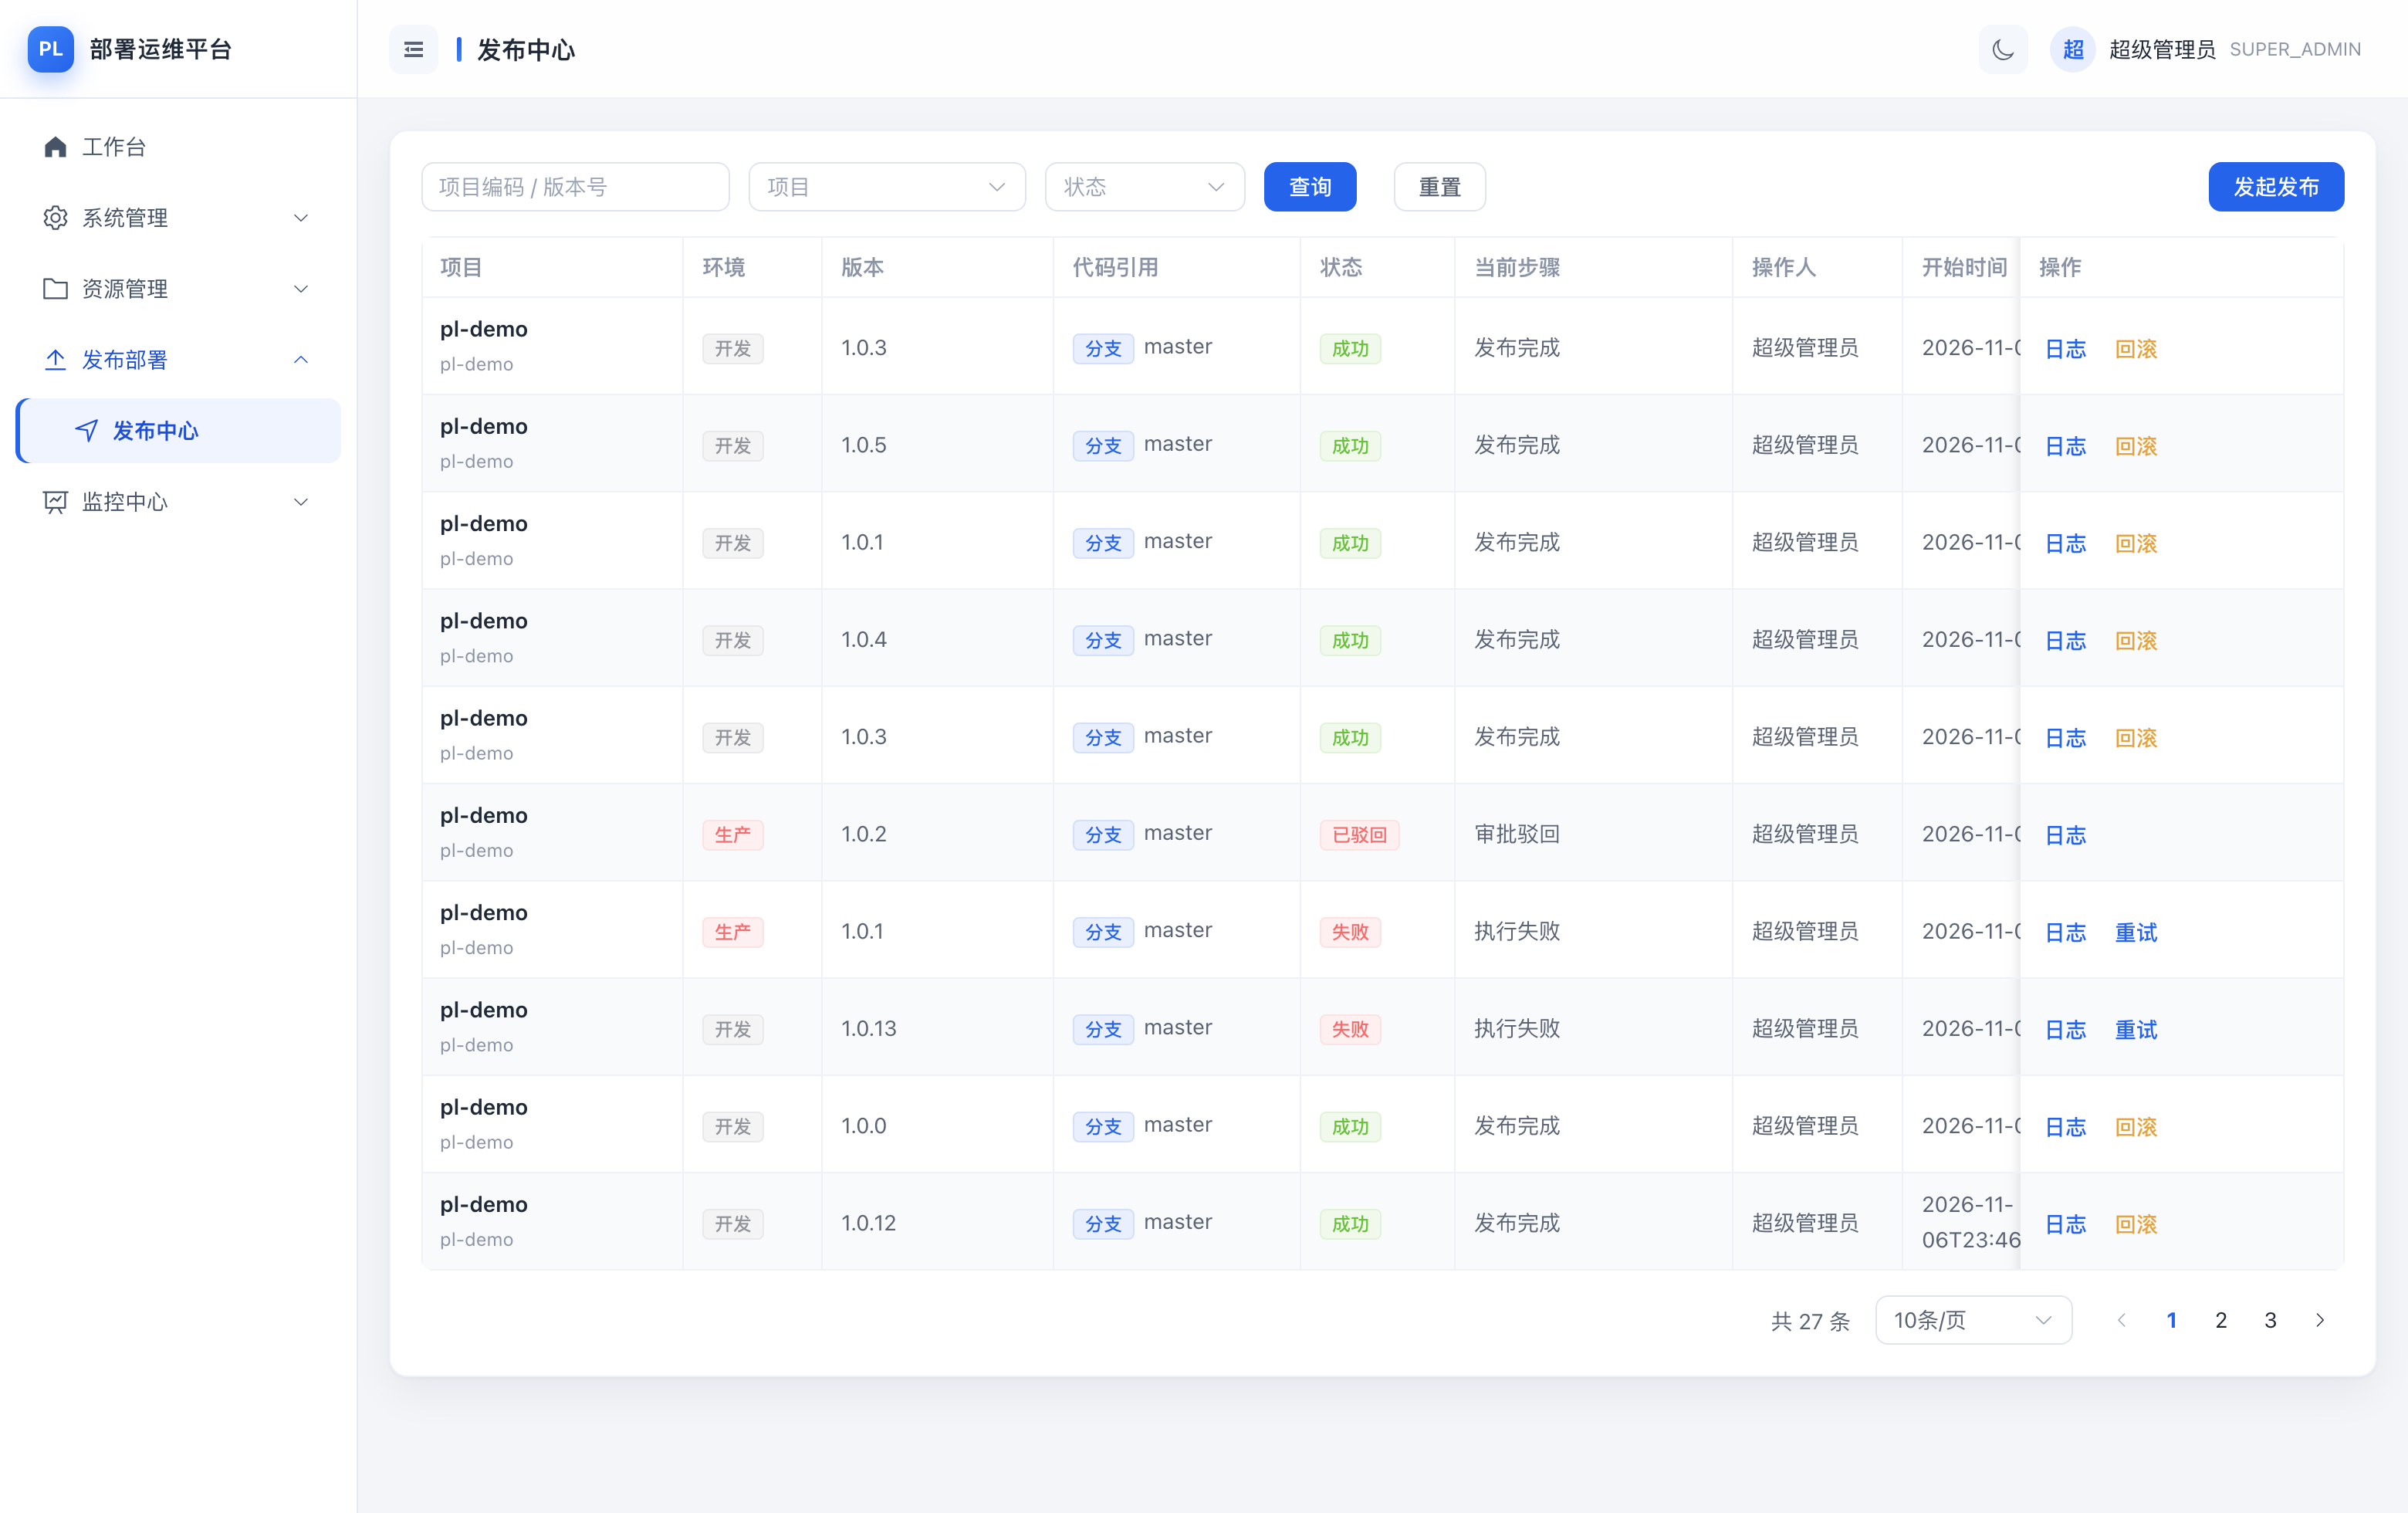
点开日志抽屉,顶部是阶段时间线(准备 → 构建 → 启动实例 → 切换流量 → 清理旧实例),日志区实时滚动:
2.4 监控中心(采样 + 告警)
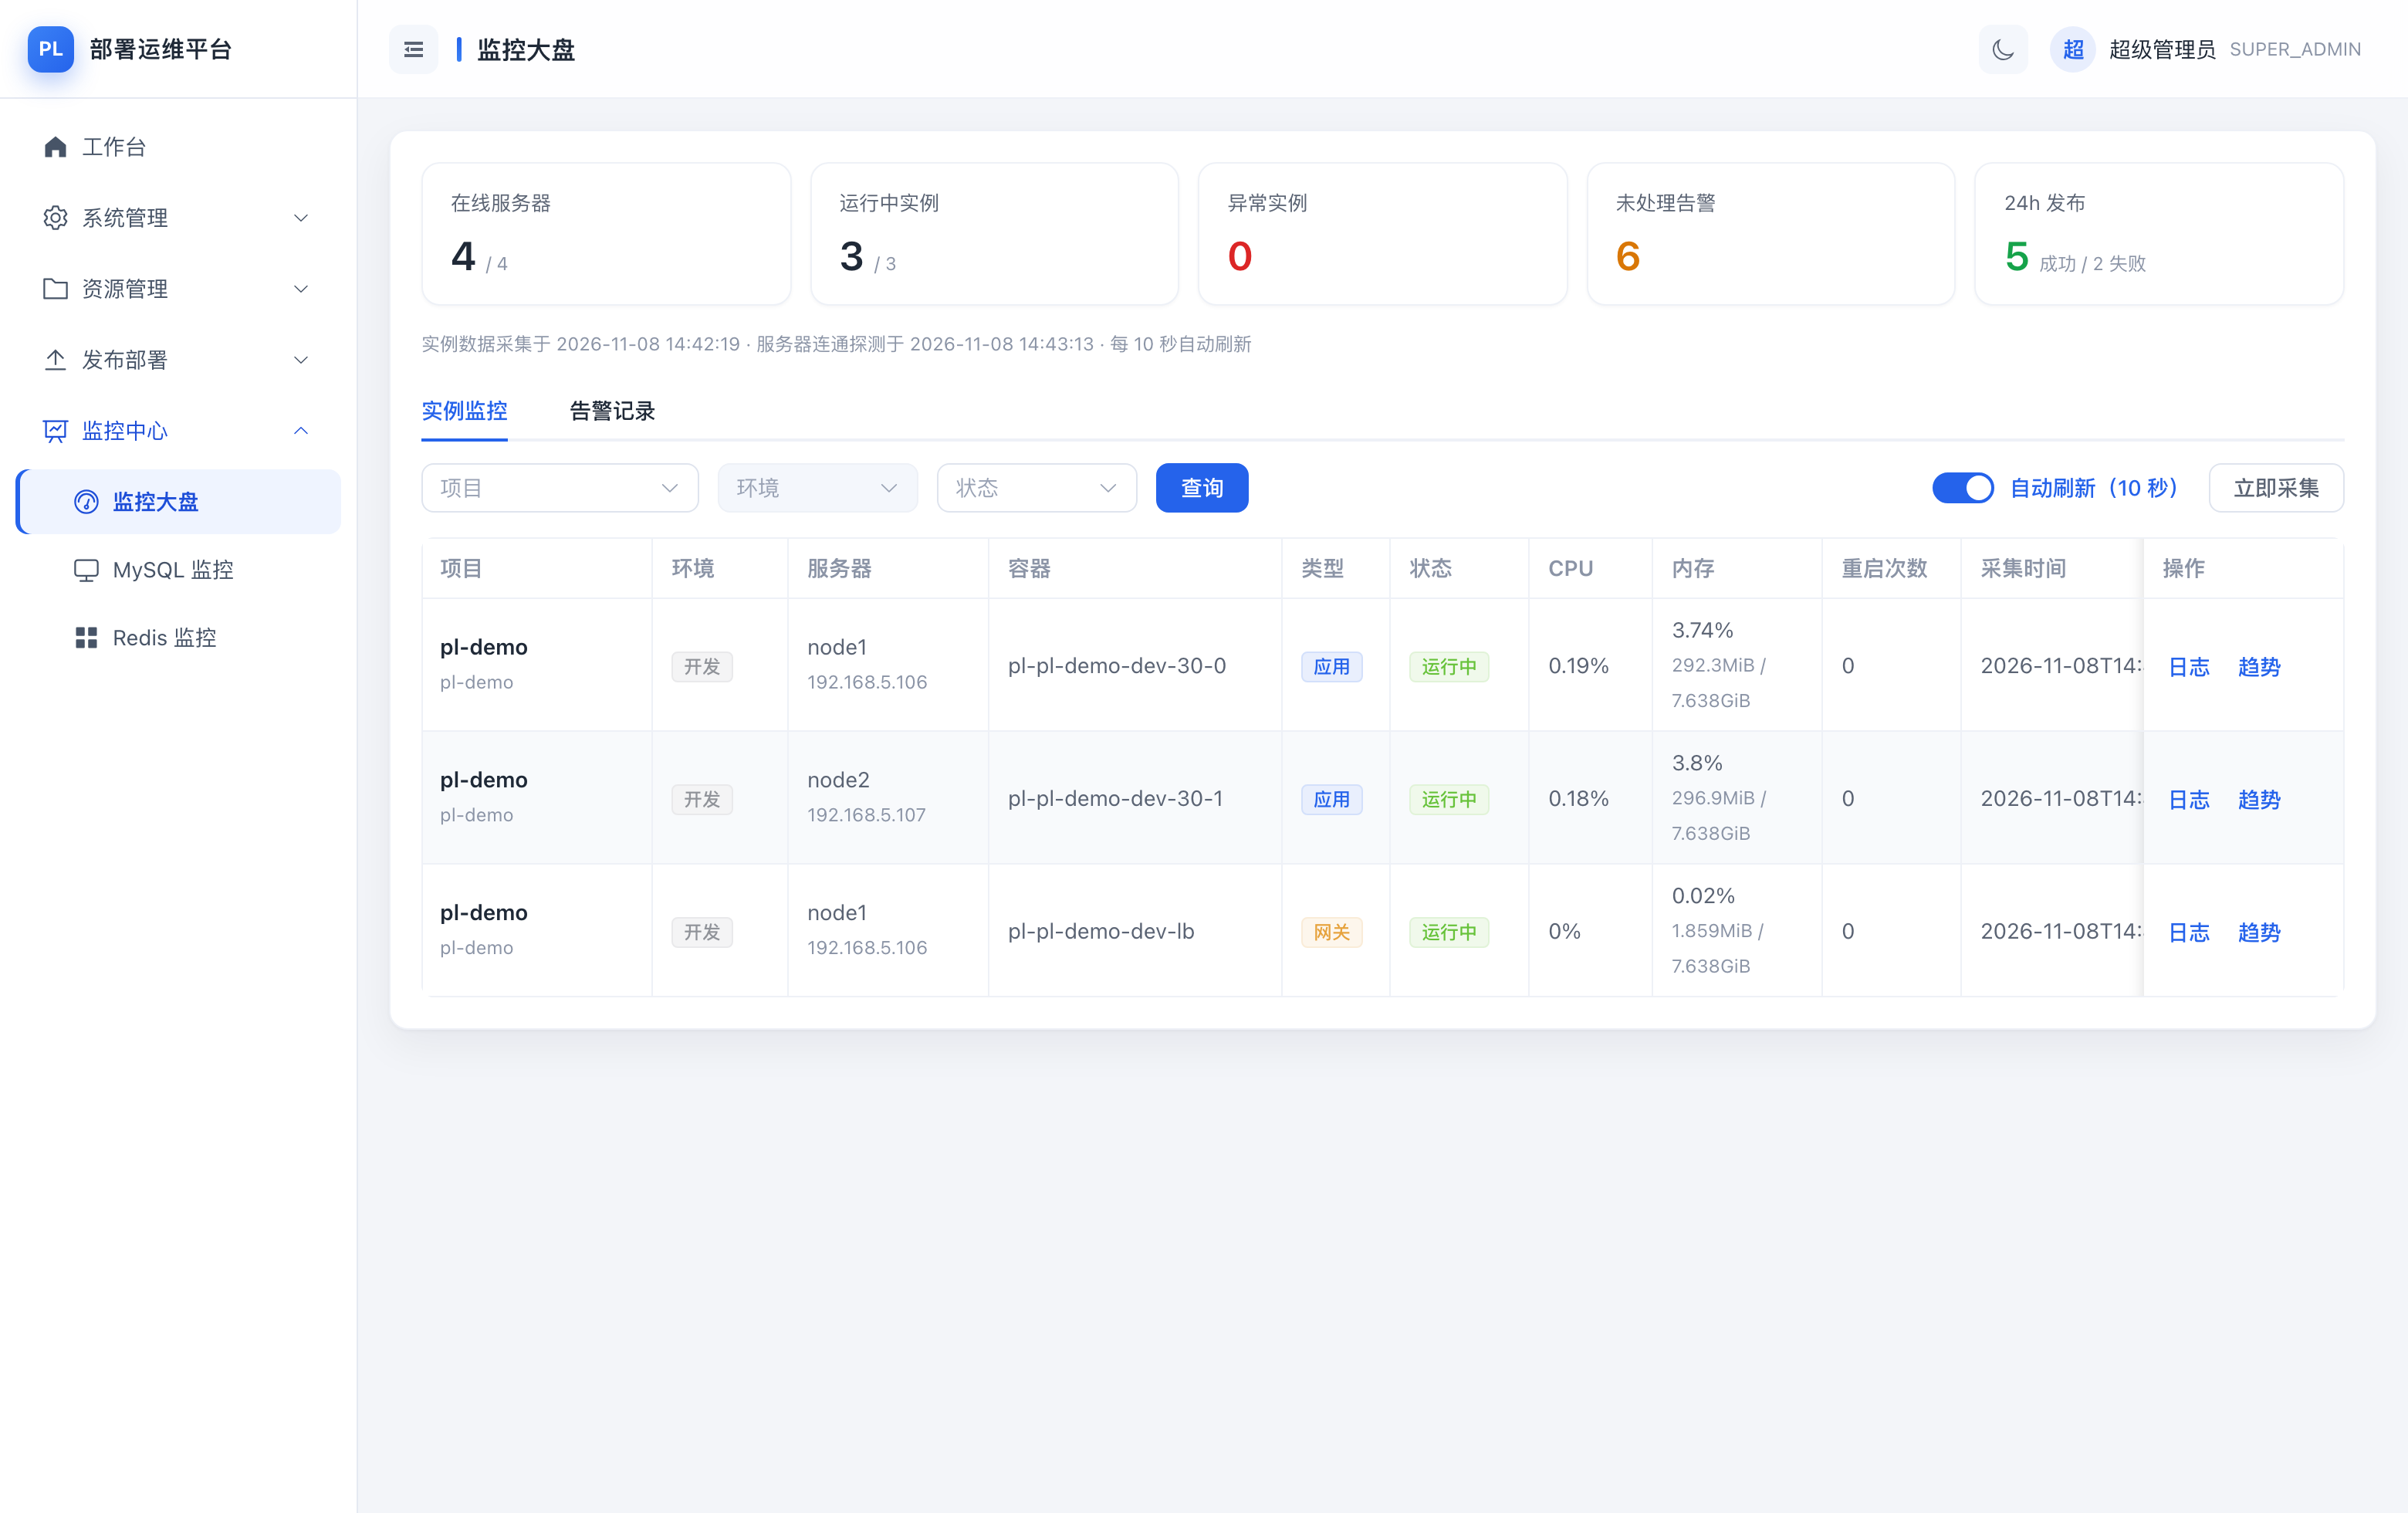
监控大盘保留真实探活与标签发现,新增 24 小时指标趋势;告警通过 webhook 外发到飞书/企微群。
2.5 数据库监控(新增)
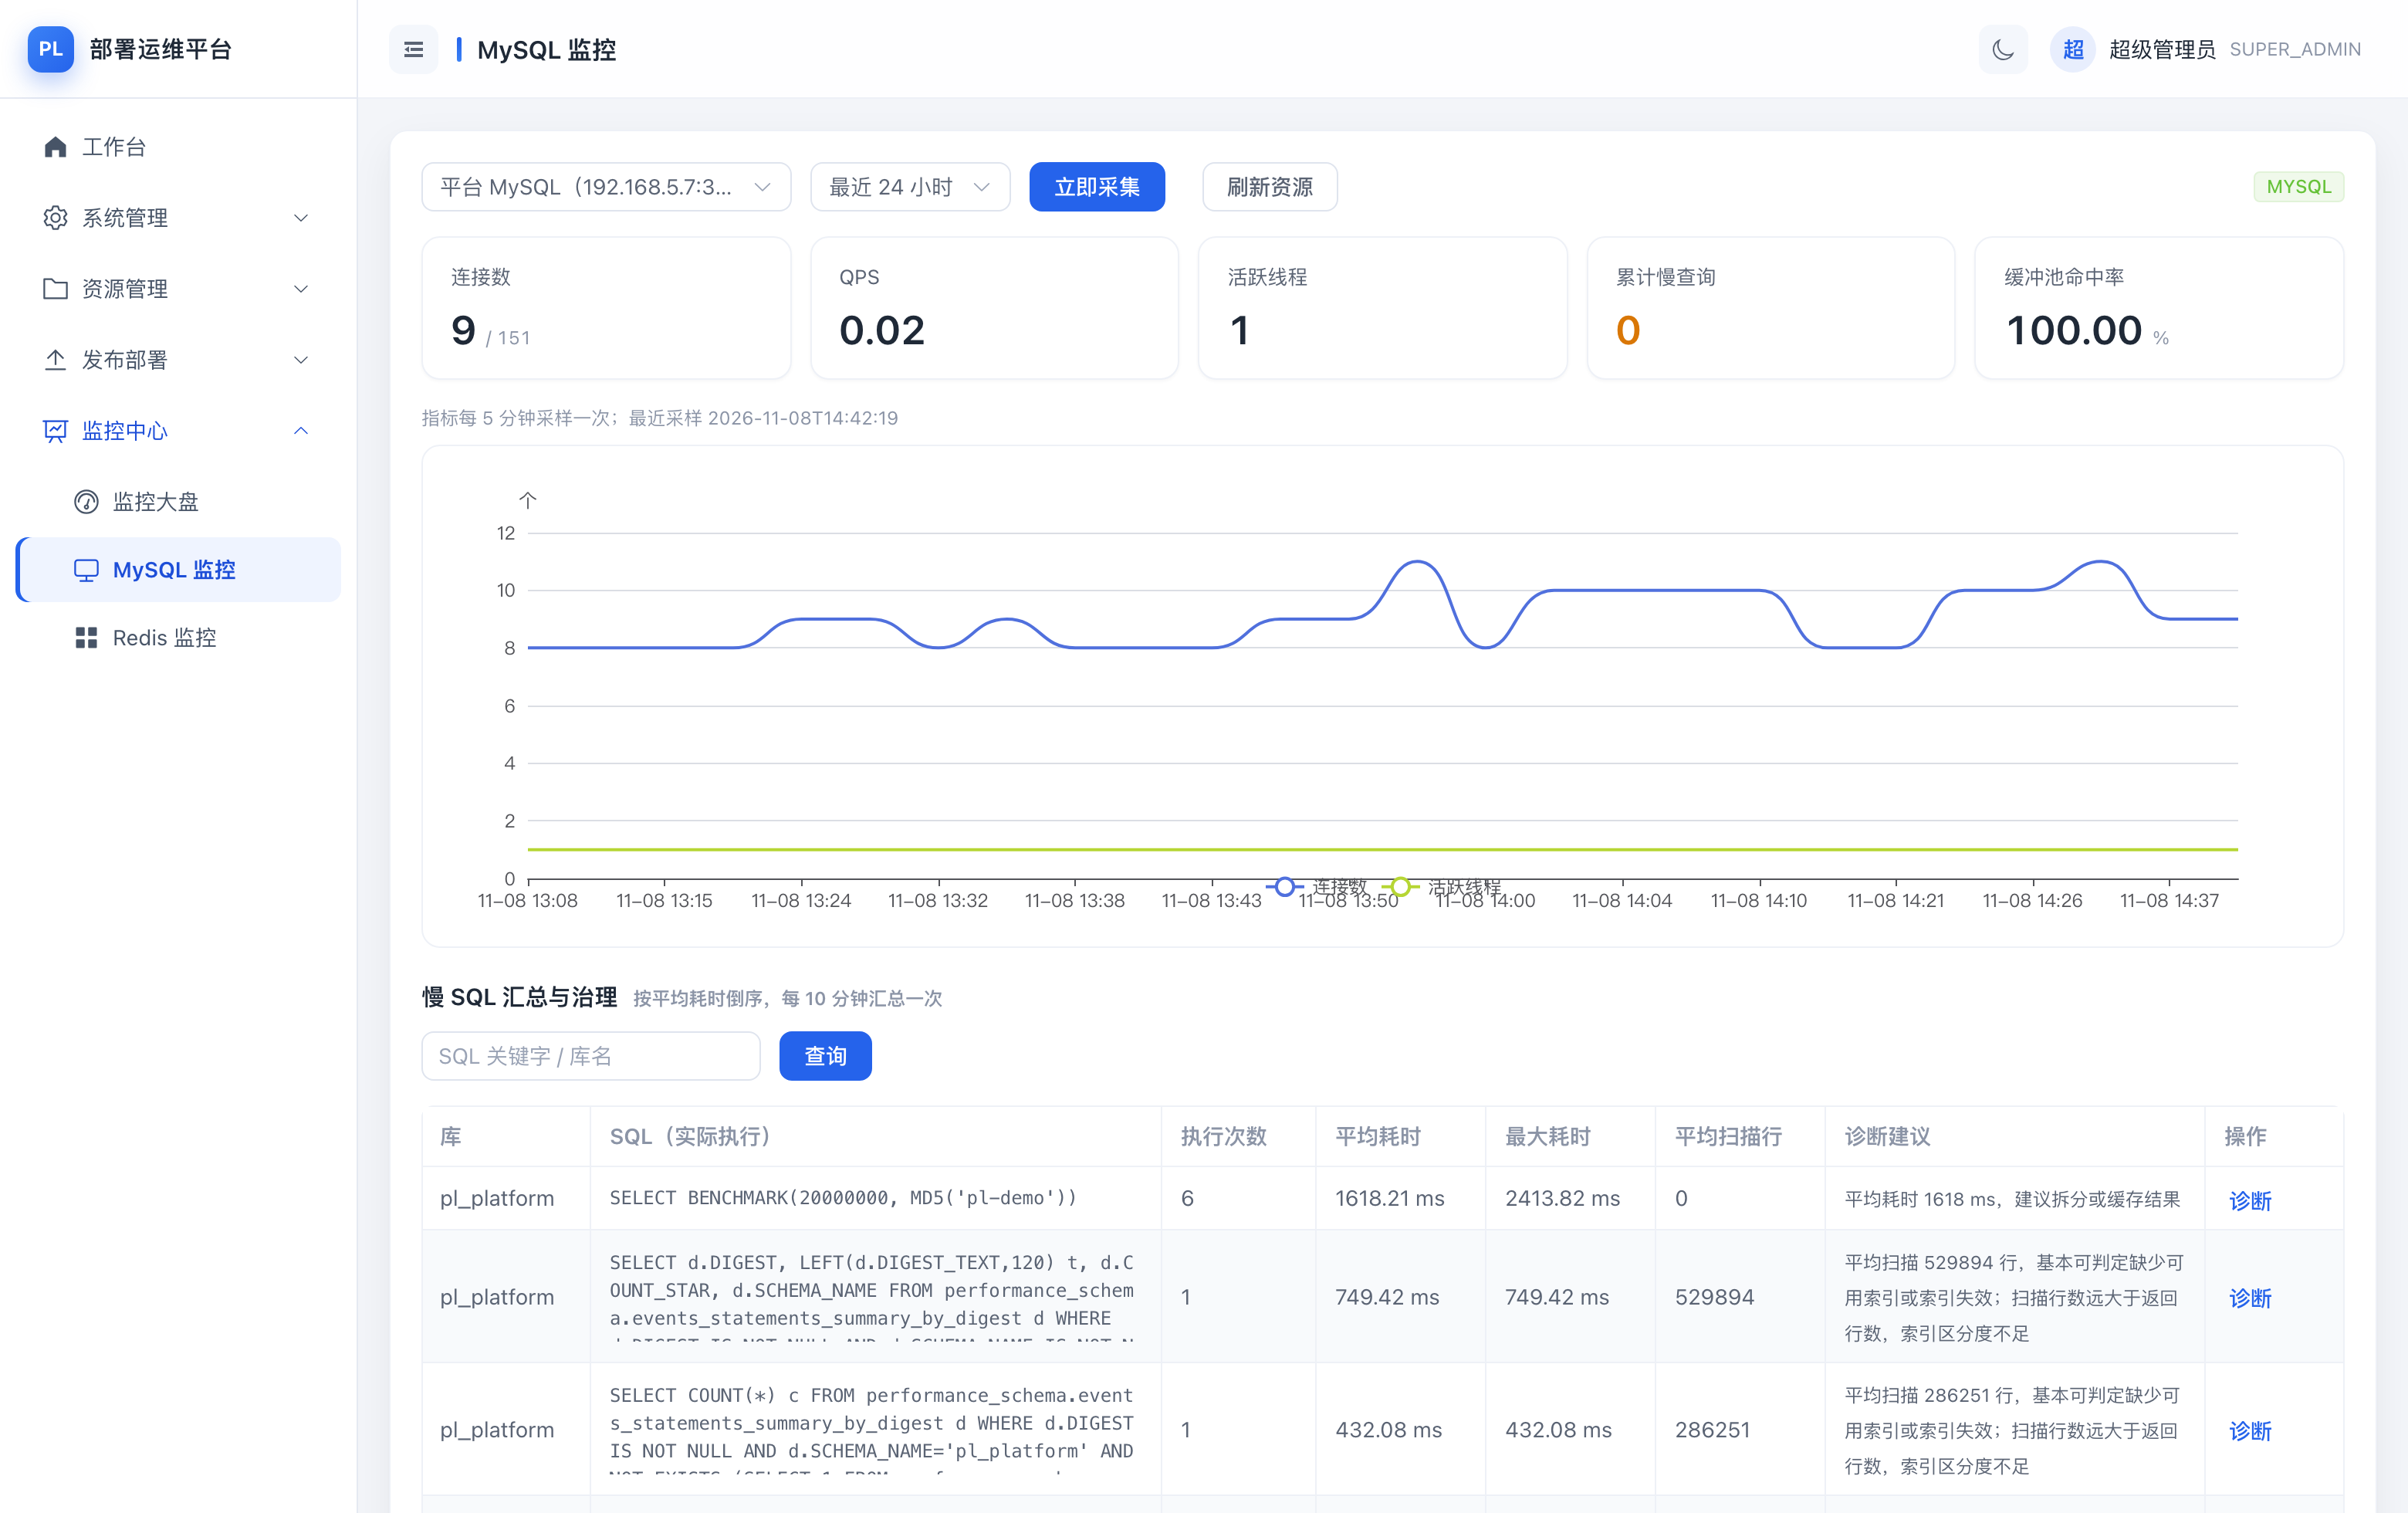
MySQL 监控页:连接数、QPS、活跃线程、慢查询累计、缓冲池命中率五张指标卡 + 24 小时趋势图;下方是慢 SQL 汇总与诊断——按累计耗时排序,每条给出执行次数、平均/最大耗时、平均扫描行数、诊断建议,并可对实际执行样本一键 EXPLAIN。
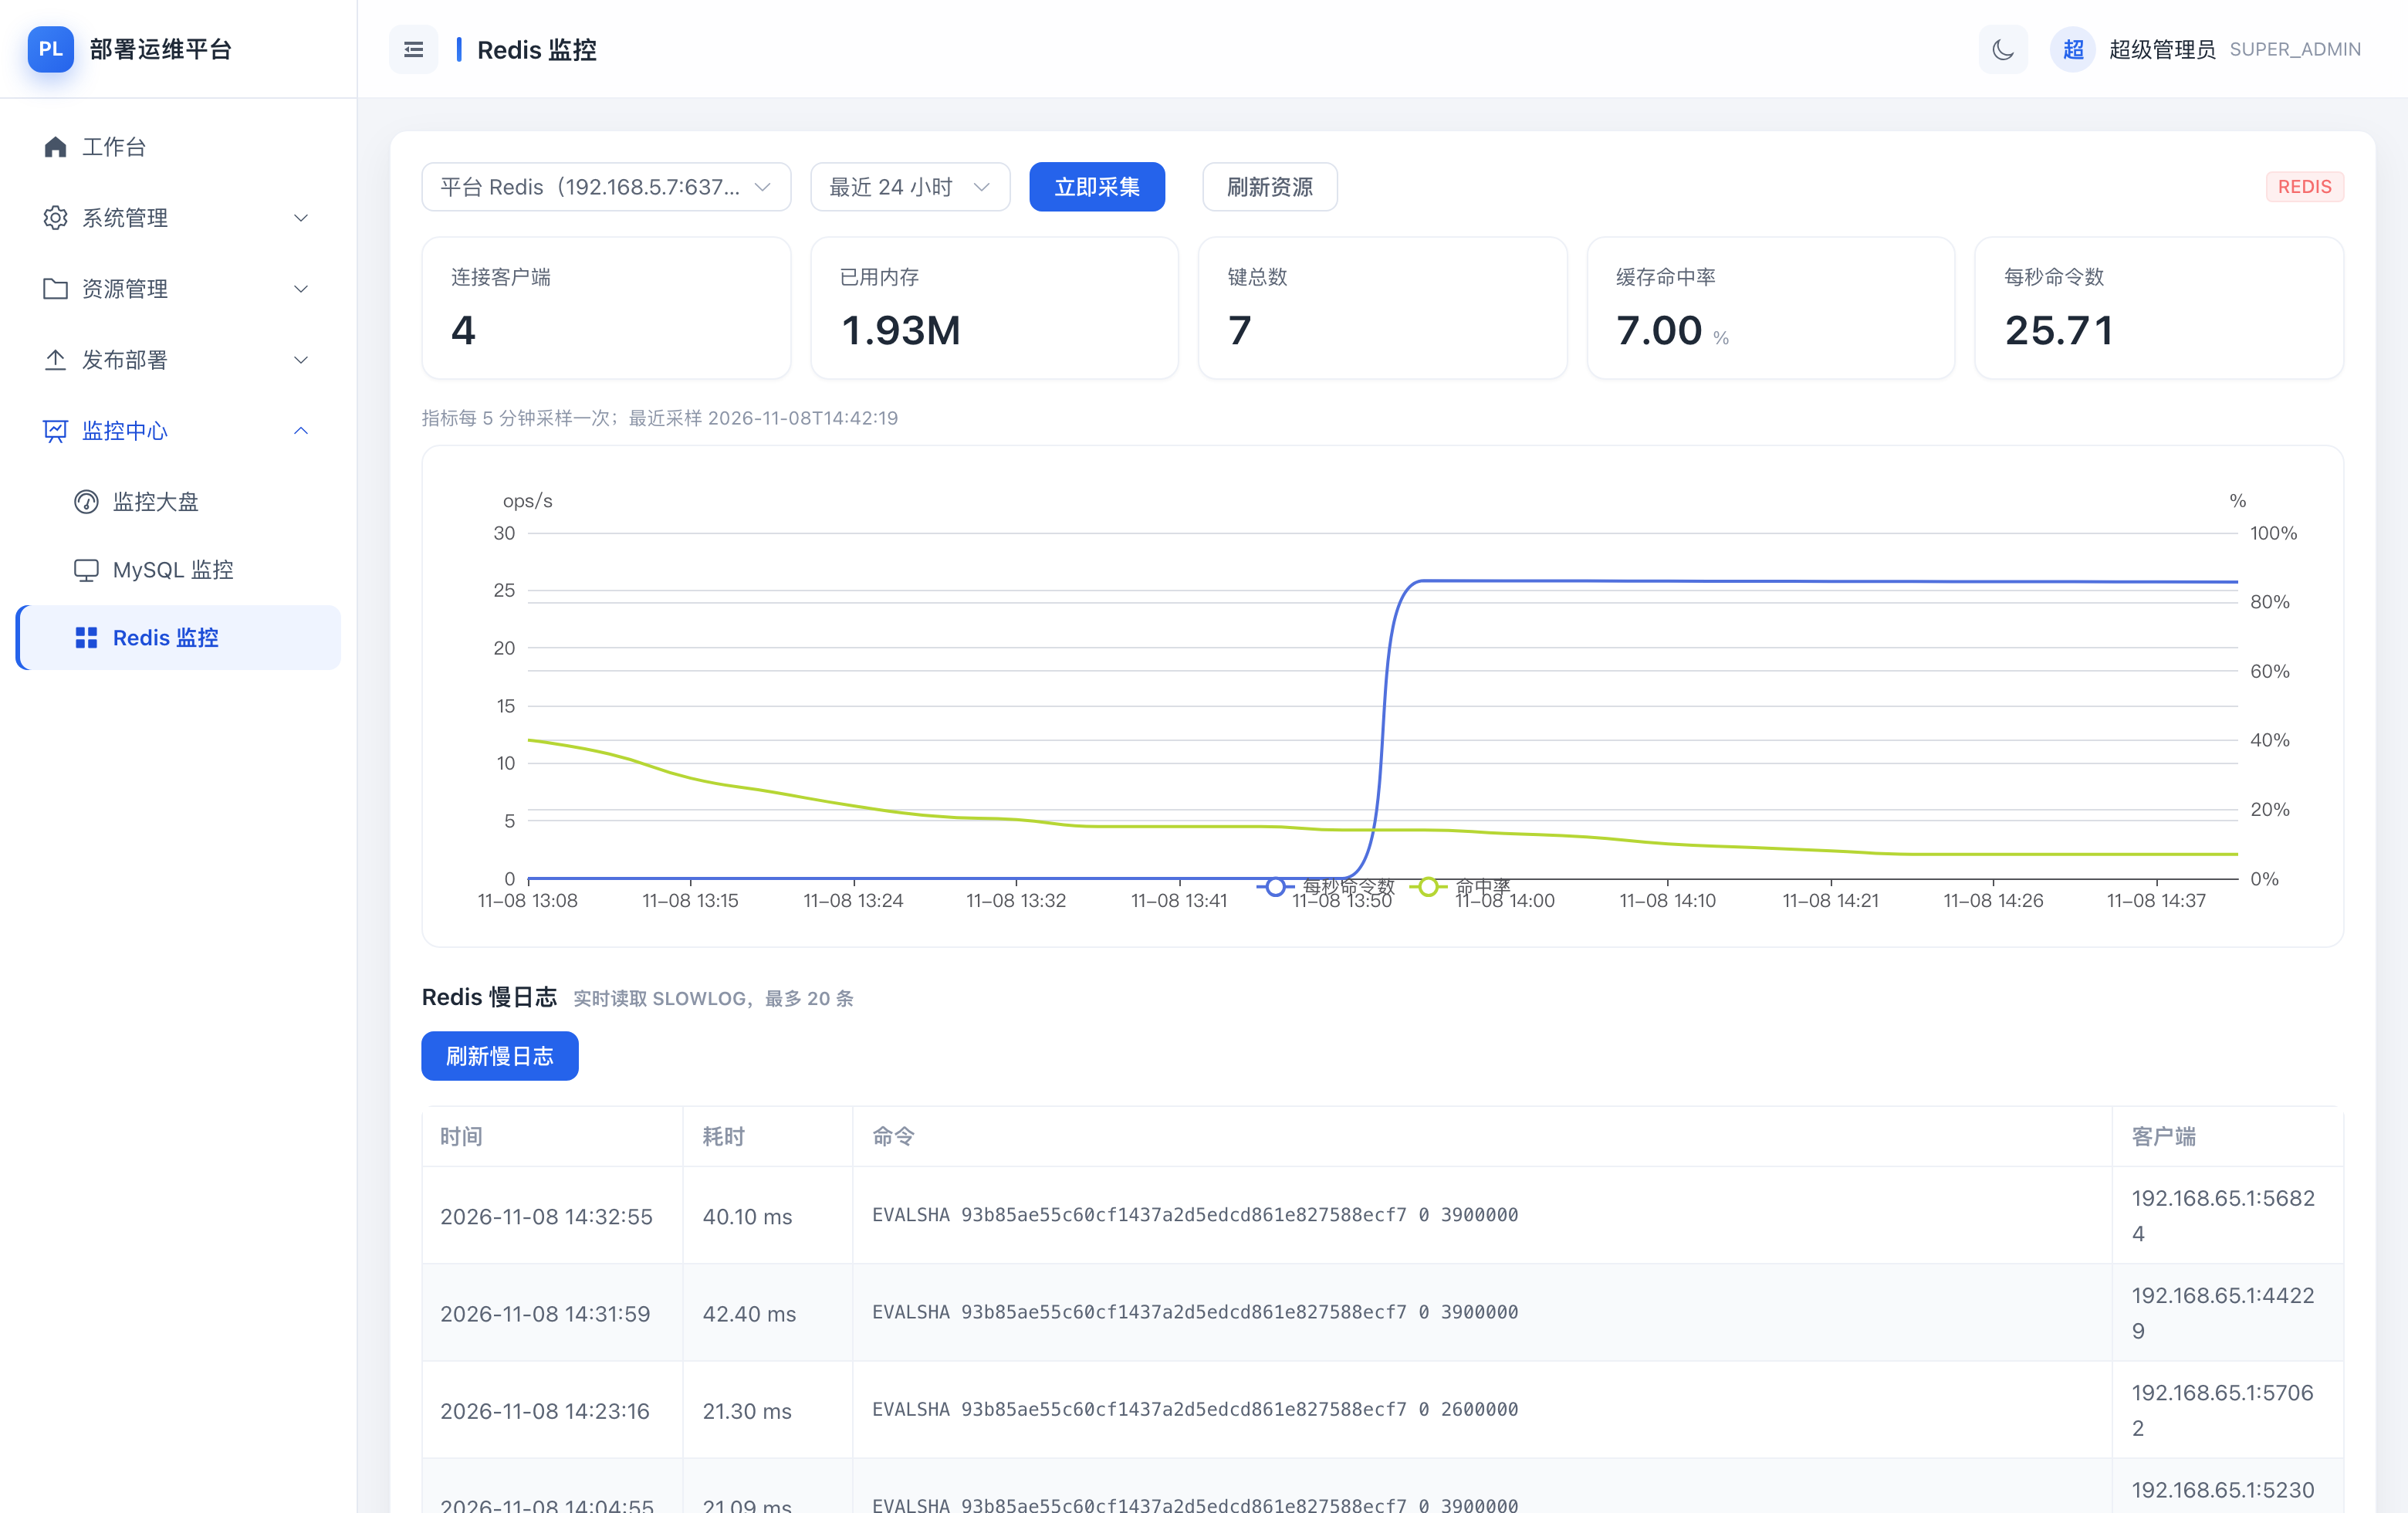
Redis 监控页:连接数、命中率、内存、键总数、OPS 等指标与趋势。
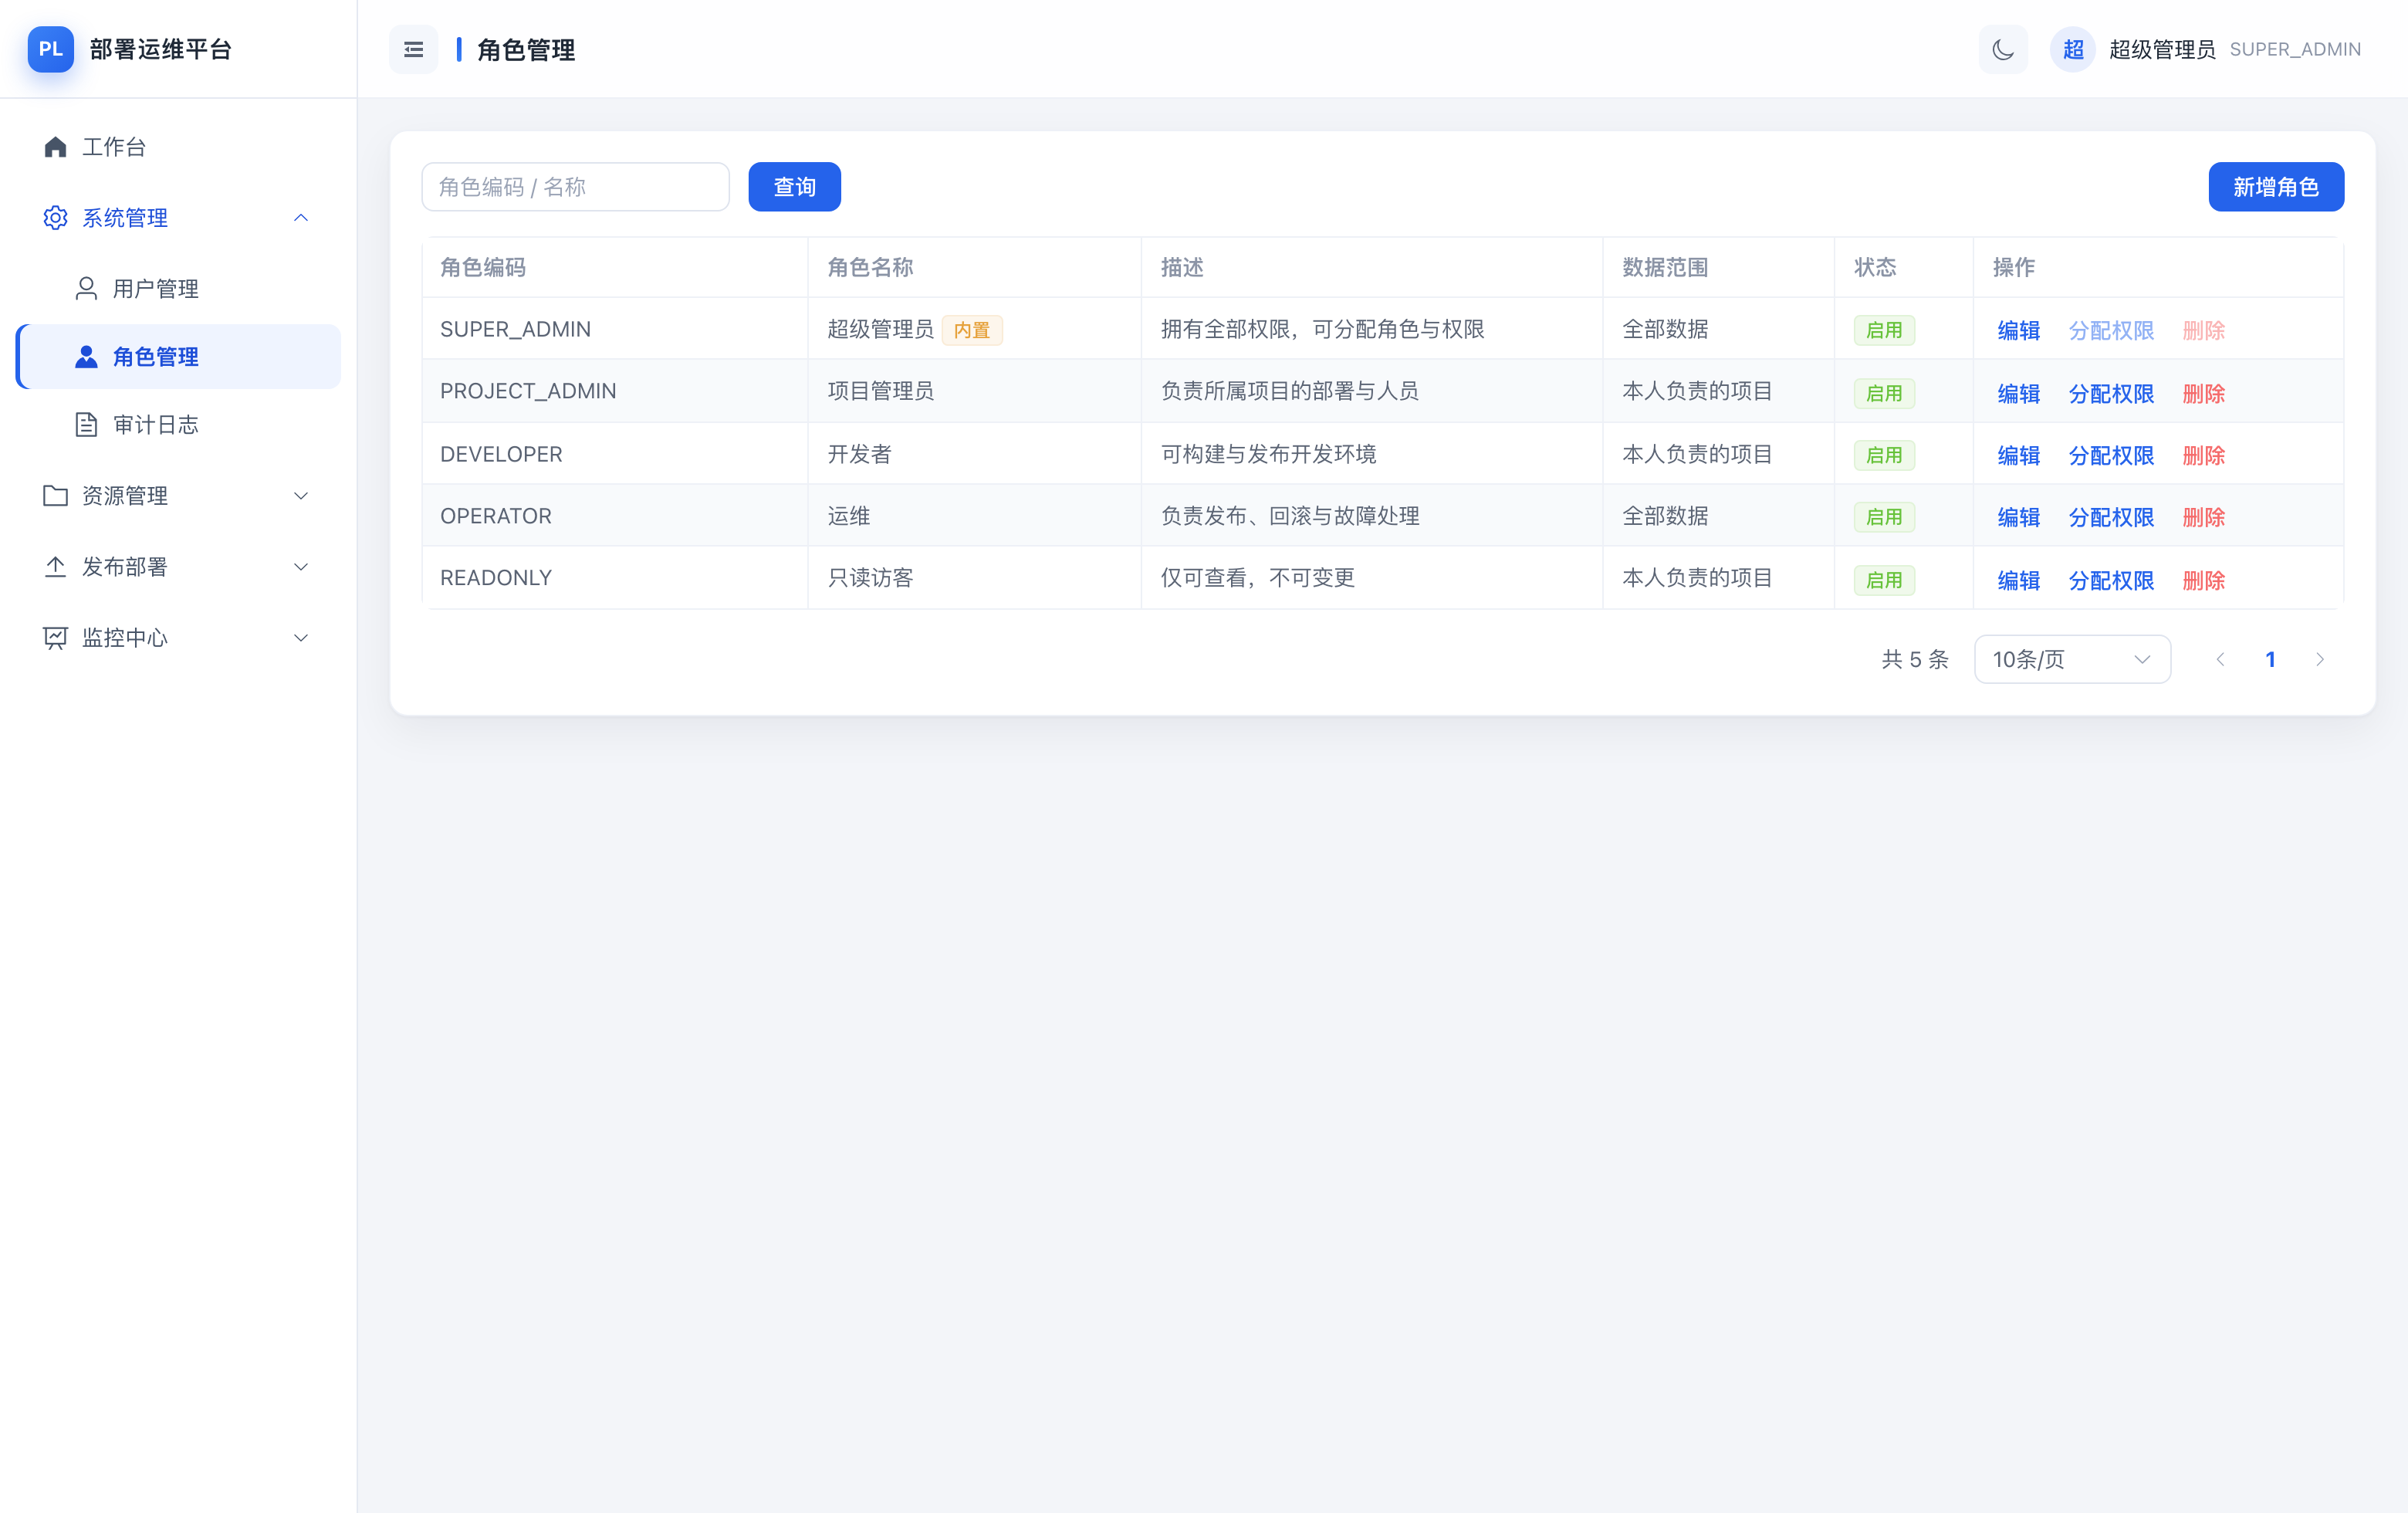
2.6 权限与审计
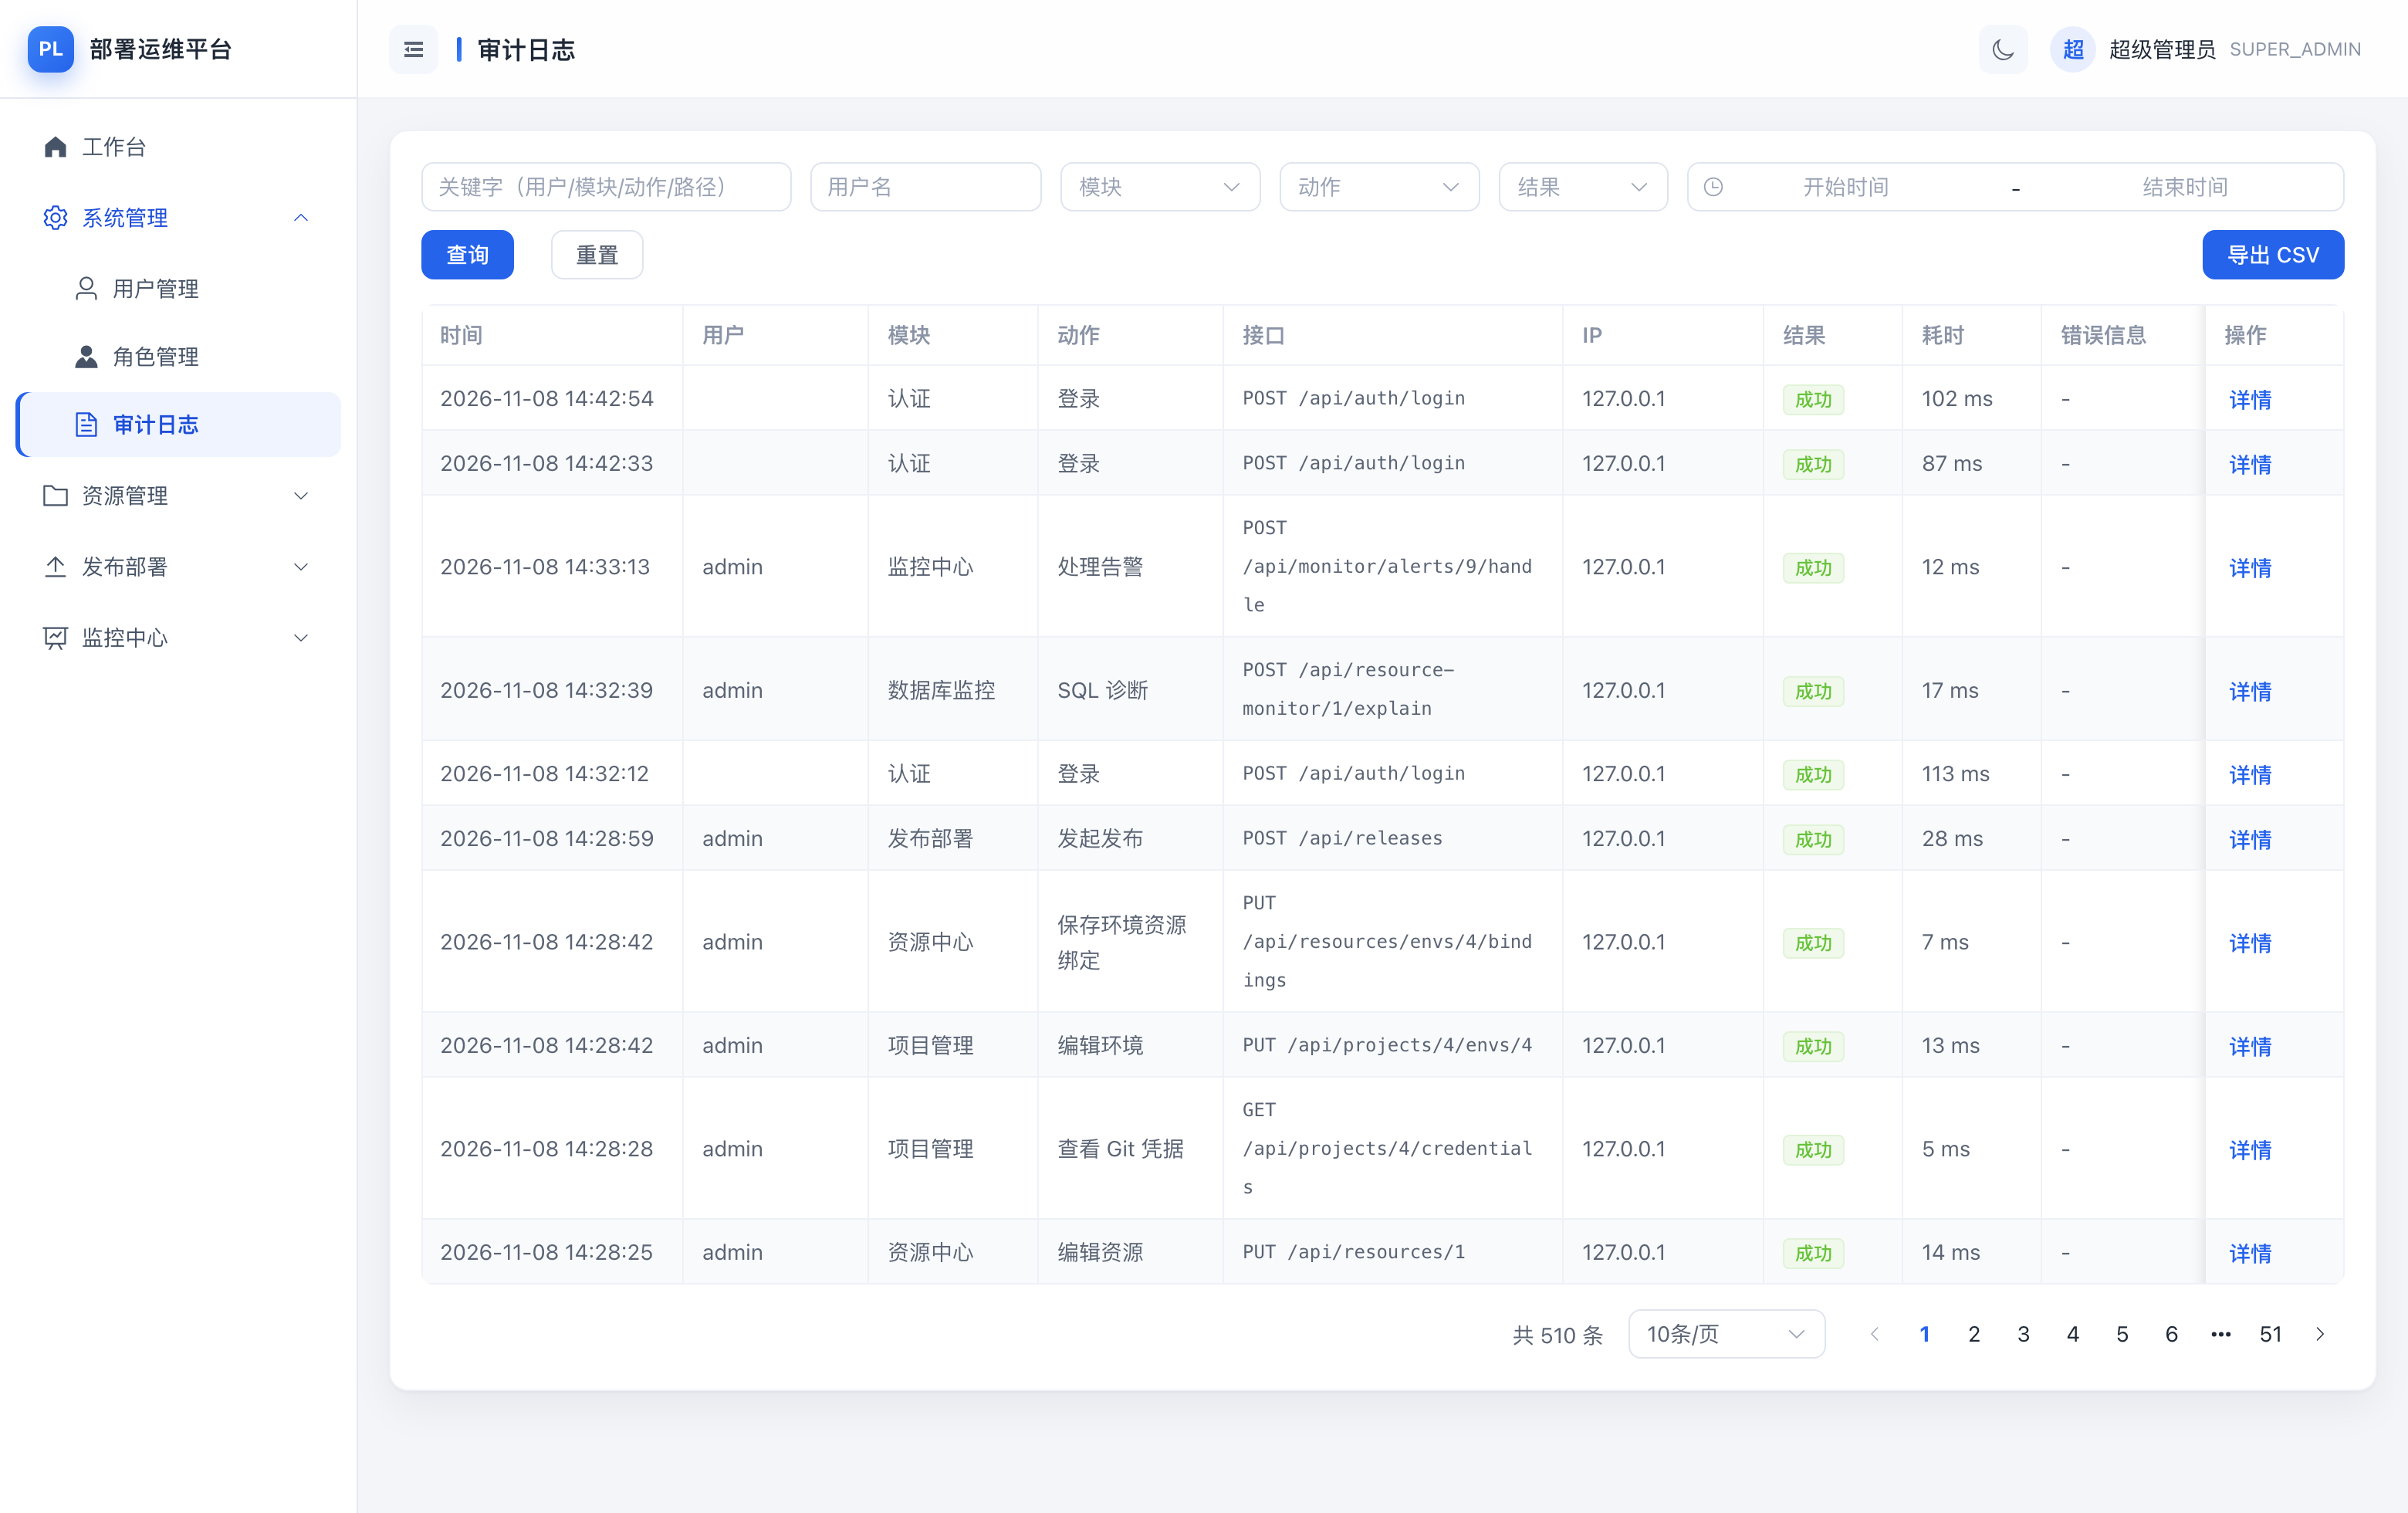
RBAC + 数据范围不变,新增 release:approve 权限点控制审批动作;审计切面覆盖审批、发布、回滚、凭据查看等全部敏感操作。
三、怎么做:四个关键重构 + 两个新模块
3.1 架构总览
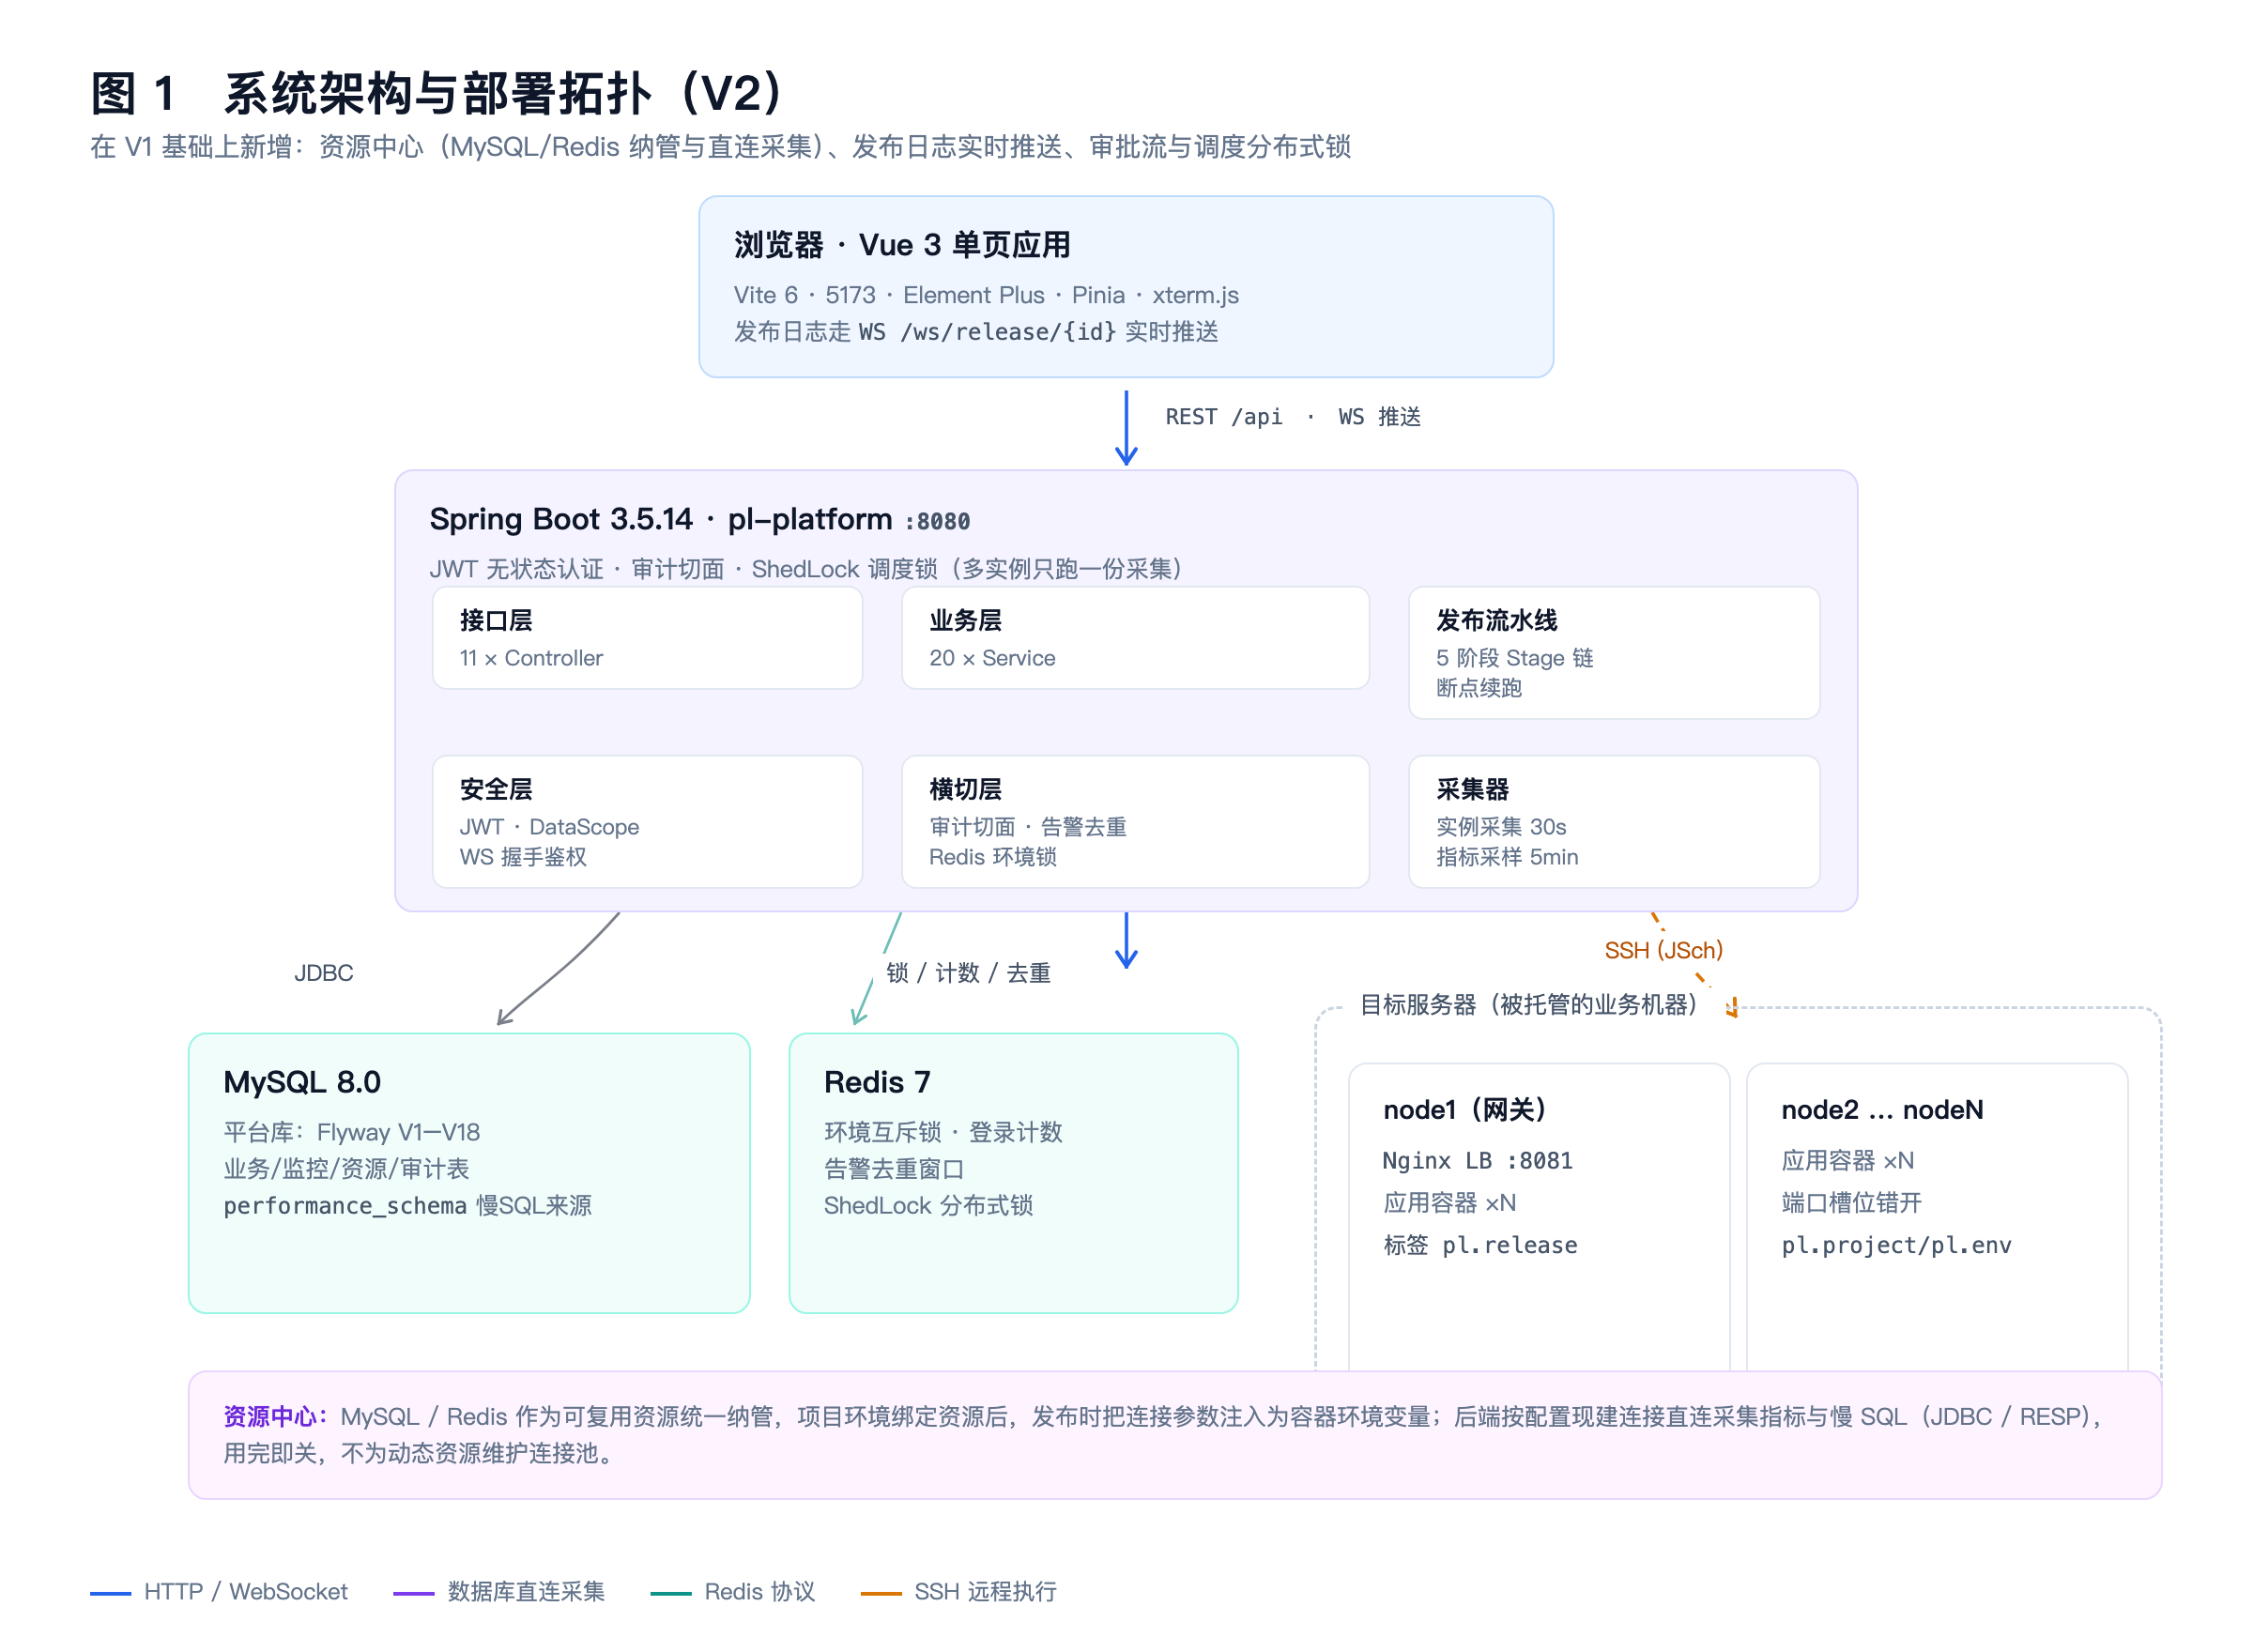
与 V1 相比,架构图上多了三条通路:
后端 → 外部资源直连:资源中心按配置现建 JDBC / RESP 连接采集指标与慢 SQL,用完即关;
后端 → 浏览器 WS 推送:发布日志与状态变更实时推送,替代轮询;
采集任务 → Redis 分布式锁:ShedLock 保证多实例部署时采集只跑一份。
3.2 发布引擎重构:从巨石类到状态机
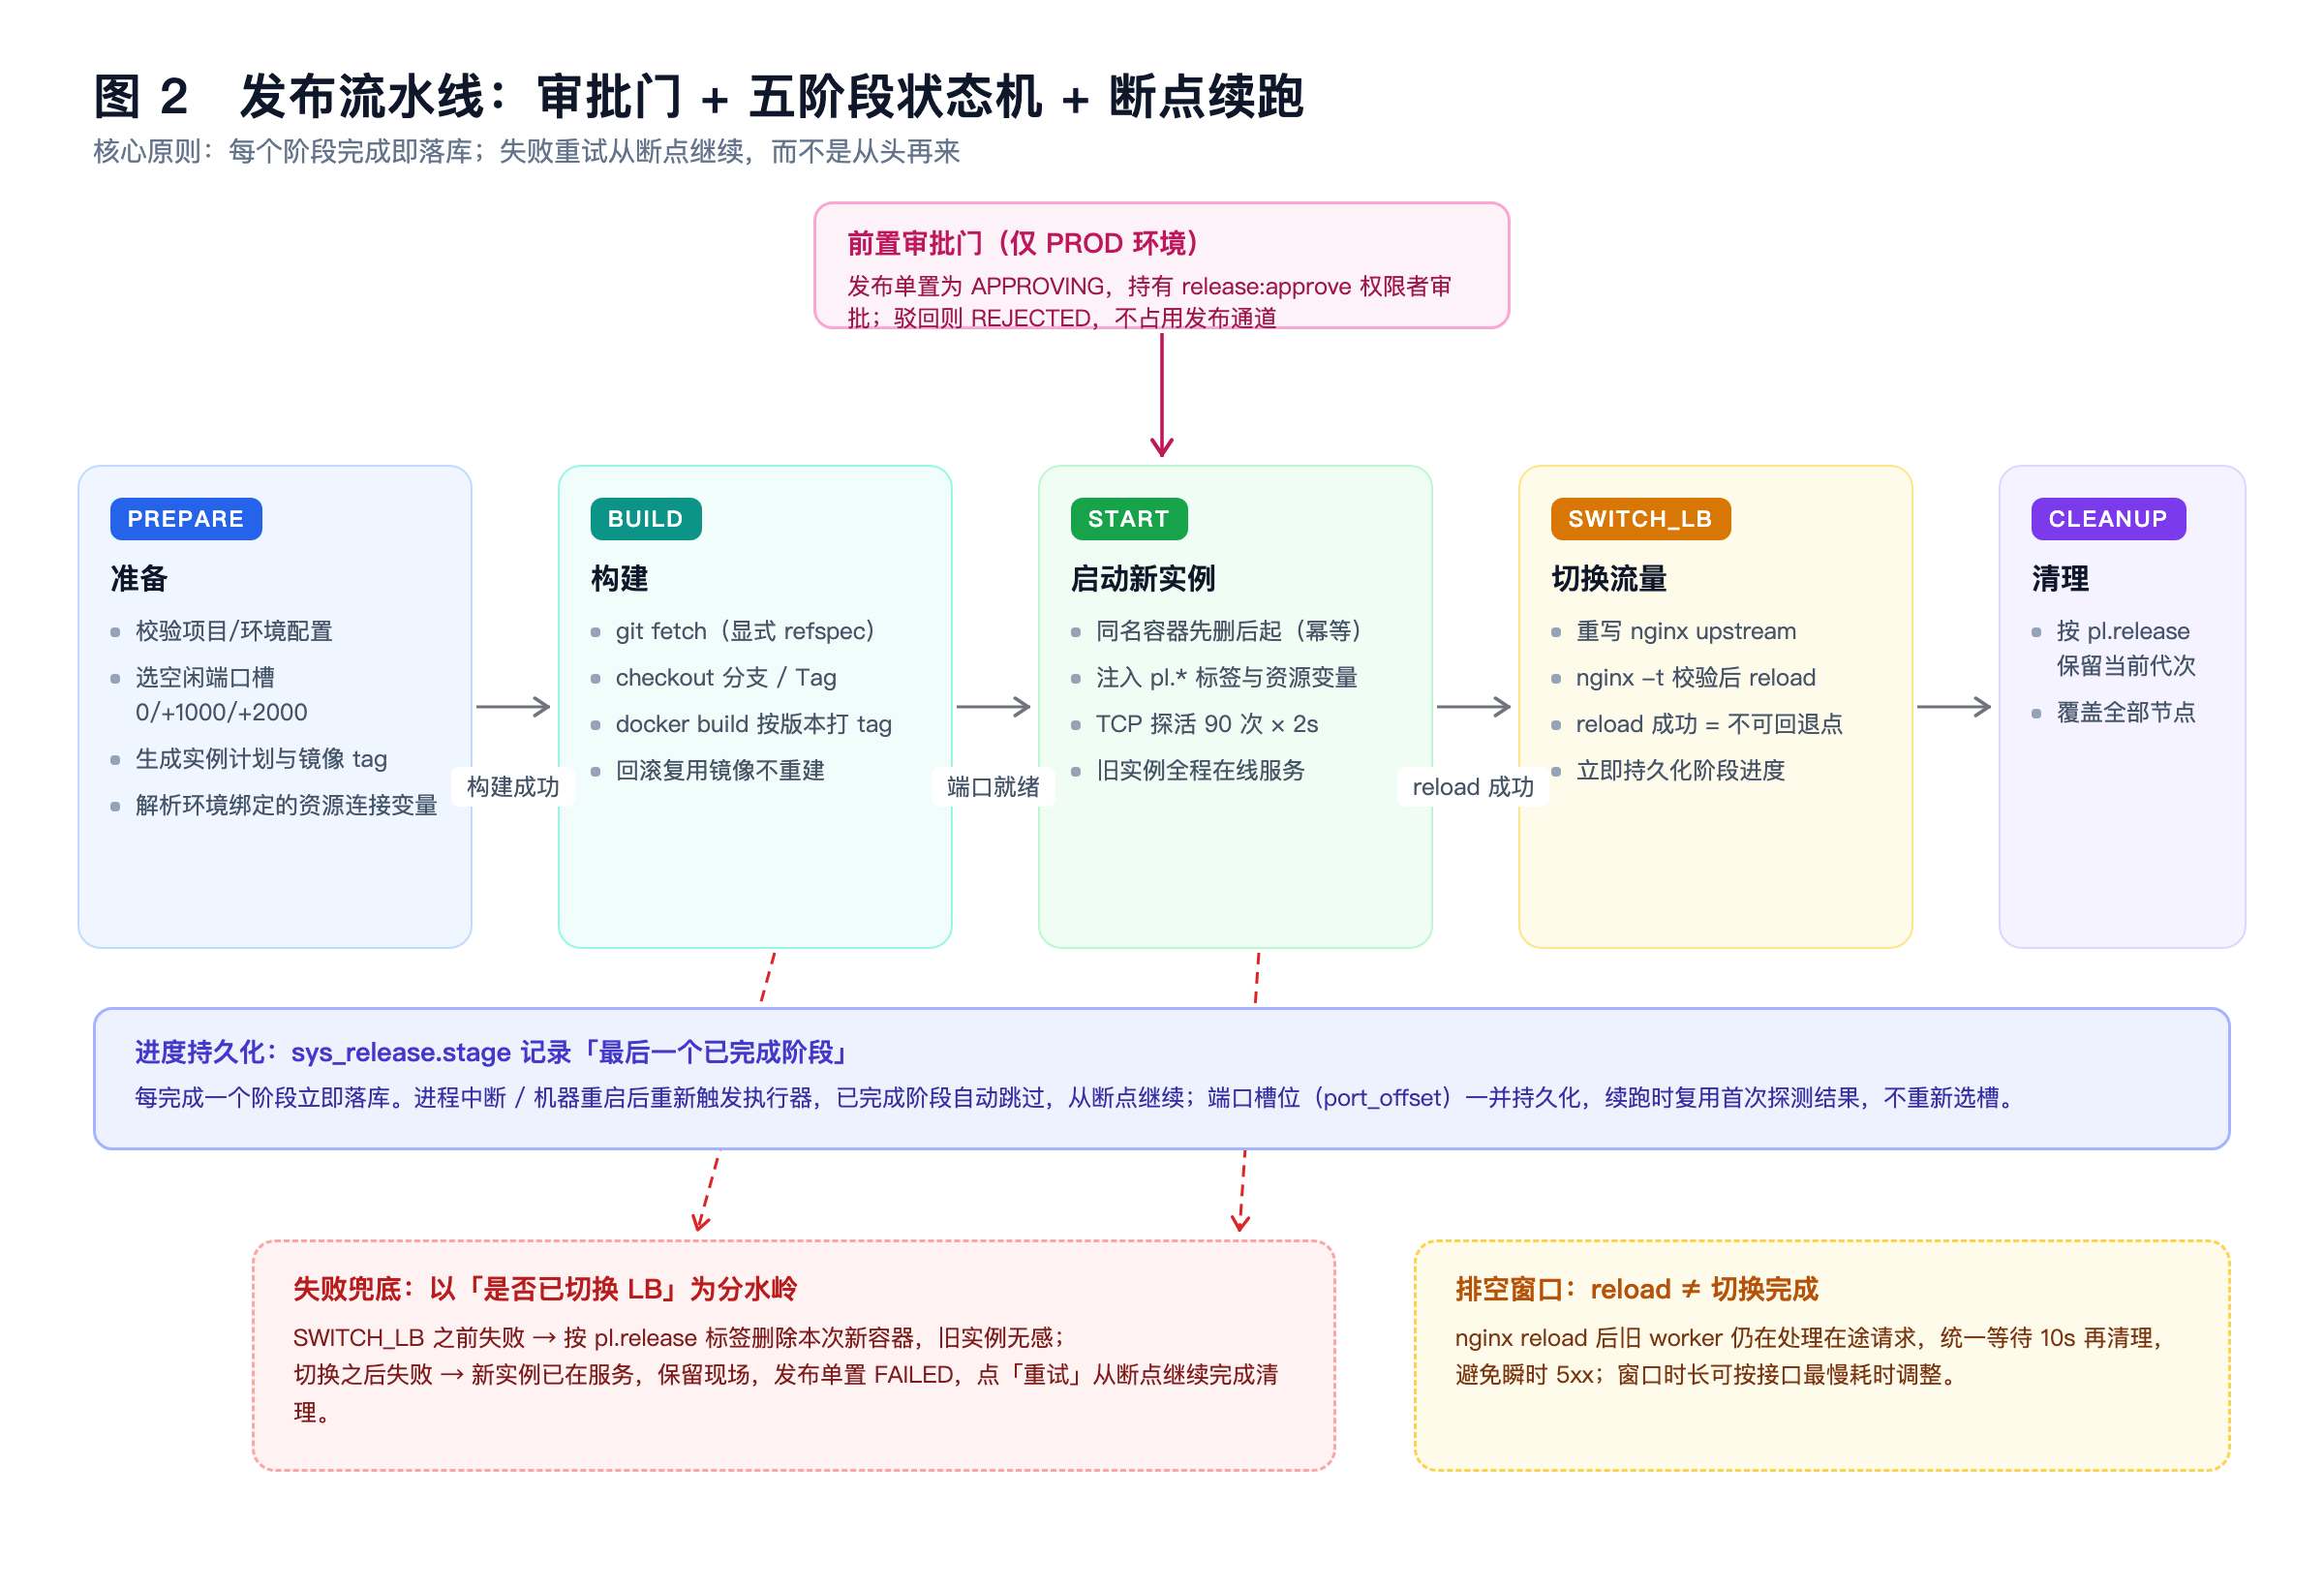
这是本次最核心的改动。V1 的问题是典型的"长方法":四个阶段、十几个 Shell 脚本生成方法、错误处理全部串在一个 run() 里,改任何一处都要通读 558 行。先看重构后的全貌:
第一步:把"阶段"变成一等公民
public enum DeployStage {
PREPARE, // 校验配置、选端口槽位、生成实例计划
BUILD, // 逐台服务器拉取代码并构建镜像
START, // 启动新实例并等待端口就绪(旧实例仍在服务)
SWITCH_LB, // 切换 Nginx upstream 指向新实例
CLEANUP, // 清理旧实例与旧网关上的负载均衡容器
DONE; // 成功终态标记
/** 判断「已完成阶段」是否已推进到指定阶段(含) */
public static boolean completedAtLeast(String completed, DeployStage stage) {
return completed != null && valueOf(completed).ordinal() >= stage.ordinal();
}
}枚举顺序即执行顺序。配套一个 DeployStageHandler 接口,每个阶段一个 @Component:
public interface DeployStageHandler {
    DeployStage stage();
    void execute(DeployContext ctx) throws Exception;
}
编排器缩到了 129 行,职责只剩一件事——按顺序驱动 Stage 链,并跳过已完成阶段:
public void run(Long releaseId) {
    ...
    String completed = release.getStage();
    if (completed == null || DeployStage.DONE.name().equals(completed)) {
        ctx.log().line("开始发布 ...");
    } else {
        ctx.log().line("断点续跑:阶段 " + completed + " 已完成,从 "
                + DeployStage.valueOf(completed).next() + " 继续");
    }
    for (DeployStageHandler handler : handlers) {
        if (DeployStage.completedAtLeast(release.getStage(), handler.stage())) {
            continue;   // 断点续跑:已完成阶段直接跳过
        }
        handler.execute(ctx);
        ctx.markCompleted(handler.stage());   // 每阶段完成即落库
    }
    ...
}
第二步:断点续跑的两个必要条件
光有"跳过已完成阶段"不够,还差两块拼图:
其一,进度必须持久化。 sys_release 新增 stage 列记录"最后一个已完成阶段"(Flyway V13),markCompleted 在每个阶段结束后立即落库。进程被杀、机器重启,重新触发执行器即可继续。
其二,PREPARE 的产物必须可复现。 端口槽位是发布开始时探测选出来的,如果断点续跑时重新探测,新实例可能已占用端口,会选出不同的槽位——整个实例计划就错位了。所以槽位随阶段一起持久化,续跑时直接复用:
// 断点续跑必须复用首次发布选定的槽位:此时新实例可能已占用端口,重新探测会得到不同结果
Integer persistedOffset = release.getPortOffset();
int slotOffset = persistedOffset != null
        ? persistedOffset
        : choosePortOffset(servers, basePort, replicas);
第三步:把"不可回退点"显式写出来
蓝绿发布里有一个关键的语义分界:nginx reload 成功之前失败,可以删新实例退回去;之后失败,新实例已在服务,只能保留。V1 里这个分界是一个局部布尔变量,V2 把它变成了状态的函数——SWITCH_LB 阶段完成的瞬间就是不可回退点:
// SWITCH_LB 阶段
SshService.CommandResult lbResult = sshService.execute(gateway,
        scripts.wrap(scripts.lbScript(...)), COMMAND_TIMEOUT_MS, ctx.log()::append);
if (lbResult.exitStatus() != 0) {
    throw new BusinessException("切换负载均衡失败,旧实例仍在提供服务");
}
// reload 已成功:即使后续中断/失败,也不能再清理新实例,必须先落库阶段进度
ctx.markCompleted(stage());
Thread.sleep(OLD_INSTANCE_DRAIN_MS); // 10 秒排空在途请求注意顺序:先 markCompleted,再 sleep 排空。如果反过来,排空期间进程被杀,重启后状态机认为 SWITCH_LB 未完成,失败处理会删掉已经在接流量的新实例——这是会用事故换来的顺序错误。
失败处理也相应变成状态驱动:
if (!ctx.lbSwitched() && ...) {   // lbSwitched() = completedAtLeast(stage, SWITCH_LB)
    // 删除本次启动的新实例,旧实例继续服务
}
release.setStatus("FAILED");
// 阶段进度保留在失败阶段,供重试续跑这也解释了前端"重试"按钮的语义:不是重新发布,而是从断点继续。比如失败在 CLEANUP(危害最小的一步),重试只要几秒钟。
3.3 PROD 审批流:不占用发布通道的等待
生产发布最大的流程风险是"单人即可触发"。V2 在状态机前面加了一道审批门(Flyway V12):
非 PROD 环境:直接进入流水线;
PROD 环境:发布单置为
APPROVING——注意它不进入 RUNNING,也就不占用"环境有发布进行中"的互斥锁,DEV/TEST 的发布不受影响;持有
release:approve权限的人审批通过 → 转入执行;驳回 →REJECTED,审批人、时间、意见全部落库并进审计。
设计上的取舍:审批不做多级会签(小团队没这个场景),但审批记录是完整的——谁批的、什么时候、写了什么意见,审计切面都留痕。
3.4 发布日志:从 1 秒轮询到 WebSocket 推送
V1 的发布日志靠前端每秒拉一次 HTTP。V2 换成推送,核心是一个 ReleaseLogBroadcaster:
/** 推送在独立线程串行执行,避免慢客户端阻塞发布执行线程 */
private final ExecutorService sender = Executors.newSingleThreadExecutor(runnable -> {
Thread thread = new Thread(runnable, "release-log-push");
thread.setDaemon(true);
return thread;
});
public void publishLog(Long releaseId, String log) {
Map<String, Object> payload = Map.of("type", "log", "log", log == null ? "" : log);
broadcast(releaseId, payload);
}
public void publishState(Long releaseId, String status, String currentStep, String stage) {
// type=state:前端刷新状态标签与阶段时间线
broadcast(releaseId, Map.of("type", "state", "status", status, ...));
}三个设计点:
两种消息类型:
log(日志全文)与state(状态 + 当前步骤 + 阶段进度),前端拿到state就能驱动阶段时间线动画;单线程串行发送:发布执行线程只负责把日志丢进队列,慢客户端不会拖慢发布;
建连下发快照:连接建立时先推一次当前状态与全量日志,前端无需先 HTTP 再 WS 拼接。
鉴权是最容易漏的部分。 WebSocket 升级不走 HTTP 过滤器,所以握手拦截器做了三层校验:JWT 有效 → 有 release:view 权限 → 该发布单在当前用户数据范围内(复用 HTTP 日志接口同一个校验方法):
// 复用 HTTP 日志接口的数据范围校验,越权访问直接拒绝
try {
    deployService.log(releaseId, user.id());
} catch (Exception e) {
    response.setStatusCode(HttpStatus.FORBIDDEN);
    return false;
}
没有第三层的话,一个只有 SELF 范围的用户拿到别人的 releaseId 就能订阅别人的发布日志——WS 鉴权只对齐权限点而不对齐数据范围,是这类功能最常见的漏洞。
3.5 资源中心:让中间件成为"一等资源"
V1 只管服务器,但一次发布真正依赖的还有 MySQL 和 Redis——连接串散在各环境的部署脚本里,改密码要登机器。V2 的资源中心分三层:
登记层:sys_resource 纳管 MySQL/Redis 实例(密码 AES-GCM 加密),sys_env_resource 把资源绑定到项目环境,绑定时的 alias 就是环境变量前缀(如 MYSQL)。
注入层:PREPARE 阶段解析环境绑定的资源,生成连接变量,启动实例时注入容器——发布时自动带上数据库连接,业务镜像无需硬编码配置:
ctx.resourceEnv(resourceService.envVariables(env.getId()));
// 日志:注入资源连接环境变量:MYSQL_HOST、MYSQL_PORT、MYSQL_USERNAME ...采集层:ResourceClient 按配置现建连接、用完即关——不为动态资源维护连接池(资源数量少、采集频率低,连接池反而是负担)。连接与读写均设超时,防止一台挂掉的资源拖死整个采集任务。
最有价值的是 MySQL 慢 SQL 诊断,数据源是 performance_schema.events_statements_summary_by_digest:
SELECT d.SCHEMA_NAME, d.DIGEST_TEXT, d.COUNT_STAR, d.AVG_TIMER_WAIT, ...
  (SELECT h.SQL_TEXT FROM performance_schema.events_statements_history_long h
    WHERE h.DIGEST = d.DIGEST ORDER BY h.TIMER_WAIT DESC LIMIT 1) AS SAMPLE_SQL
FROM performance_schema.events_statements_summary_by_digest d
WHERE d.SCHEMA_NAME NOT IN ('mysql','performance_schema','information_schema','sys')
ORDER BY d.SUM_TIMER_WAIT DESC LIMIT 50
两个细节:
采集前先尝试开启
events_statements_history_long消费者,才能拿到带真实参数的 SQL 样本;账号无权限时静默降级为只展示归一化摘要——降级路径不抛错、不阻塞;摘要语句含
...占位符无法直接 EXPLAIN,诊断接口会明确提示"请使用实际执行 SQL",而不是抛一个晦涩的 SQL 错误。
3.6 监控升级:ShedLock、历史采样与告警外发
三个互相独立的增强,凑成完整的可观测闭环:
ShedLock 防重复采集。 平台以后要多实例部署,@Scheduled 会在每个实例都跑一遍,SSH 探测和指标采集全部翻倍。ShedLock 用 Redis 锁保证同一时刻只有一个实例执行:
@Scheduled(initialDelayString = "${pl.monitor.initial-delay-ms:15000}",
        fixedDelayString = "${pl.monitor.interval-ms:30000}")
@SchedulerLock(name = "monitor-collect", lockAtMostFor = "PT10M", lockAtLeastFor = "PT10S")
public void scheduledCollect() { ... }
历史采样回答"上周怎么样"。 sys_monitor_metric 每 5 分钟为运行中实例落一条采样(CPU/内存/重启次数),保留 7 天,过期由采集任务自动清理。没有历史数据,监控只能回答"现在挂没挂";有了它才能回答"内存是从什么时候开始涨的"。
告警外发 + 去重窗口。 实例异常时推送到飞书/企微群机器人(按 URL 自动识别两家消息格式),去重靠 Redis SETNX:
boolean isDuplicated(String dedupKey) {
    Boolean first = redisTemplate.opsForValue().setIfAbsent(dedupKey, "1", dedupWindow);
    return Boolean.FALSE.equals(first);
}去重的降级策略与登录计数相反,值得对照着记:登录锁定 Redis 挂了要"放行"(可用性优先),告警去重 Redis 挂了要"直发"(宁可重发不可漏发)。同样是降级,方向取决于业务上哪个错误代价更大。
3.7 质量护栏:单测 + CI
767 行测试覆盖了四个高危纯逻辑区:
CI 用本地 GitLab Runner(docker executor),两个 job:后端 mvn verify(阿里云 Maven 镜像 + 仓库缓存),前端 npm ci && npm run build(产物做 1 天 artifact):
backend-test:
  stage: backend
  image: maven:3.9-eclipse-temurin-17
  script: cd backend && mvn -B -s ../.m2/settings.xml verify
护栏的意义不在当下,而在"下次改 choosePortOffset 时,有没有东西拦住你把 contains(":" + port + "->") 改错"。
3.8 前端配套
前端配合后端改了三处:
阶段时间线组件:根据
stage字段推算每个阶段的状态(已完成 / 执行中 / 待执行,失败时首个未完成阶段标红),接 WSstate消息驱动;WS 接入策略:首屏用 HTTP 拉全量日志,进行中的发布再切 WebSocket 收推送——历史数据走 HTTP 的缓存与重试能力,增量走推送,两头都不浪费;
重试确认:
确定重试 #N 吗?将从已完成阶段之后继续执行——把断点续跑的语义直接告诉操作者。
四、结果如何
4.1 发布链路
发布单累计 27 条,PROD 环境审批流已实际拦截过发布(列表中可见"已驳回"记录,审批人/意见落库);
失败发布单的重试按钮已可用,从失败阶段断点续跑;
阶段时间线随 WS 推送实时推进,日志抽屉打开即见、无需轮询;
蓝绿切换的核心指标保持 V1 水平:切换期间 0.3s 间隔连续探测 278 次全部 200。
4.2 数据库可观测性
资源中心已纳管平台自身依赖的 MySQL 与 Redis(吃自己狗粮):
MySQL 指标 5 分钟采样、24 小时趋势正常出图(连接数 9/151、缓冲池命中率 100%);
慢 SQL 汇总按 10 分钟一轮从
performance_schema抓取,实际样本 SQL 与 EXPLAIN 诊断可用;资源健康状态随每轮采集刷新,页面显示在线状态与最近探测时间。
4.3 工程质量
后端测试 5 类 767 行,
mvn verify在 CI 上跑通;发布引擎主类从 558 行降到 129 行,7 个 Stage/支撑类各自 40–180 行;
Flyway 从 V10 推进到 V18,八次结构演进全程零手工 DDL。
4.4 一个真实的回归场景
断点续跑上线后第一次派上用场:一次 PROD 发布在 BUILD 阶段因镜像仓库超时失败,按 V1 的流程要整单重来(重新选槽、重新构建、重新起实例);V2 点重试,日志打出"断点续跑:阶段 PREPARE 已完成,从 BUILD 继续",复用已持久化的端口槽位与实例计划,直接从构建继续。
五、下一步建议
这版做完,我认为优先级排序是这样的:
构建一次、处处分发。现在仍是逐台服务器各自
docker build。引入 Registry(Harbor 或registry:2)后构建一次 push、各节点 pull,N 台机器的发布时间从 O(N×构建时长) 降到 O(1×构建时长 + N×拉取时长),顺带消灭节点间产物不一致的可能。断点续跑的状态机已经就位,加上 Registry 后 BUILD 阶段甚至可以拆成"构建"和"分发"两段。告警规则可配置化。目前 CPU/内存阈值内置在采集器里,建议落库到环境维度,让每个项目自己定阈值——不同业务的合理水位差别很大。
慢 SQL 诊断接 LLM。
digest + 执行计划 + 统计信息已经齐了,接一个大模型 API 做"人话版诊断"成本很低,这恰好也是我正在积累的 Agent 方向的练手场景。发布日志结构化。现在日志是整段文本落库推送,若按阶段/行级结构化存储,前端可以做按阶段折叠、耗时统计,断点续跑的展示也会更精确。
前端 TypeScript 化。后端 DTO 已经很规整,照着补 interface 的成本低,收益在发布中心这种状态多的页面尤其明显。
六、结语
V1 解决的是"发布不出事":零停机、可回滚、可审计。V2 解决的是"平台自己的工程问题":
巨石类 → 状态机:558 行变 129 行编排器 + 5 个阶段类,断点续跑把"失败重试"从人工操作变成了产品能力;
轮询 → 推送:发布日志与状态变更走 WS,鉴权连数据范围一起校验;
黑盒配置 → 资源中心:中间件成为一等资源,连接参数随发布注入,可观测性延伸到数据库;
裸奔 → 护栏:767 行单测 + CI,高危逻辑改起来不再靠胆量。
如果只留一句经验:
平台演进的顺序,应该是先把"正确性"做成状态机,再把"状态"做成持久化事实——断点续跑、审批、审计这些能力,都只是同一套状态机的不同读法。

