本文是 pl-platform 系列的第四篇。前三篇讲了怎么把发布做出来、做成状态机、做成自愈闭环;这一篇解决的是更靠后的问题——发布单显示 SUCCESS 之后,谁来判断这次发布真的没问题? 全部代码来自真实项目,配图含平台实际运行截图。
一、这是什么
pl-platform 是一套自研的部署运维平台:Spring Boot 3.5 单体 + Vue 3 SPA,通过 SSH 操控目标服务器上的 Docker 与 Nginx,把"拉代码 → 构建 → 起实例 → 切流量 → 清理"收敛成一条六阶段状态机流水线,外加资源中心、监控告警、RBAC 权限与审计。
先交代技术形态,后文不再重复:
前三轮迭代已经解决了"发布本身"的问题:阶段拆分、断点续跑、心跳 + 卡单巡检、队列调度、资源预检。这一轮(V4)把镜头对准了发布之后:
发布成功 ≠ 业务正常。容器起了、探针过了,但 QPS 掉一半、错误率 5%,这种发布在
SUCCESS状态下安静地伤害用户。回滚要靠人盯。半夜出问题,等人看到告警、登平台、点回滚,黄金五分钟已经没了。
所以 V4 的主题是一句话:给发布引擎装一个"验证哨兵",让平台自己判断发布好坏,必要时自己踩回滚。
二、它做什么:这一轮新增的七件事
2.1 发布后验证 + 自动回滚(本次核心)
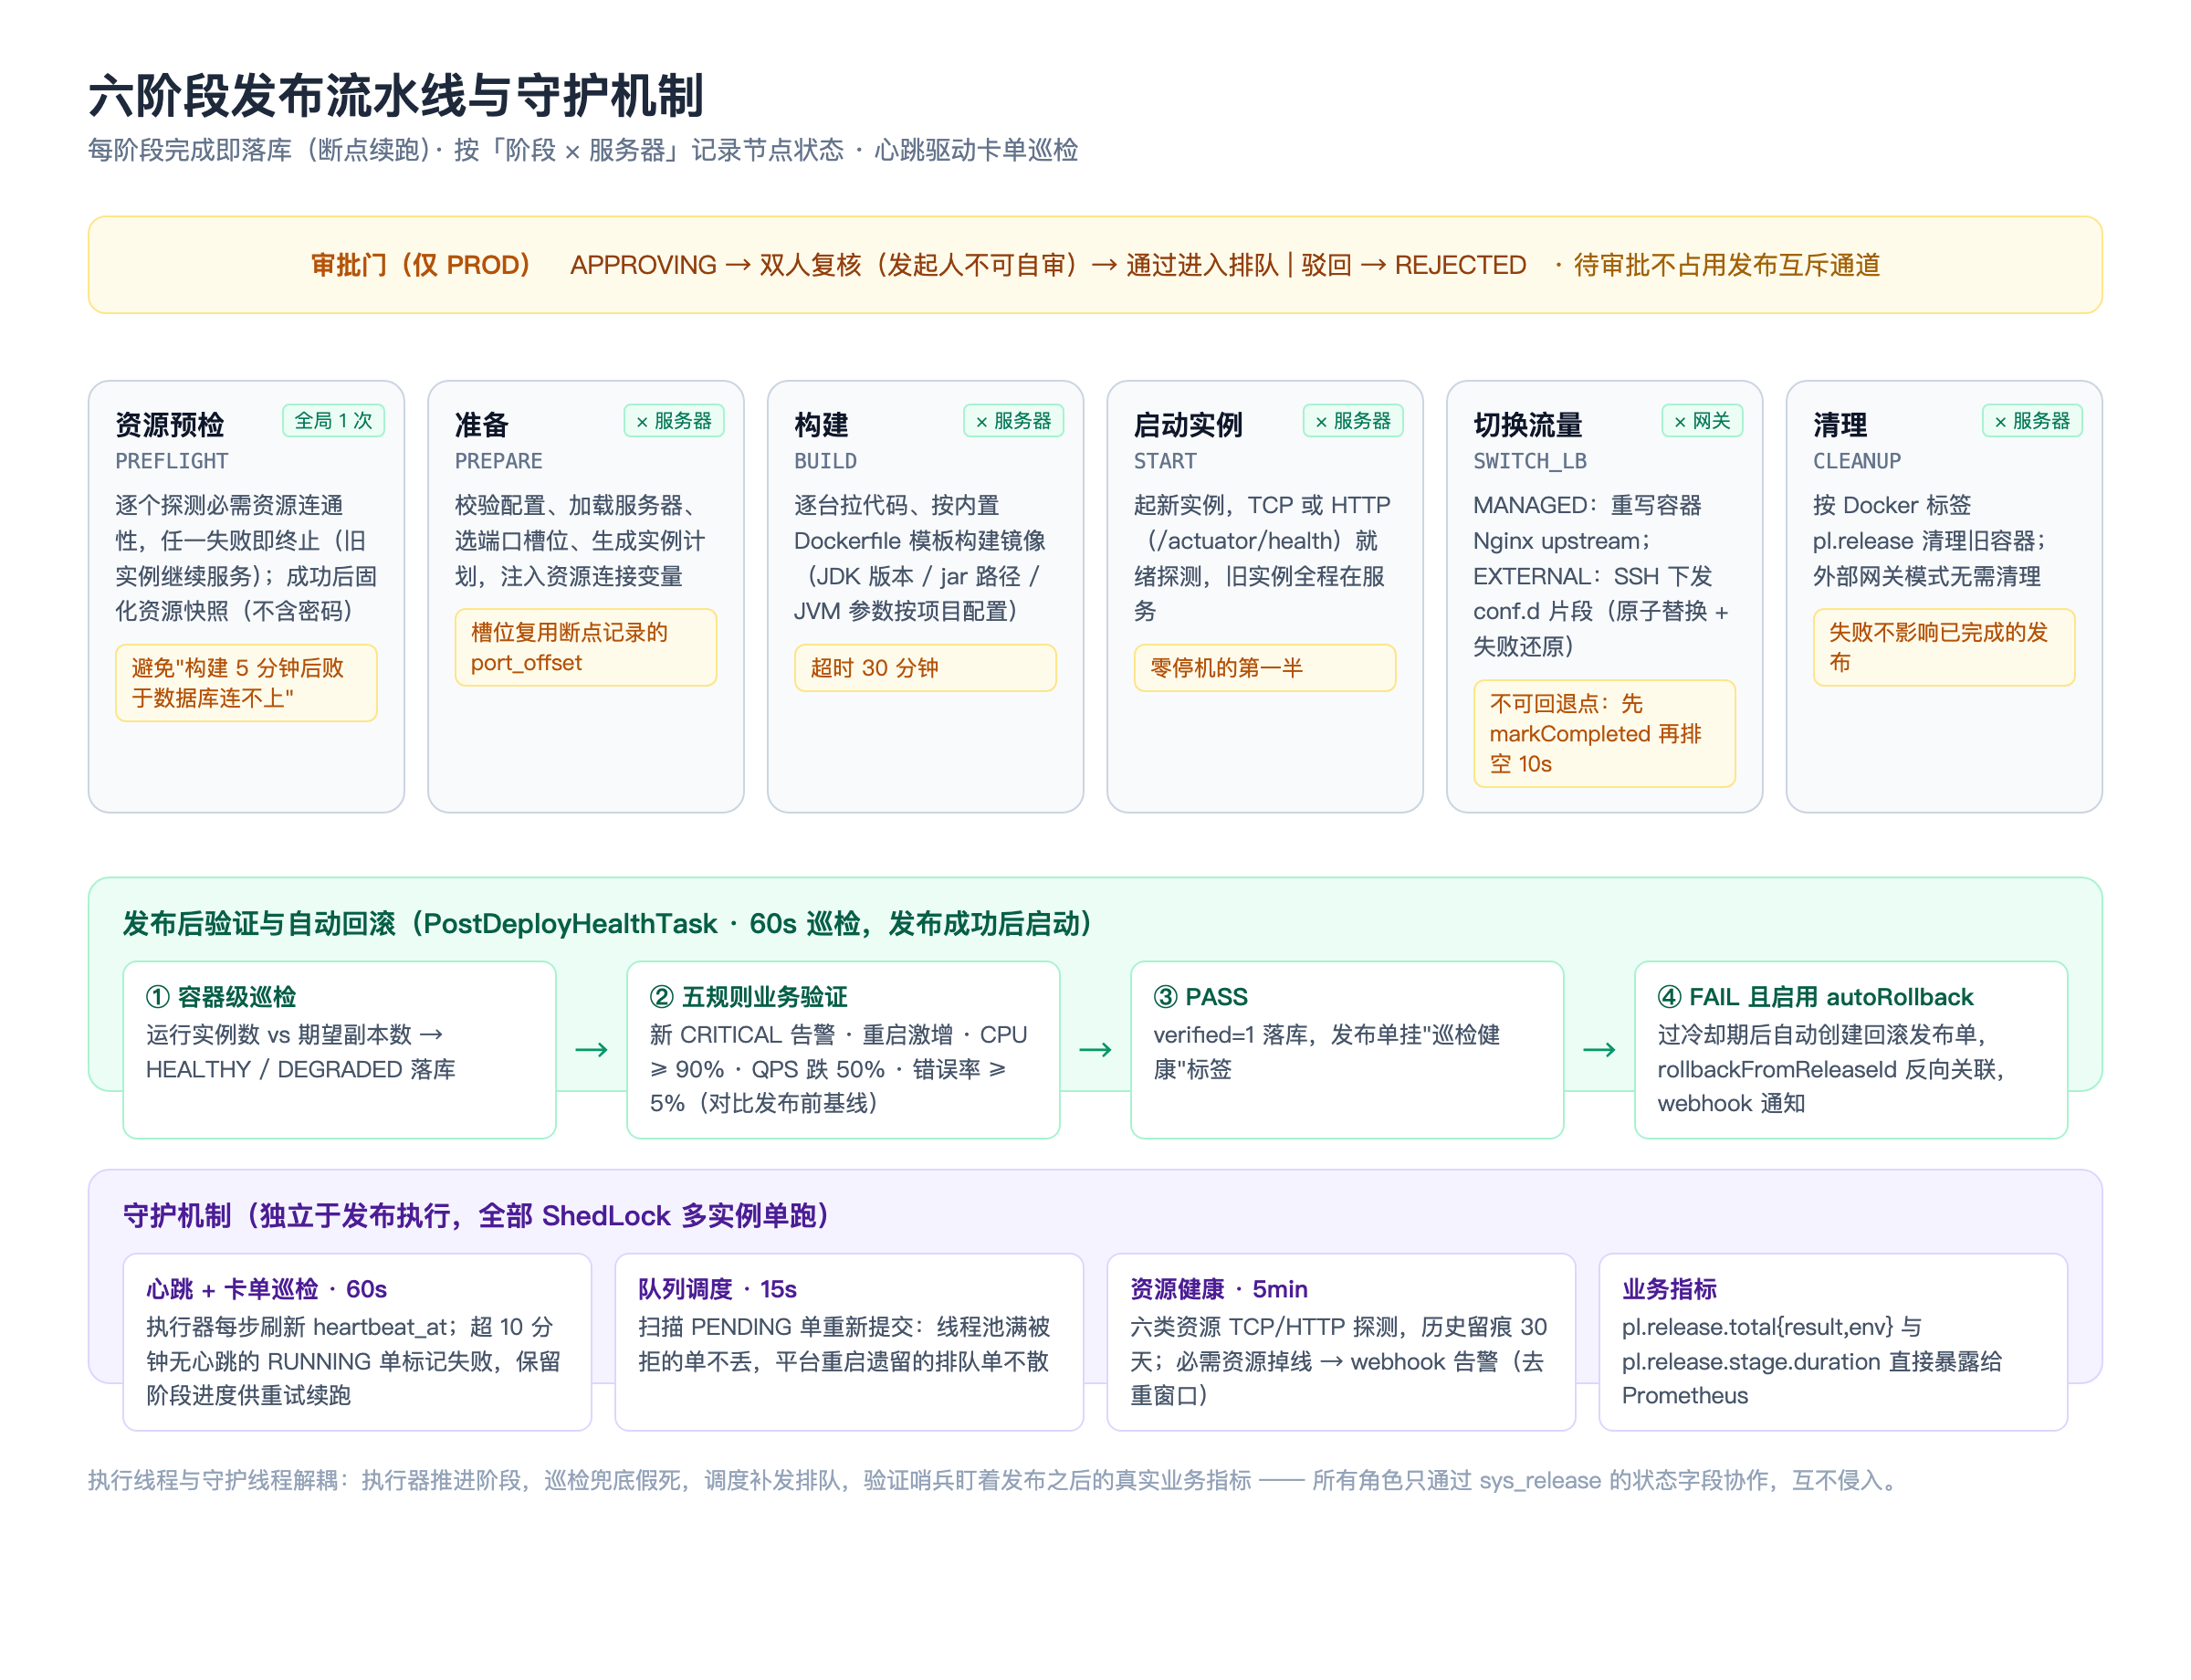
发布单到达 SUCCESS 后,巡检任务每 60 秒扫一次新完成的发布单,做两层检查:
容器级巡检:运行实例数是否达到期望副本数,得出
HEALTHY / DEGRADED;业务指标验证:对比发布前后的监控数据,命中任一规则即判定验证失败:
验证失败且环境启用了 auto_rollback,平台自动创建一张回滚发布单(rollbackFromReleaseId 反向关联来源),并推送告警。回滚有冷却期保护,防止故障未消除时反复抖动。
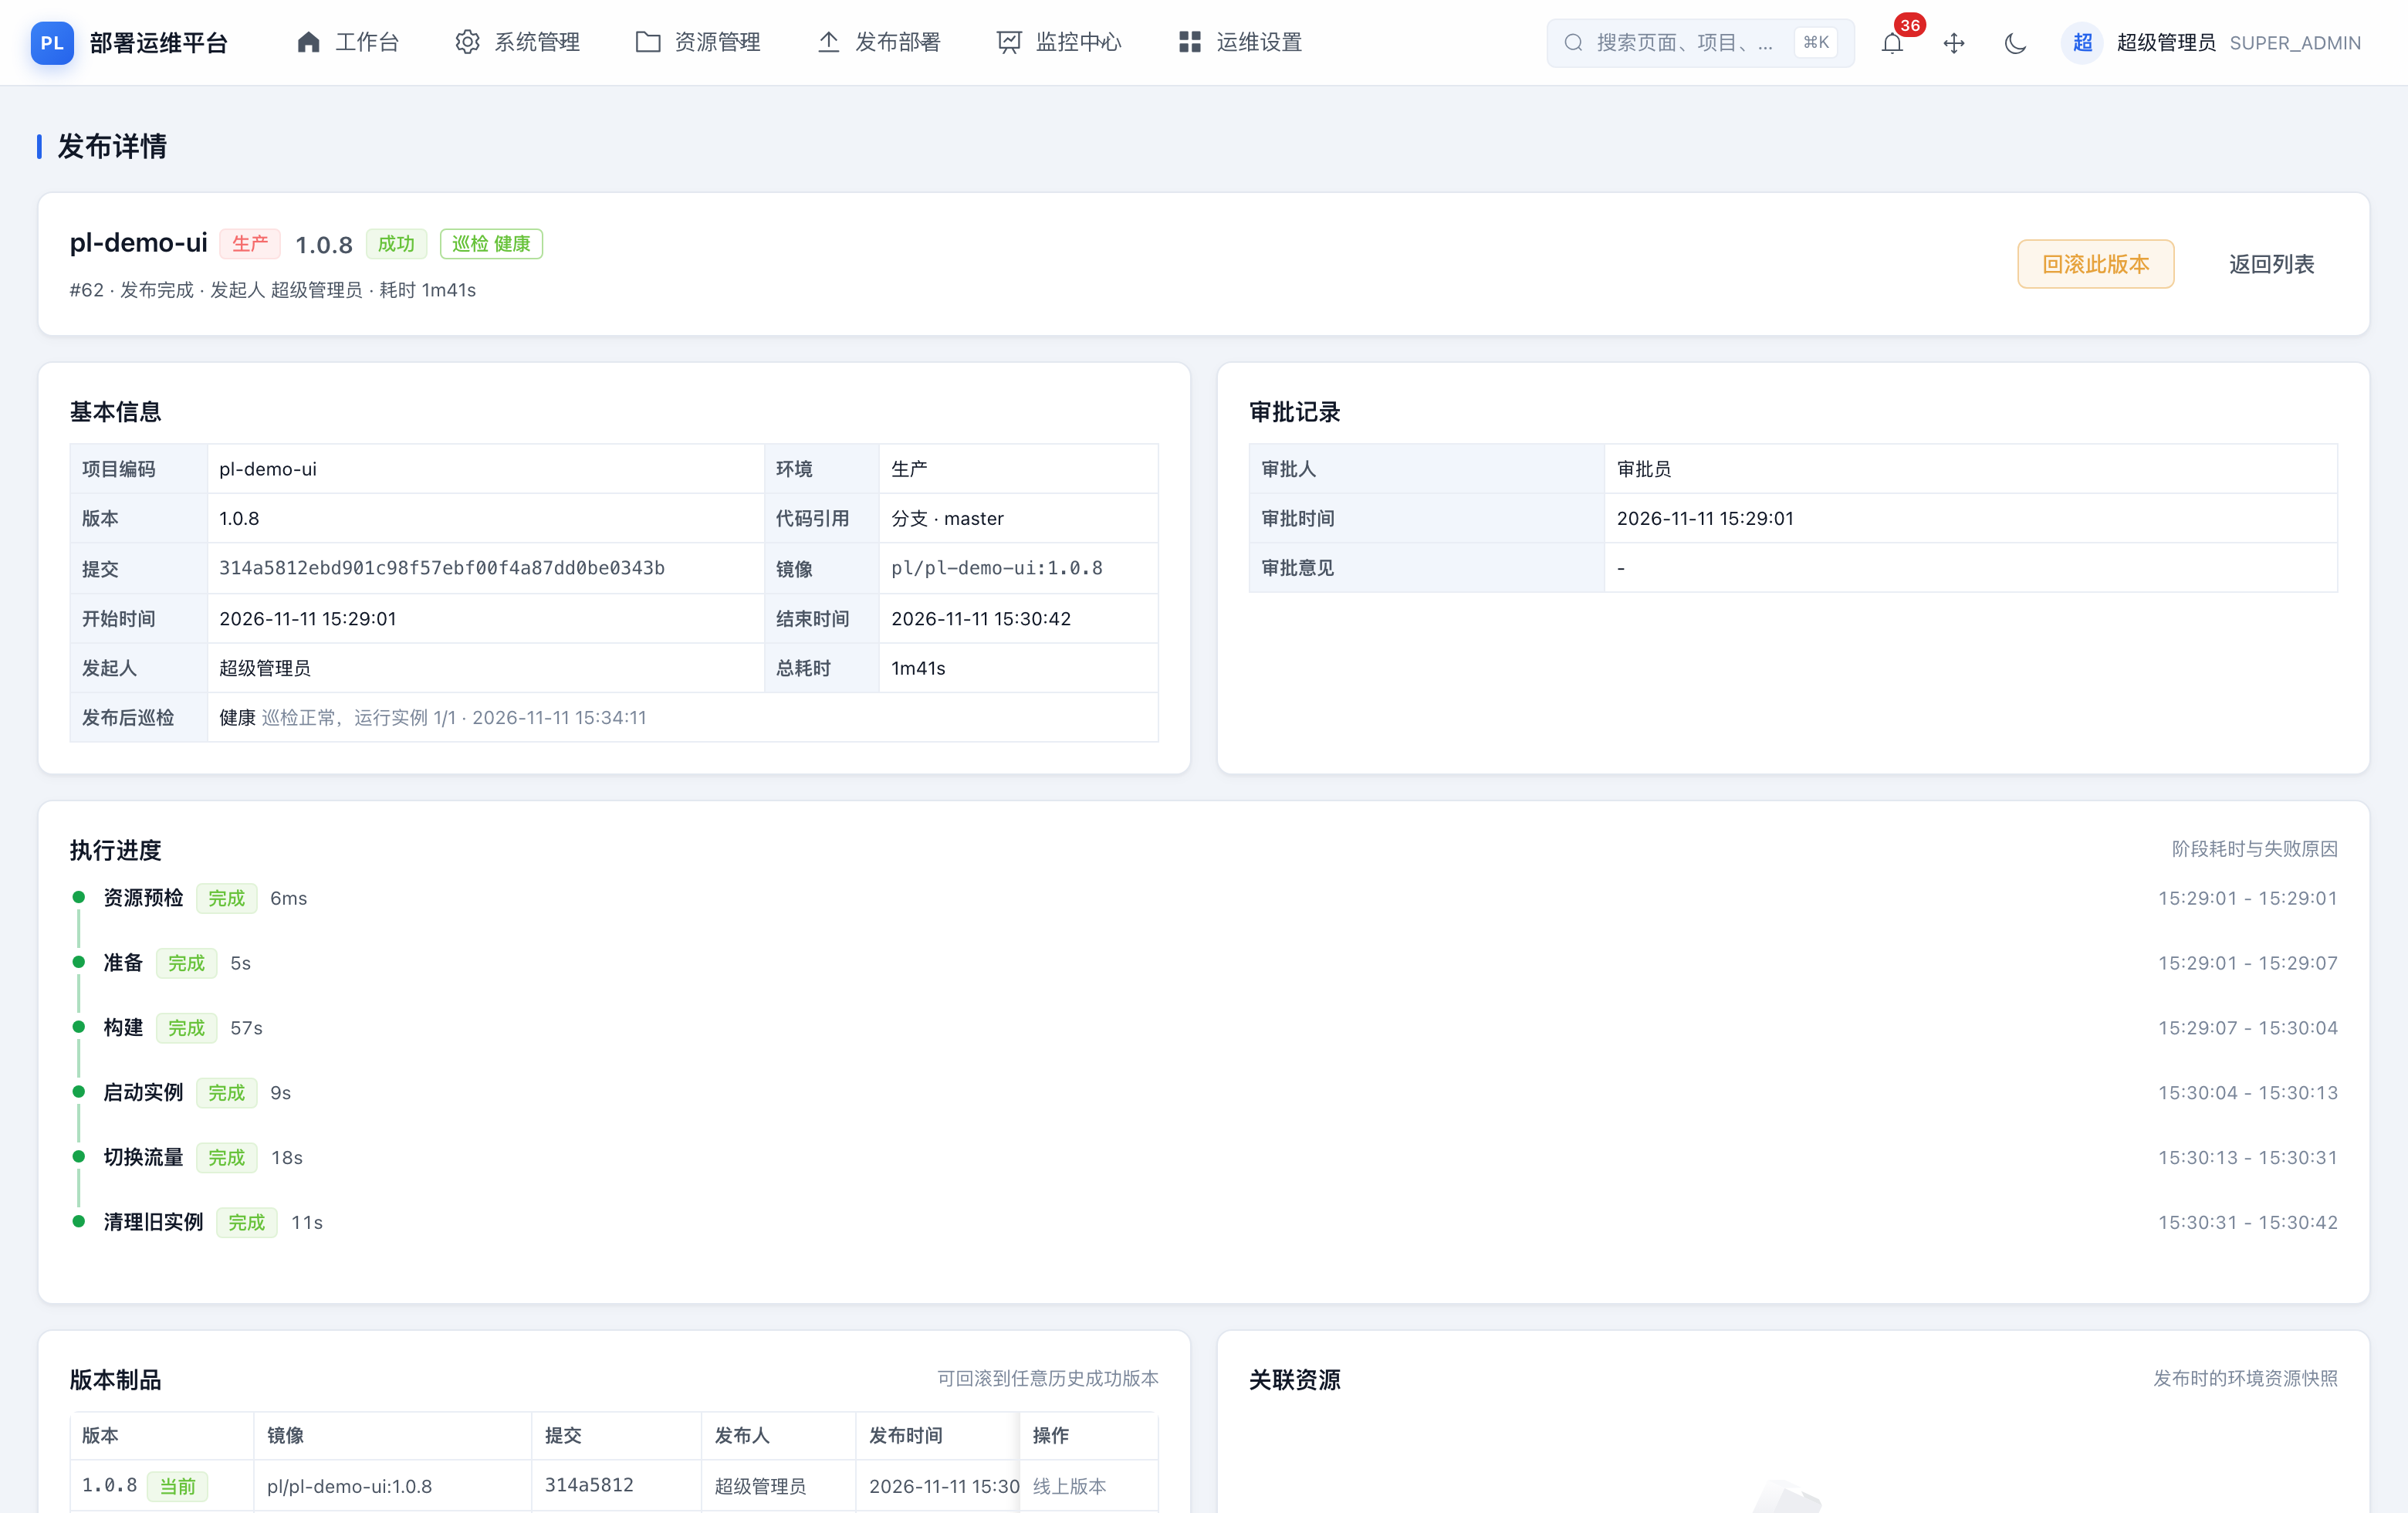
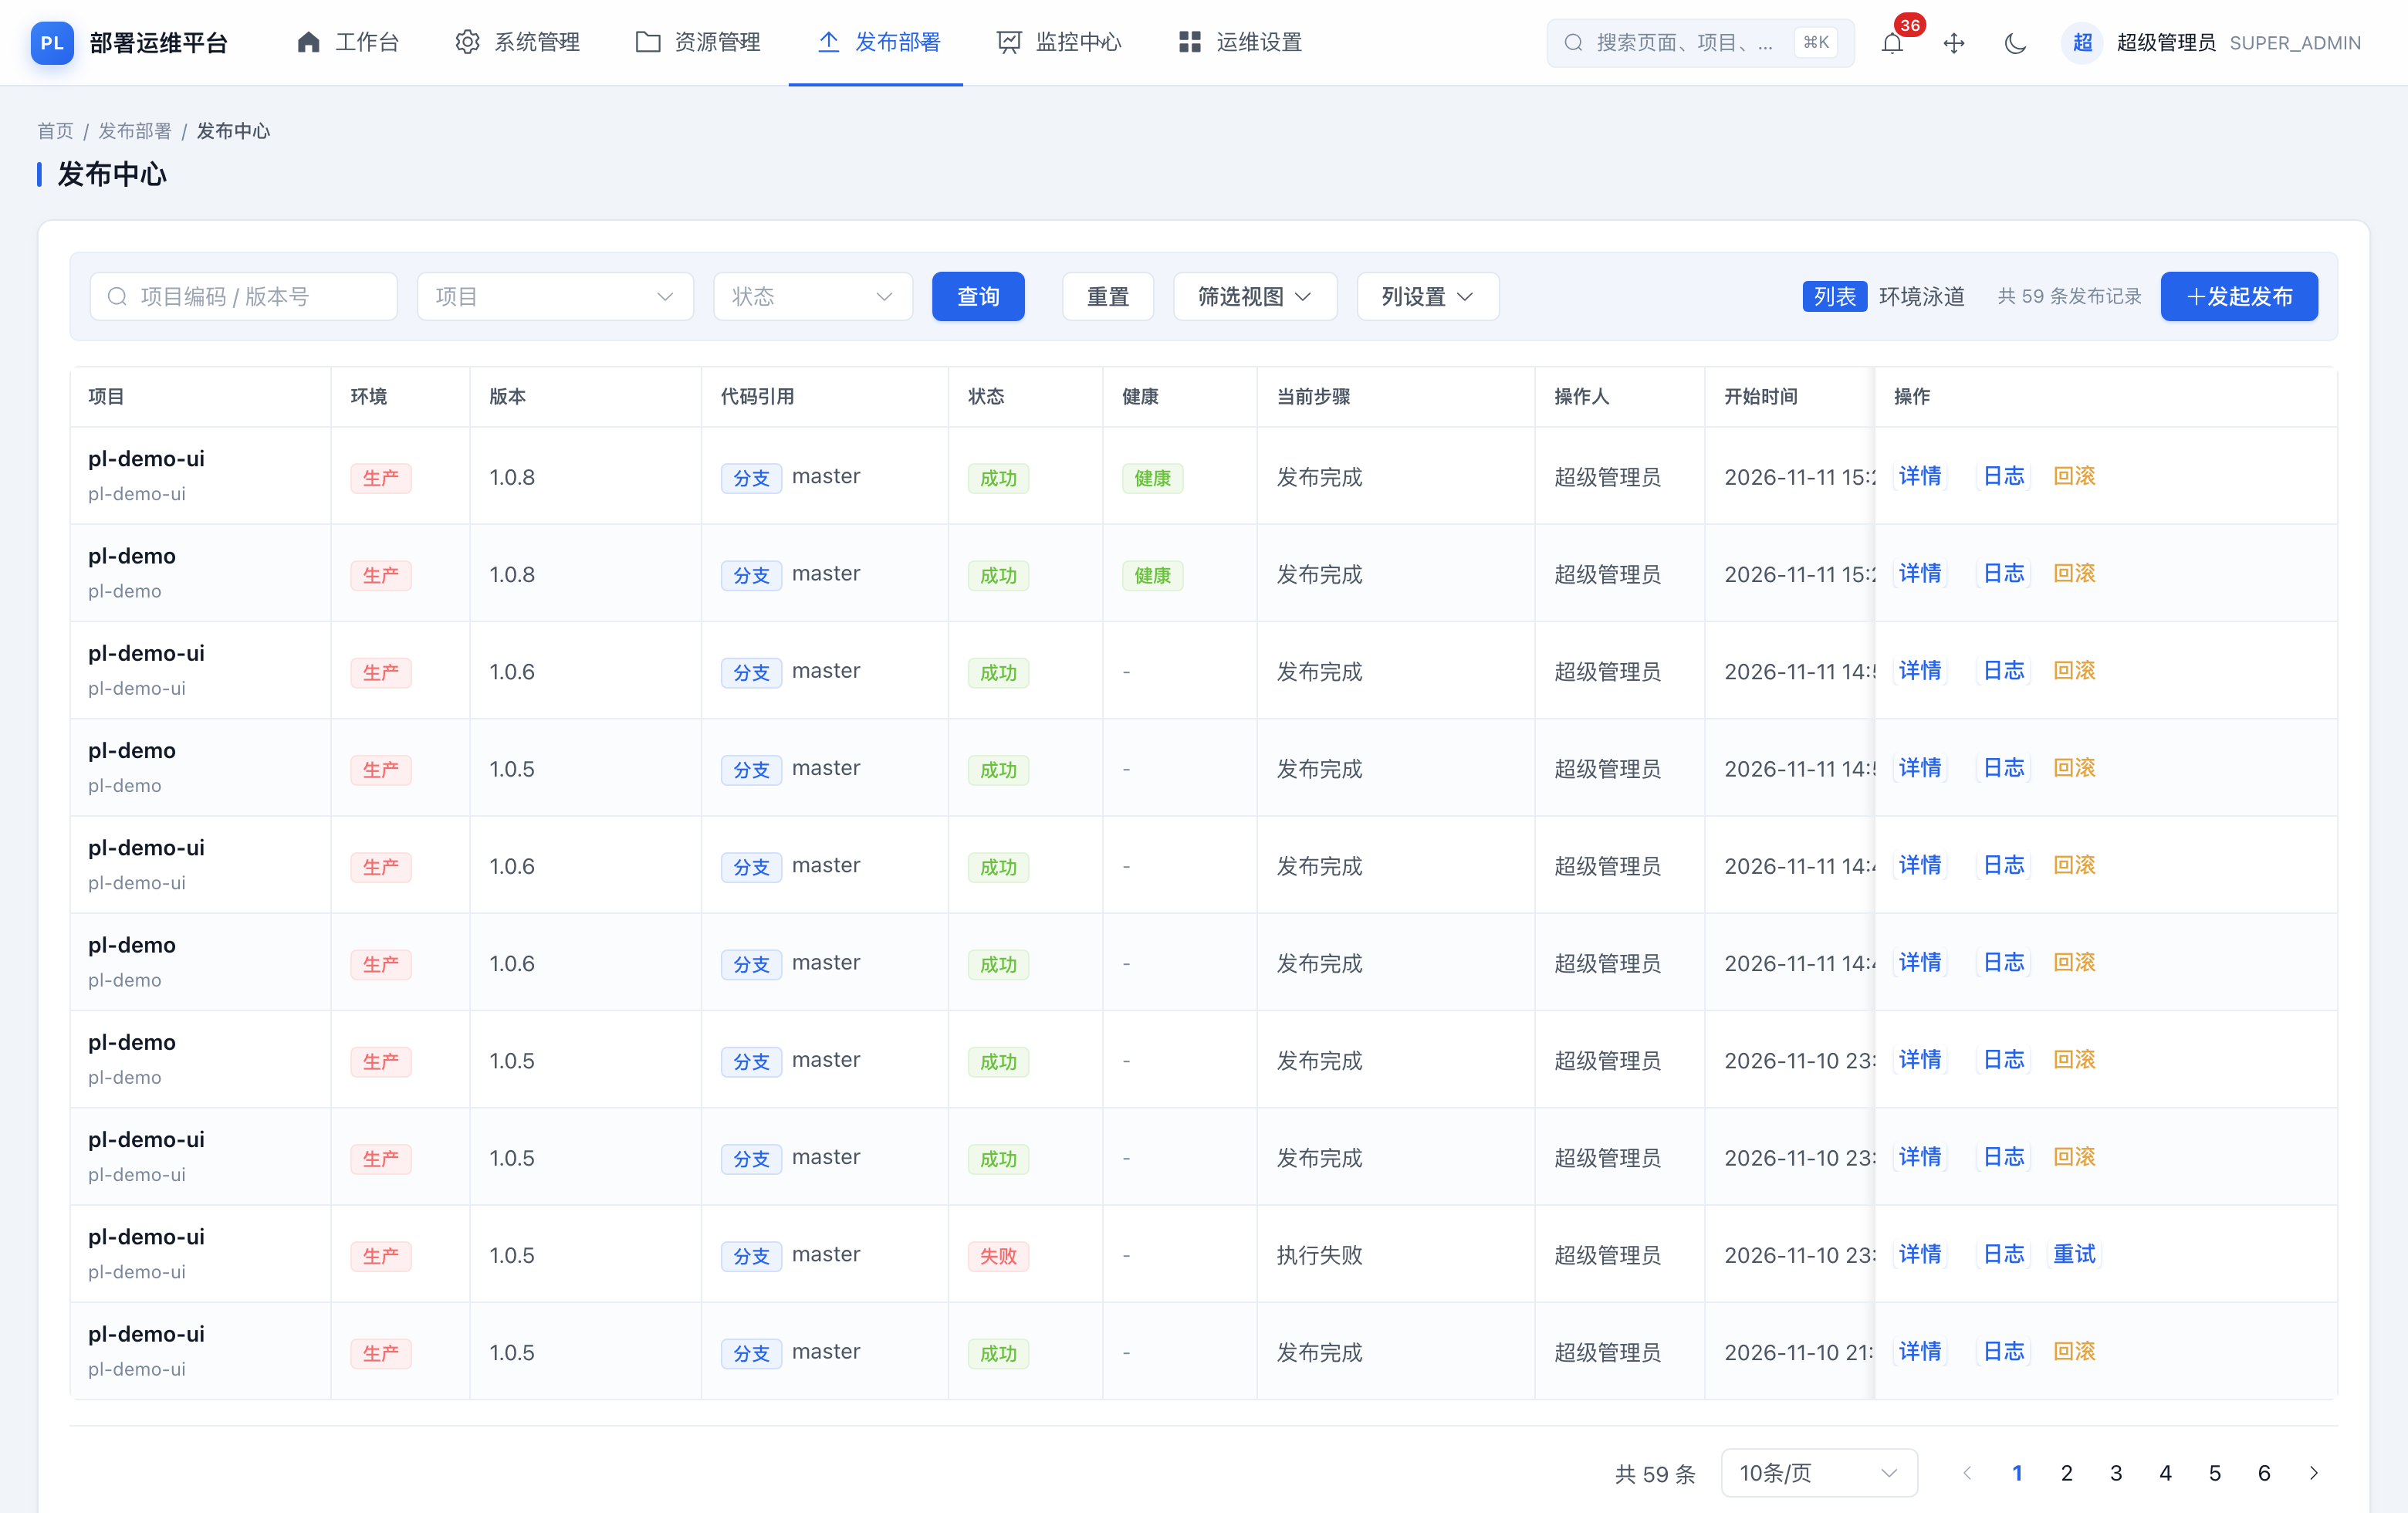
这是平台里真实的一张生产发布单(#62):六阶段逐段耗时(预检 6ms → 准备 5s → 构建 57s → 启动 9s → 切流 18s → 清理 11s,总耗时 1m41s),右上角挂着巡检健康标签——这就是验证哨兵给出的结论。
2.2 发布协作式终止
发布跑到一半发现不对,以前只能等它跑完或杀线程。现在有终止按钮:请求登记进内存注册表,执行器在每个阶段之间检查信号、协作式退出——绝不强杀线程,避免远程容器停在半途状态。已完成阶段不自动回滚,需要回滚走回滚流程。
2.3 发布冻结期
大促、财务结账、重大活动期间,运营一句话:"这几天不许发版。"现在这是一张配置表:指定时间段(可限定环境)内发起发布直接被拒,唯一的例外是持有 release:prod 权限的运维可以强制放行——紧急通道存在,但每一次强制放行都会进审计日志。
2.4 OpenAPI Token
外部 CI(Jenkins/GitLab CI)想触发发布,不再需要人登平台。运维设置页签里创建 API Token,CI 在请求头带 X-API-Token 调用即可。两个设计约束:Token 绑定创建人身份(发布单归属与审计不缺位);生产环境仍然强制走审批流,OpenAPI 直接拒绝 PROD 直发。
2.5 Git 仓库集成
项目可以绑定 Git 仓库资源(GitLab / Gitee 双适配器,SPI 式扩展),平台上直接看分支、提交时间线、提交详情与代码变更。发布单上会记录提交 SHA 与代码引用——"这次发布到底发了哪个 commit"从此有据可查。仓库令牌走 AES-GCM 加密,只用于出站请求,不落日志、不回显。
2.6 告警规则化
以前告警阈值写死在代码里。现在 sys_alert_rule 一张表:告警类型(副本不足 / 服务器不可达 / 重启 / CPU / 内存…)、级别、阈值、持续时长、静默期、通知渠道(平台 / webhook)全部可配。这同时是发布后验证的数据源——验证规则消费的告警,由这套规则产生。
2.7 数据生命周期
审计日志 90 天、发布日志 30 天(只清空日志大字段,发布单记录保留)、资源健康历史 30 天,每天凌晨 3:30 定时清理,ShedLock 防多实例并发跑。单表膨胀的问题在变得疼之前解决。
三、怎么做的:五个值得展开的实现
3.1 验证逻辑:对比窗口,而不是单点快照
发布后验证最容易做错的地方是"只看当下一次采样"。一次发布后 CPU 冲高可能是 JVM 预热,看一眼就判定失败会造成误杀。实现上取发布前 5 分钟与发布后 N 秒(可配,默认 30)两个时间窗,拿窗口均值对比:
// PostDeployVerificationService.java(节选,完整实现五规则见仓库)
public VerificationResult verify(SysRelease release, SysProjectEnv env) {
if (env.getVerifyEnabled() == null || env.getVerifyEnabled() != 1) {
return VerificationResult.skip("环境未启用发布后验证");
}
LocalDateTime publishedAt = release.getFinishedAt() != null
? release.getFinishedAt() : release.getStartedAt();
int wait = env.getVerifyWaitSeconds() != null ? env.getVerifyWaitSeconds() : 30;
LocalDateTime before = publishedAt.minusMinutes(5); // 发布前基线窗口
LocalDateTime after = publishedAt.plusSeconds(wait); // 发布后窗口起点
// 规则 1:发布后出现新的 CRITICAL 告警(未处理)
List<SysMonitorAlert> critical = alertMapper.selectList(...
.eq(SysMonitorAlert::getLevel, "CRITICAL")
.eq(SysMonitorAlert::getHandled, 0)
.ge(SysMonitorAlert::getCreatedAt, publishedAt));
if (!critical.isEmpty()) {
return VerificationResult.fail("发布后出现 " + critical.size() + " 条 CRITICAL 告警");
}
// 规则 4:QPS 骤降 —— 发布后均值 vs 发布前基线,跌幅 ≥ 50%
double beforeQps = beforeMetrics.stream()
.filter(m -> m.getQps() != null)
.mapToDouble(SysMonitorMetric::getQps).average().orElse(0);
double afterQps = afterMetrics.stream()
.filter(m -> m.getQps() != null)
.mapToDouble(SysMonitorMetric::getQps).average().orElse(0);
if (beforeQps > 0 && (beforeQps - afterQps) / beforeQps >= 0.5) {
return VerificationResult.fail("QPS 骤降:发布前 " + beforeQps + " → 发布后 " + afterQps);
}
// ... 规则 2/3/5 同理
return VerificationResult.pass("验证通过:无新 CRITICAL 告警、无频繁重启、CPU/QPS/错误率正常");
}三个设计决定值得说:
返回 PASS / FAIL / SKIP 三态,而不是布尔值。未启用验证、指标数据不足都返回 SKIP,巡检任务对 SKIP 不落
verified字段——下次巡检还会再试,直到过了等待窗口拿到结论。验证是最终一致的,不是一次性的。指标数据缺失自动降级。采集器没接入时只做告警 + 重启两项检查,注释里明说"也能覆盖大部分异常场景"。验证哨兵不能因为数据不全而罢工,也不能因为数据不全而误报。
阈值(CPU 90%、QPS 50%、错误率 5%)目前是代码常量。做成可配是下一步(见文末)。
3.2 自动回滚:冷却期是防抖的关键
自动回滚最可怕的场景是"回滚之后指标还是不好 → 再回滚 → 循环抖动"。实现里用冷却期兜住:
// PostDeployHealthTask.java(节选)
private void triggerAutoRollback(SysRelease release, SysProjectEnv env, String reason) {
// 冷却期保护:最近 N 分钟内已回滚过则跳过
int cooldown = env.getAlertCooldownMinutes() != null ? env.getAlertCooldownMinutes() : 10;
Long recentRollbacks = releaseMapper.selectCount(...
.eq(SysRelease::getRollbackFromReleaseId, release.getId())
.ge(SysRelease::getCreatedAt, LocalDateTime.now().minusMinutes(cooldown)));
if (recentRollbacks != null && recentRollbacks > 0) {
log.info("跳过自动回滚:冷却期内已有回滚 releaseId={}", release.getId());
return;
}
Long rollbackId = deployService.rollback(release.getId(), 0L, "auto");
// rollbackFromReleaseId 反向关联 + webhook 通知 "⚠ 自动回滚已触发"
...
}注意三个细节:
回滚单的操作人是
auto,与人工操作在审计里天然区分;自动回滚还要求容器级巡检是 DEGRADED——业务指标异常 + 实例确实不健康才动手,双条件防误杀;
回滚失败不静默,webhook 直接喊人:"自动回滚失败,请手动处理"。
3.3 冻结期校验:拒绝是默认,放行是特权
// DeployServiceImpl.java(节选)
private void checkFreezeWindow(SysProjectEnv env) {
LocalDateTime now = LocalDateTime.now();
List<SysDeployFreeze> freezes = freezeMapper.selectList(...
.eq(SysDeployFreeze::getEnabled, 1)
.le(SysDeployFreeze::getStartTime, now)
.ge(SysDeployFreeze::getEndTime, now));
SysDeployFreeze hit = freezes.stream()
.filter(f -> "ALL".equalsIgnoreCase(f.getEnv()) || env.getEnv().equalsIgnoreCase(f.getEnv()))
.findFirst().orElse(null);
if (hit == null) return;
if (permChecker.has("release:prod")) {
log.info("发布处于冻结期「{}」,操作人持有生产发布权限,强制放行", hit.getName());
return; // 放行,但上面这行 log 进了审计
}
throw new BusinessException("当前处于发布冻结期「" + hit.getName()
+ "」,如需紧急发布请联系具备生产发布权限的运维");
}发布入口和回滚入口都过这个校验——回滚也是一种变更,冻结期里不该无人看守。
3.4 协作式终止:29 行的注册表
// DeployCancellationRegistry.java(全文)
@Component
public class DeployCancellationRegistry {
private final Set<Long> requested = ConcurrentHashMap.newKeySet();
public void request(Long releaseId) { requested.add(releaseId); }
public boolean isRequested(Long releaseId) { return requested.contains(releaseId); }
/** 发布进入终态后清除信号,避免影响同一发布单的重试 */
public void clear(Long releaseId) { requested.remove(releaseId); }
}执行器在每个阶段之间检查 isRequested(),命中则把单子标为 CANCELLED 并退出。为什么不强杀线程?因为发布线程手里握着远程状态:容器起了、流量切了一半,强杀意味着这些状态没人收尾。协作式终止的代价是"最多等当前阶段跑完"(最长 30 分钟的构建阶段例外——阶段内部有独立超时),换来的是远程状态永远可控。终态时 clear() 很关键:不清的话,同一张单的重试会被上一次的终止信号误杀。
3.5 OpenAPI:Token 鉴权与审批红线
// OpenApiController.java(节选)
@PostMapping("/releases")
public Result<Long> create(@RequestHeader("X-API-Token") String token,
                           @Valid @RequestBody ReleaseCreateRequest request) {
    SysApiToken apiToken = opsService.authenticate(token);
    Long releaseId = deployService.create(request, apiToken.getOperatorId(),
            apiToken.getOperatorName() == null ? "openapi" : apiToken.getOperatorName());
    return Result.success(releaseId);
}
整条链路只有十几行,但两个红线画在了正确的位置:Token 只存在哈希(原文只在创建时返回一次);deployService.create 内部的审批逻辑对 OpenAPI 一视同仁——PROD 环境照旧进 APPROVING 等人审,CI 再急也不能绕过。
3.6 全景:两条回路
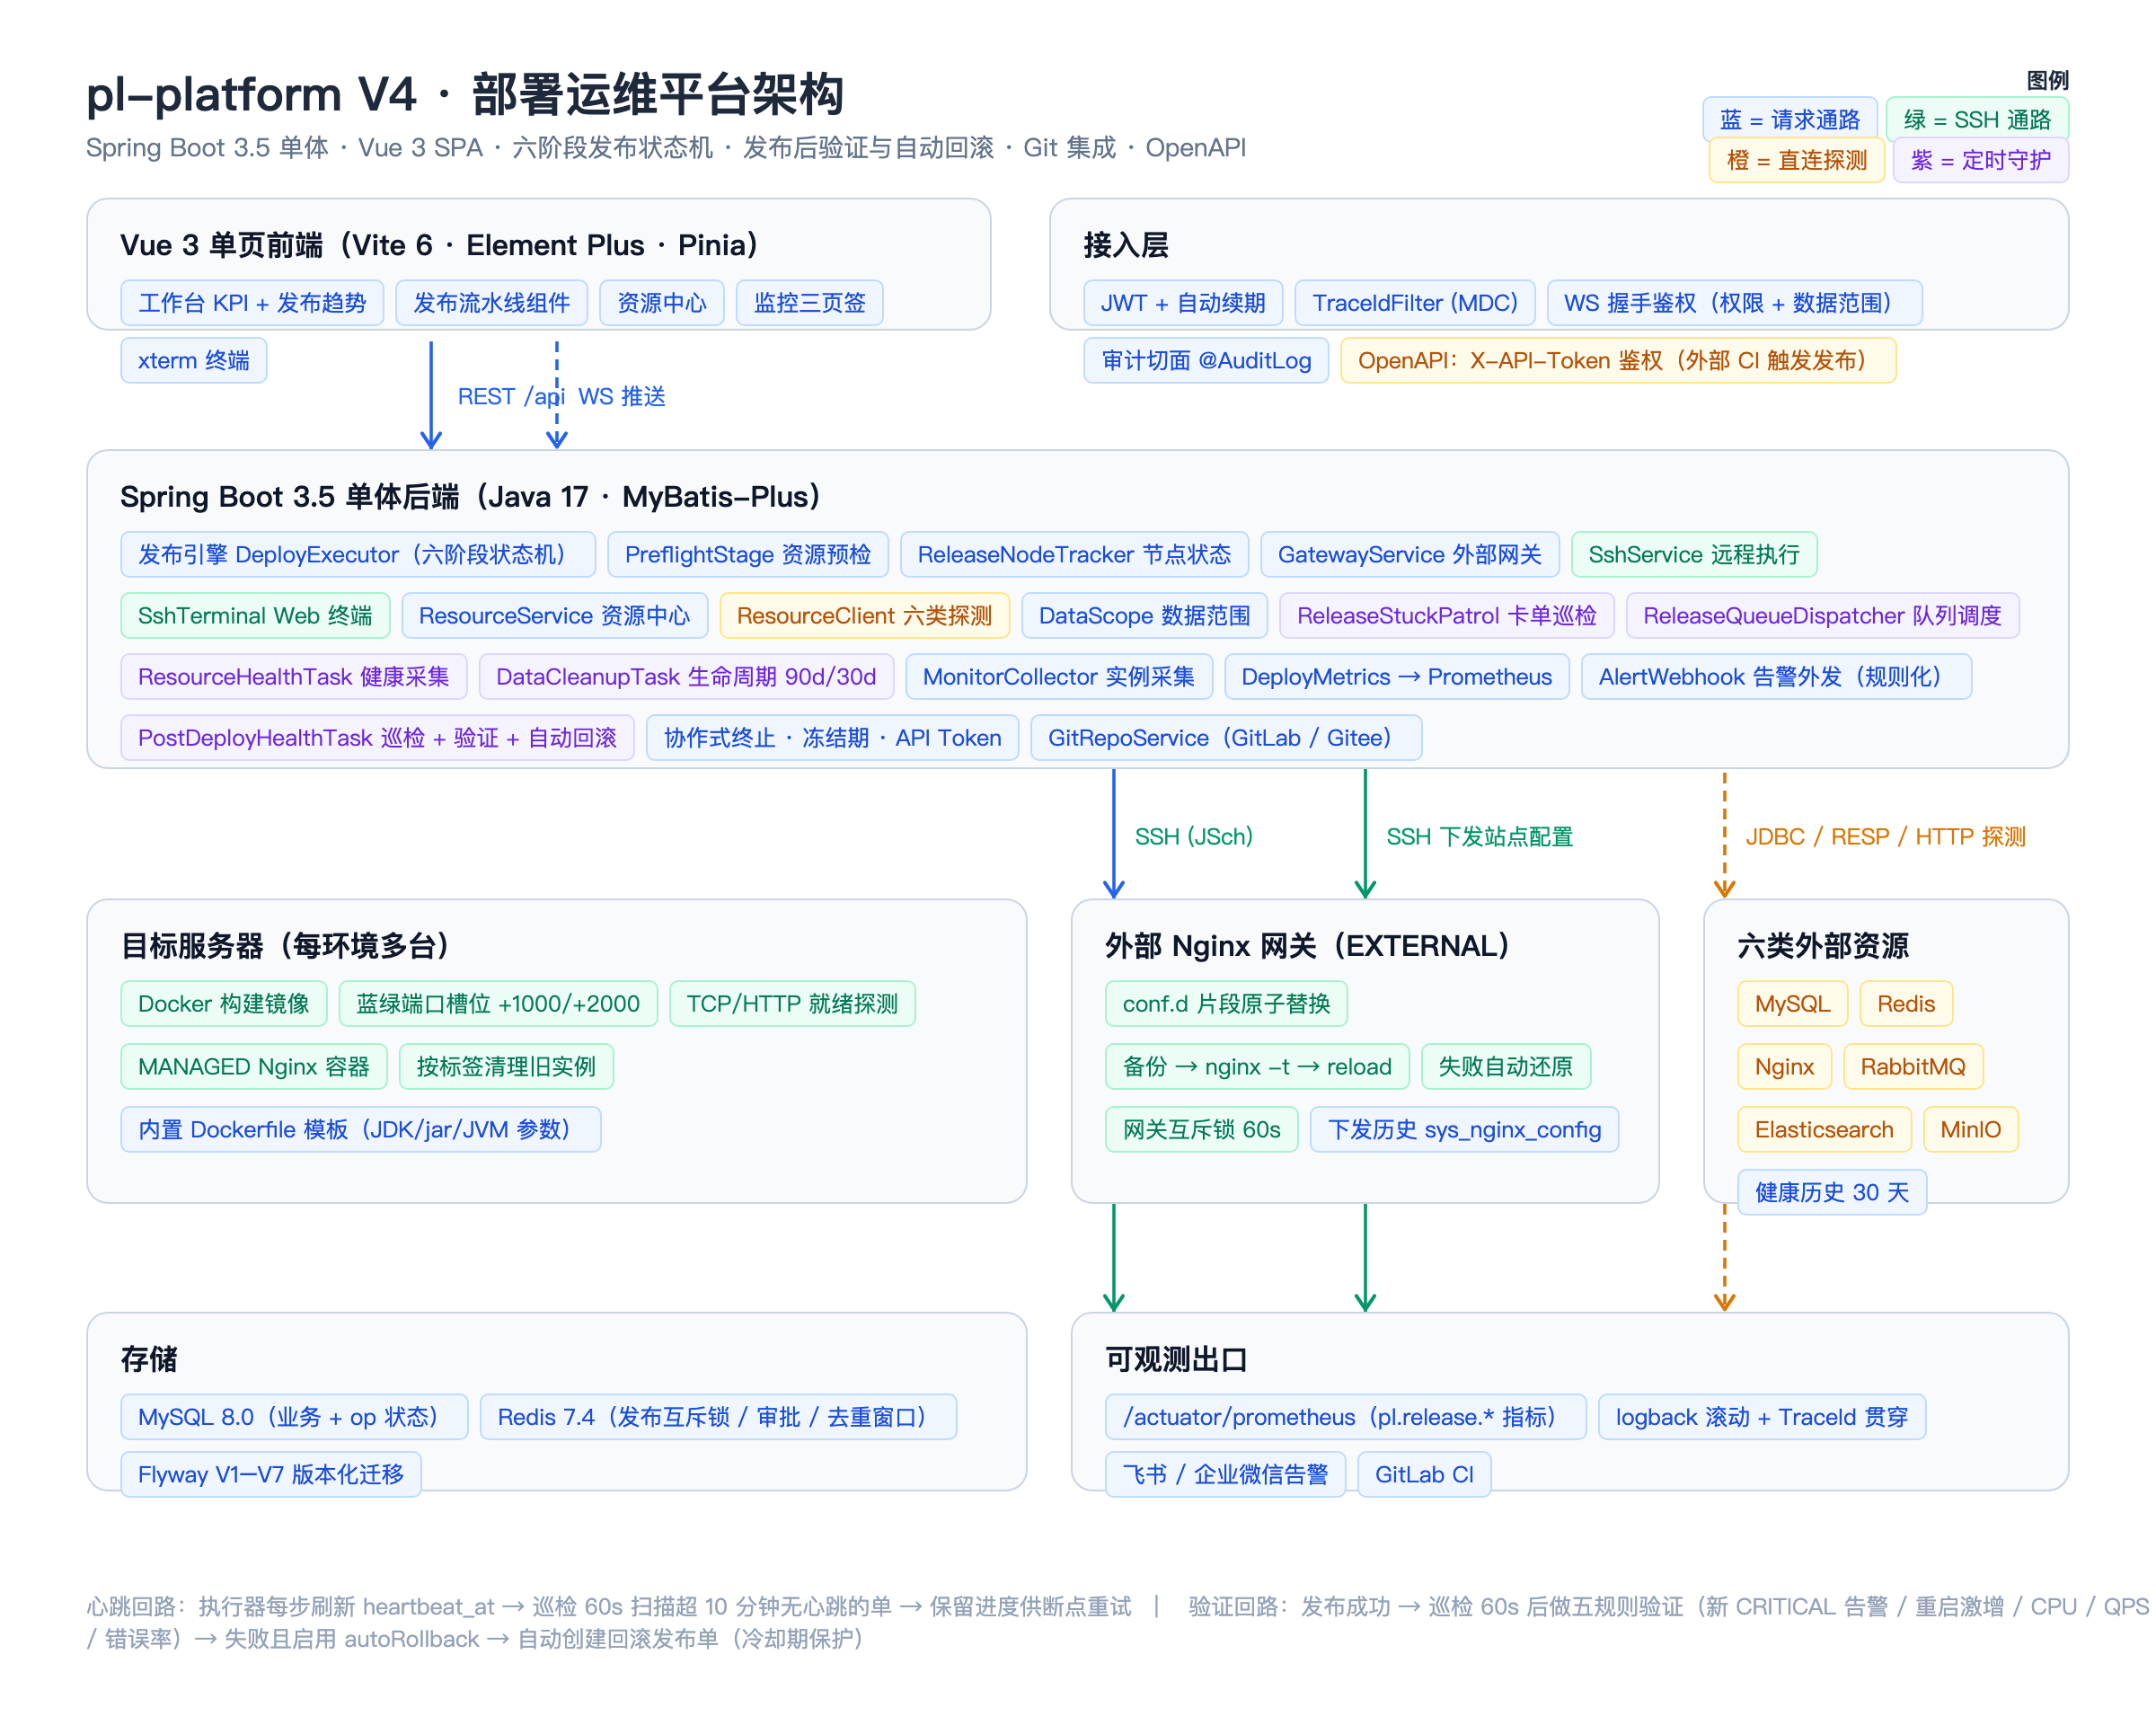
V4 之后,平台实际上有两条自愈回路在跑:
心跳回路(V3 已有):执行器每步刷新
heartbeat_at→ 巡检 60s 扫描超 10 分钟无心跳的单 → 保留进度供断点重试;验证回路(V4 新增):发布成功 → 巡检 60s 后做五规则验证 → 失败且启用
autoRollback→ 自动创建回滚发布单(冷却期保护)。
四、结果如何
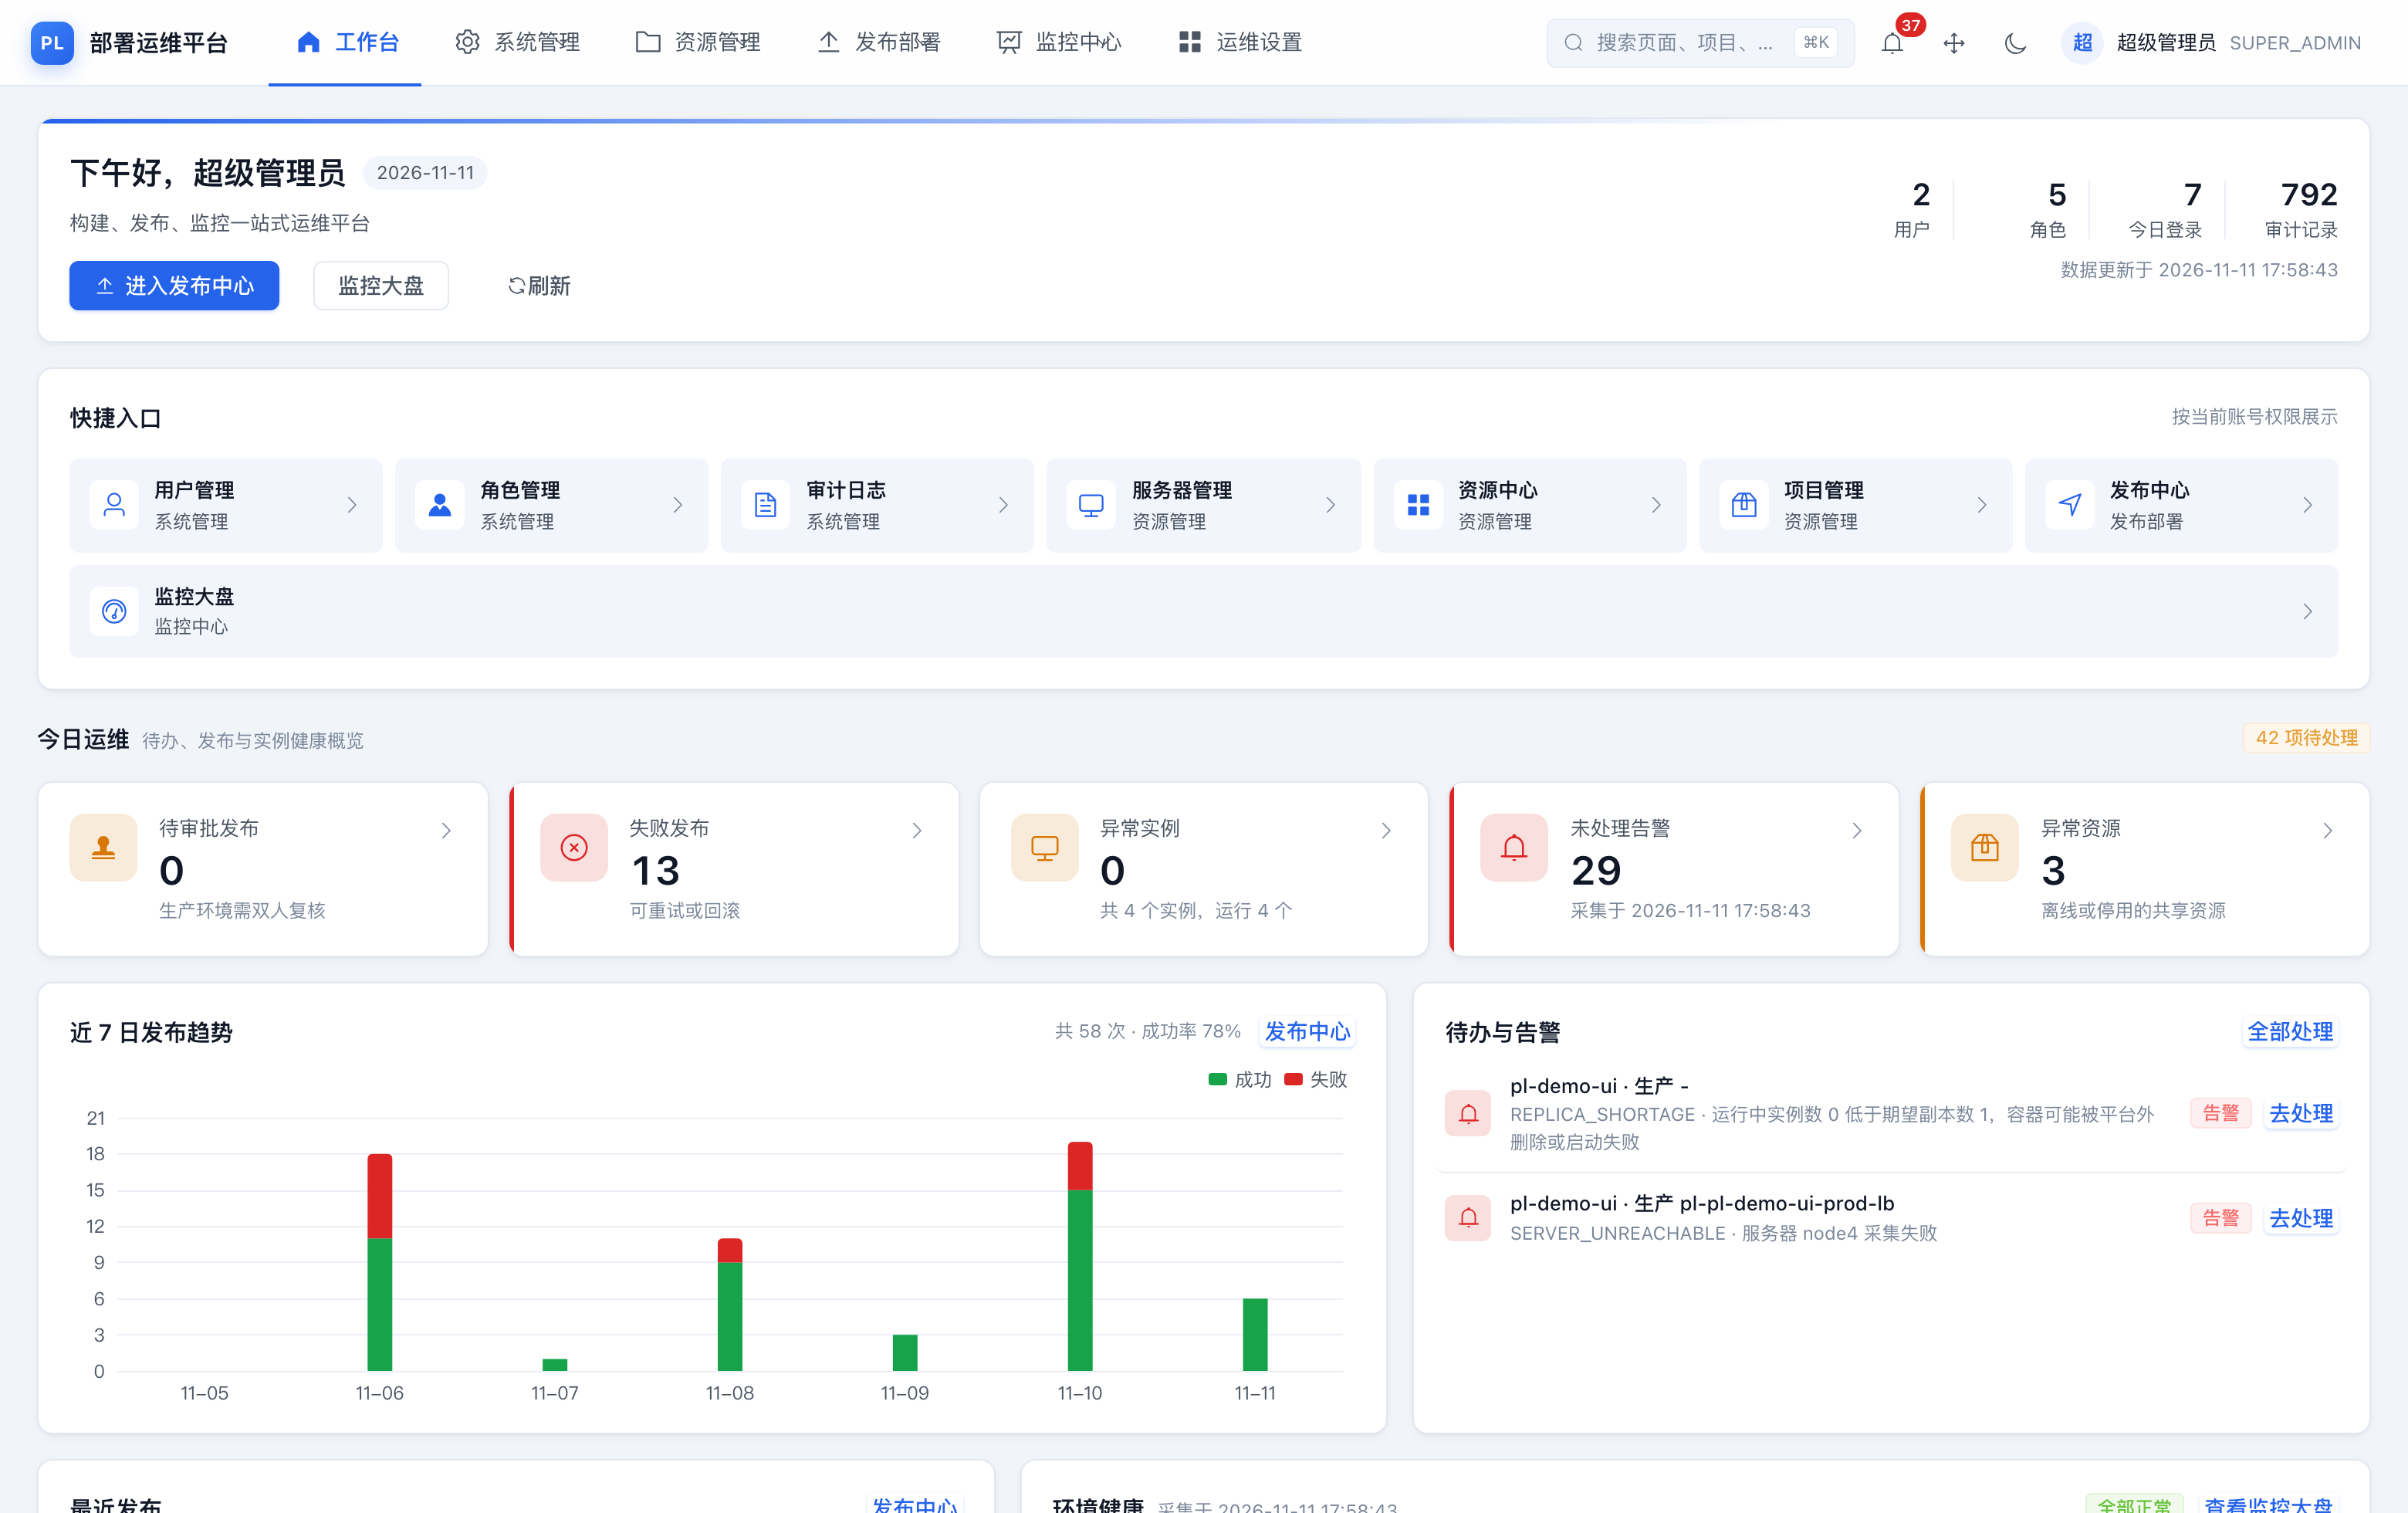
平台当前的真实运行数据(截图时刻):
近 7 天 58 次发布,成功率 78%——失败的都是预检/构建阶段的快速失败,旧实例全程未受影响;
今日运维五卡:待审批 0、失败发布 13(可重试或回滚)、异常实例 0、未处理告警 29、异常资源 3;
审计 792 条,全部带操作人 / IP / 耗时;
生产发布单 #62 全程 1m41s,发布后巡检结论"健康,运行实例 1/1"。
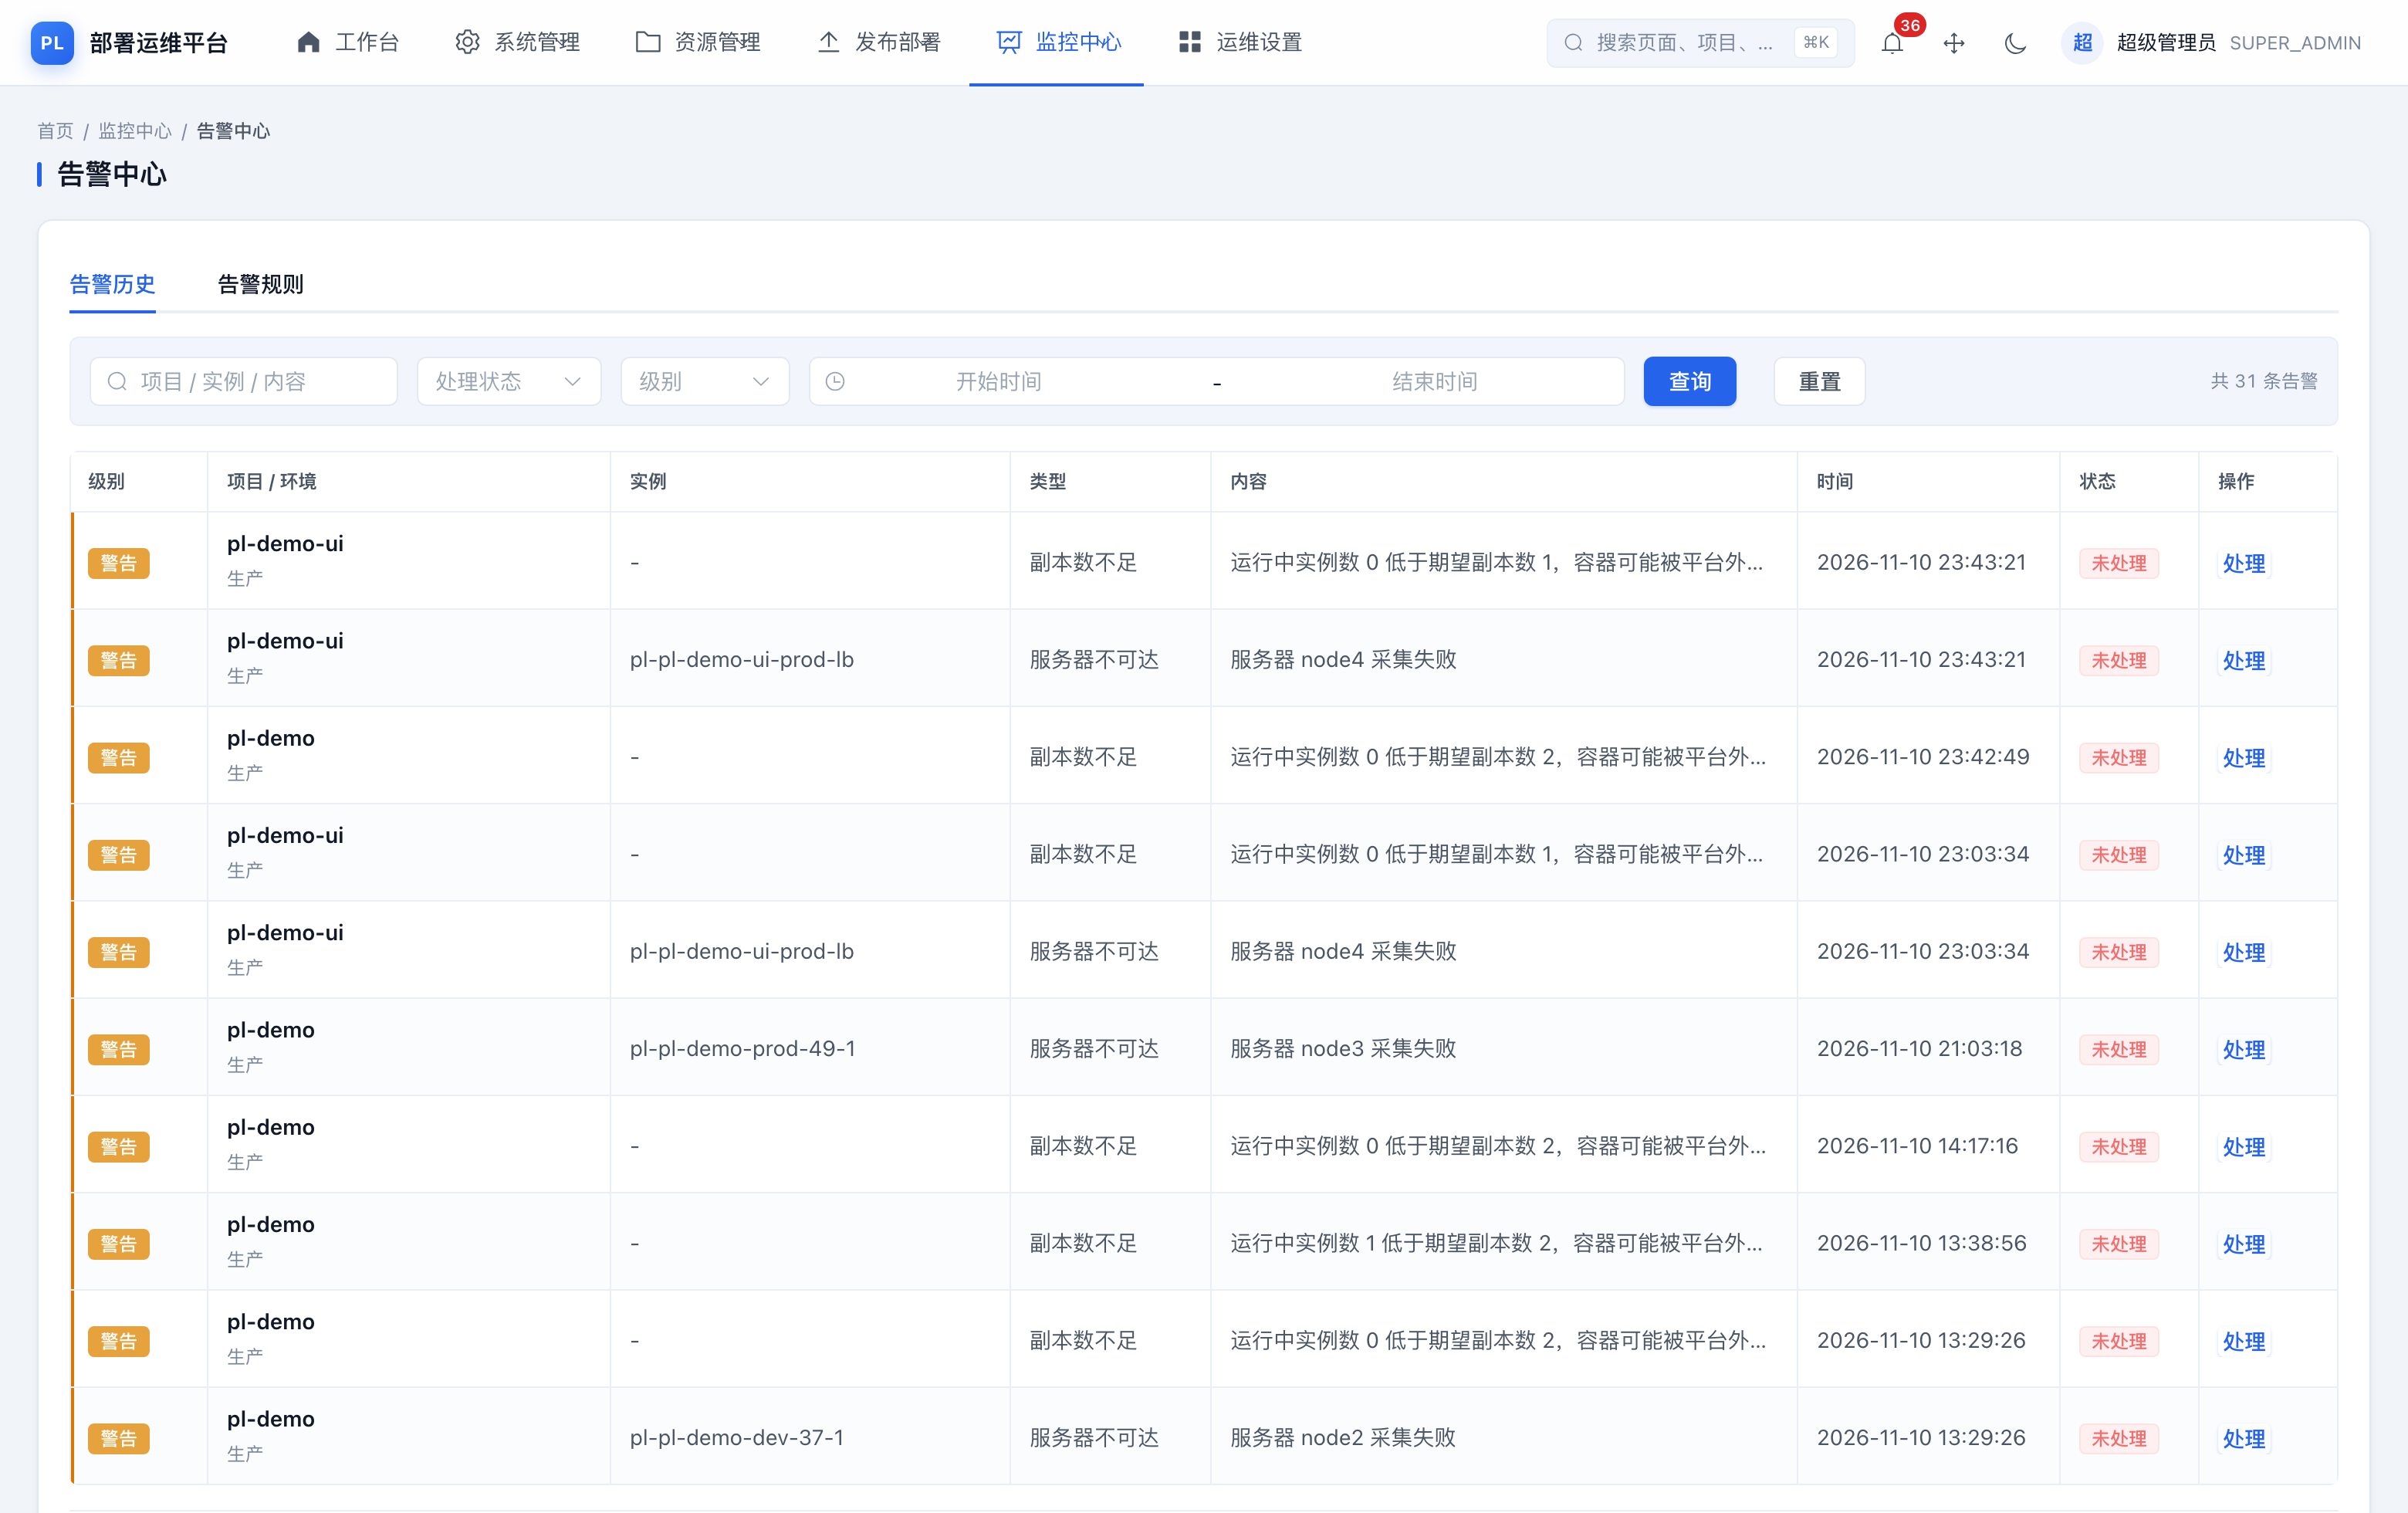
告警中心里能看到验证哨兵的数据源:31 条告警(副本不足、服务器不可达),每条都标了级别与处理状态——它们既是运维要处理的事件,也是发布验证的输入。
五、局限与下一步
诚实比体面重要,这版有三处我知道的欠账:
发布策略只完成了"配置层"。
ROLLING / CANARY / BLUE_GREEN三种策略的环境字段与配置 UI 已经就位,但发布引擎目前只按蓝绿路径执行——金丝雀分批放量(canary_batches)还没有对应的执行分支。这是 V5 的第一件事。验证阈值是代码常量。CPU 90%、QPS 50%、错误率 5% 写在
PostDeployVerificationService里,不同业务容忍度不同,应该挪进sys_project_env或告警规则表。发布详情页仍是 5 秒轮询。列表页的日志已经是 WebSocket 推送,详情页的阶段与日志还差一步。
一个观察作为结尾:前三轮我们在解决"发布能不能成",这一轮开始回答"发布好不好"。这两件事的分水岭在于——前者只需要状态机,后者需要度量。当你能对一次发布说出"构建 57 秒、切流 18 秒、发布后错误率 0.2%、验证通过",发布才真正从手艺变成了工程。
系列文章:V1《从 0 到 1 的发布引擎》→ V2《把发布做成状态机》→ V3《把可靠性做成闭环》→ 本文。代码细节与完整实现见仓库,欢迎交流。

