本文是 pl-platform 系列的第五篇。前四篇依次解决了「把发布做出来」「做成状态机」「让平台自愈」「发布成功之后谁来判断好不好」。这一版不太一样:它没有再往流水线上加一个新阶段,而是回到地基,回答三个更硬的问题——这次发布到底发了什么、半年后还能不能复现、以及谁动过这套系统。全部代码与数据来自真实运行的项目,配图为平台实际截图与按源码绘制的架构图。
一、这是什么
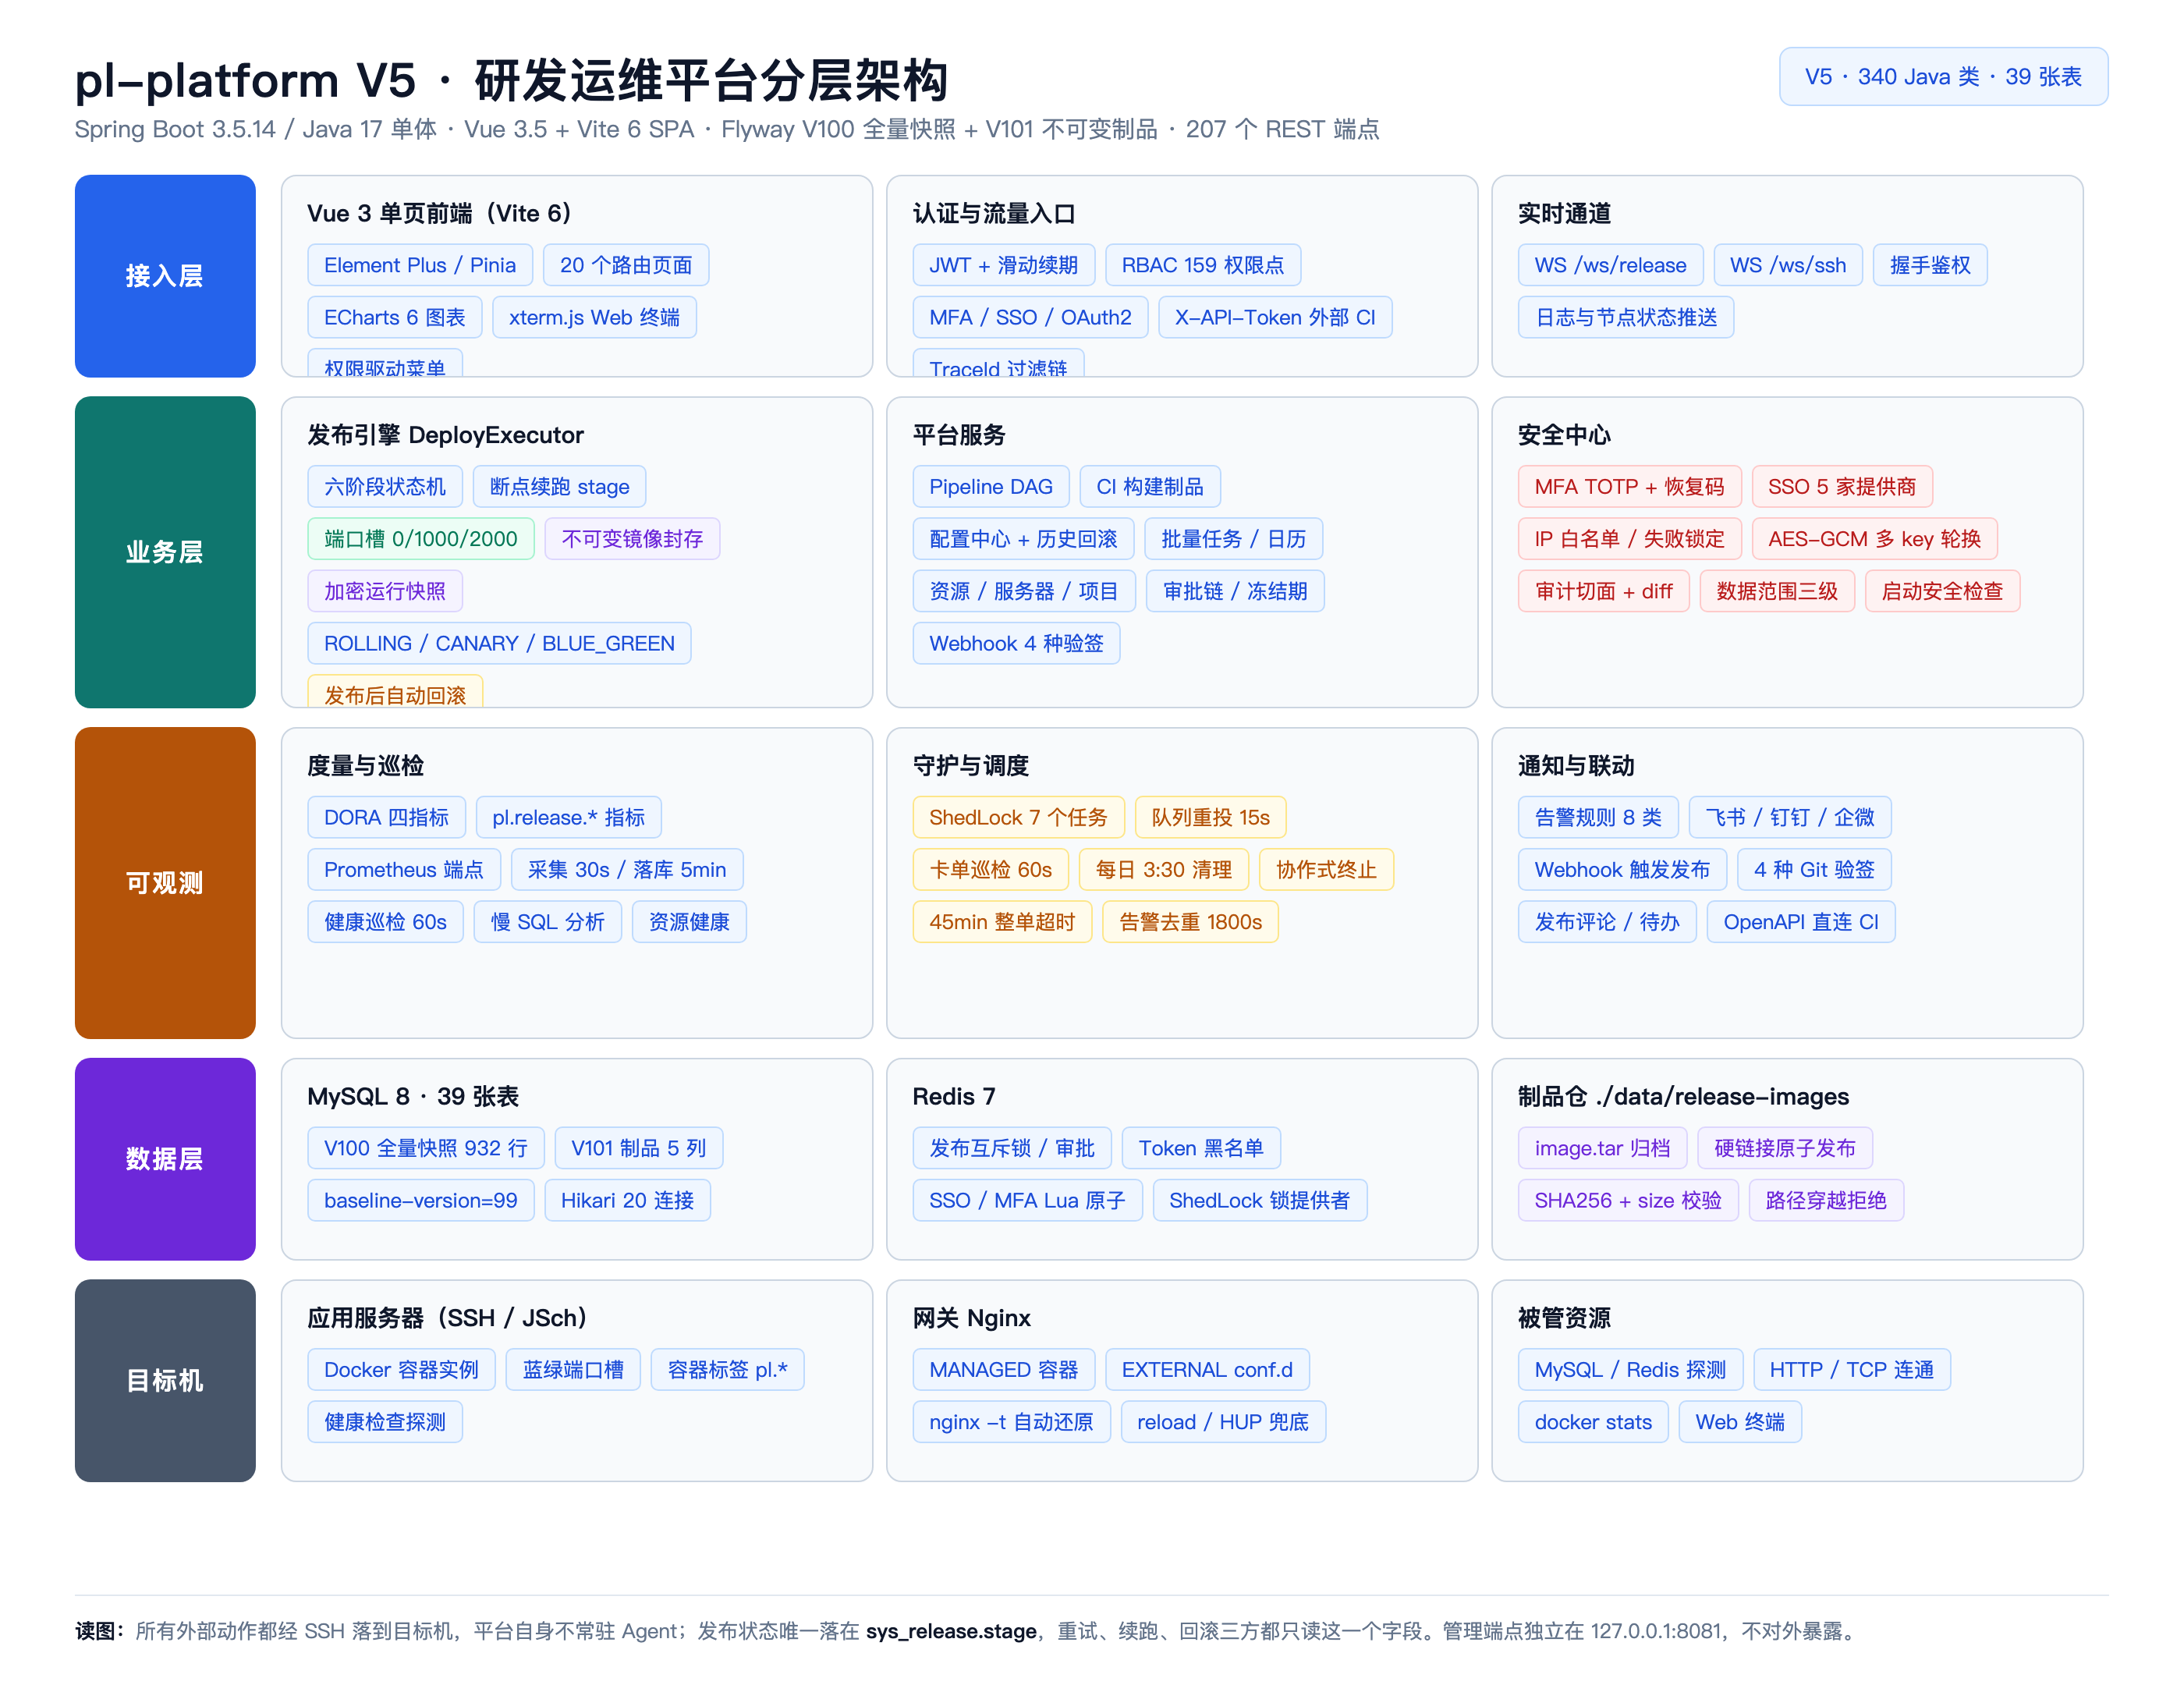
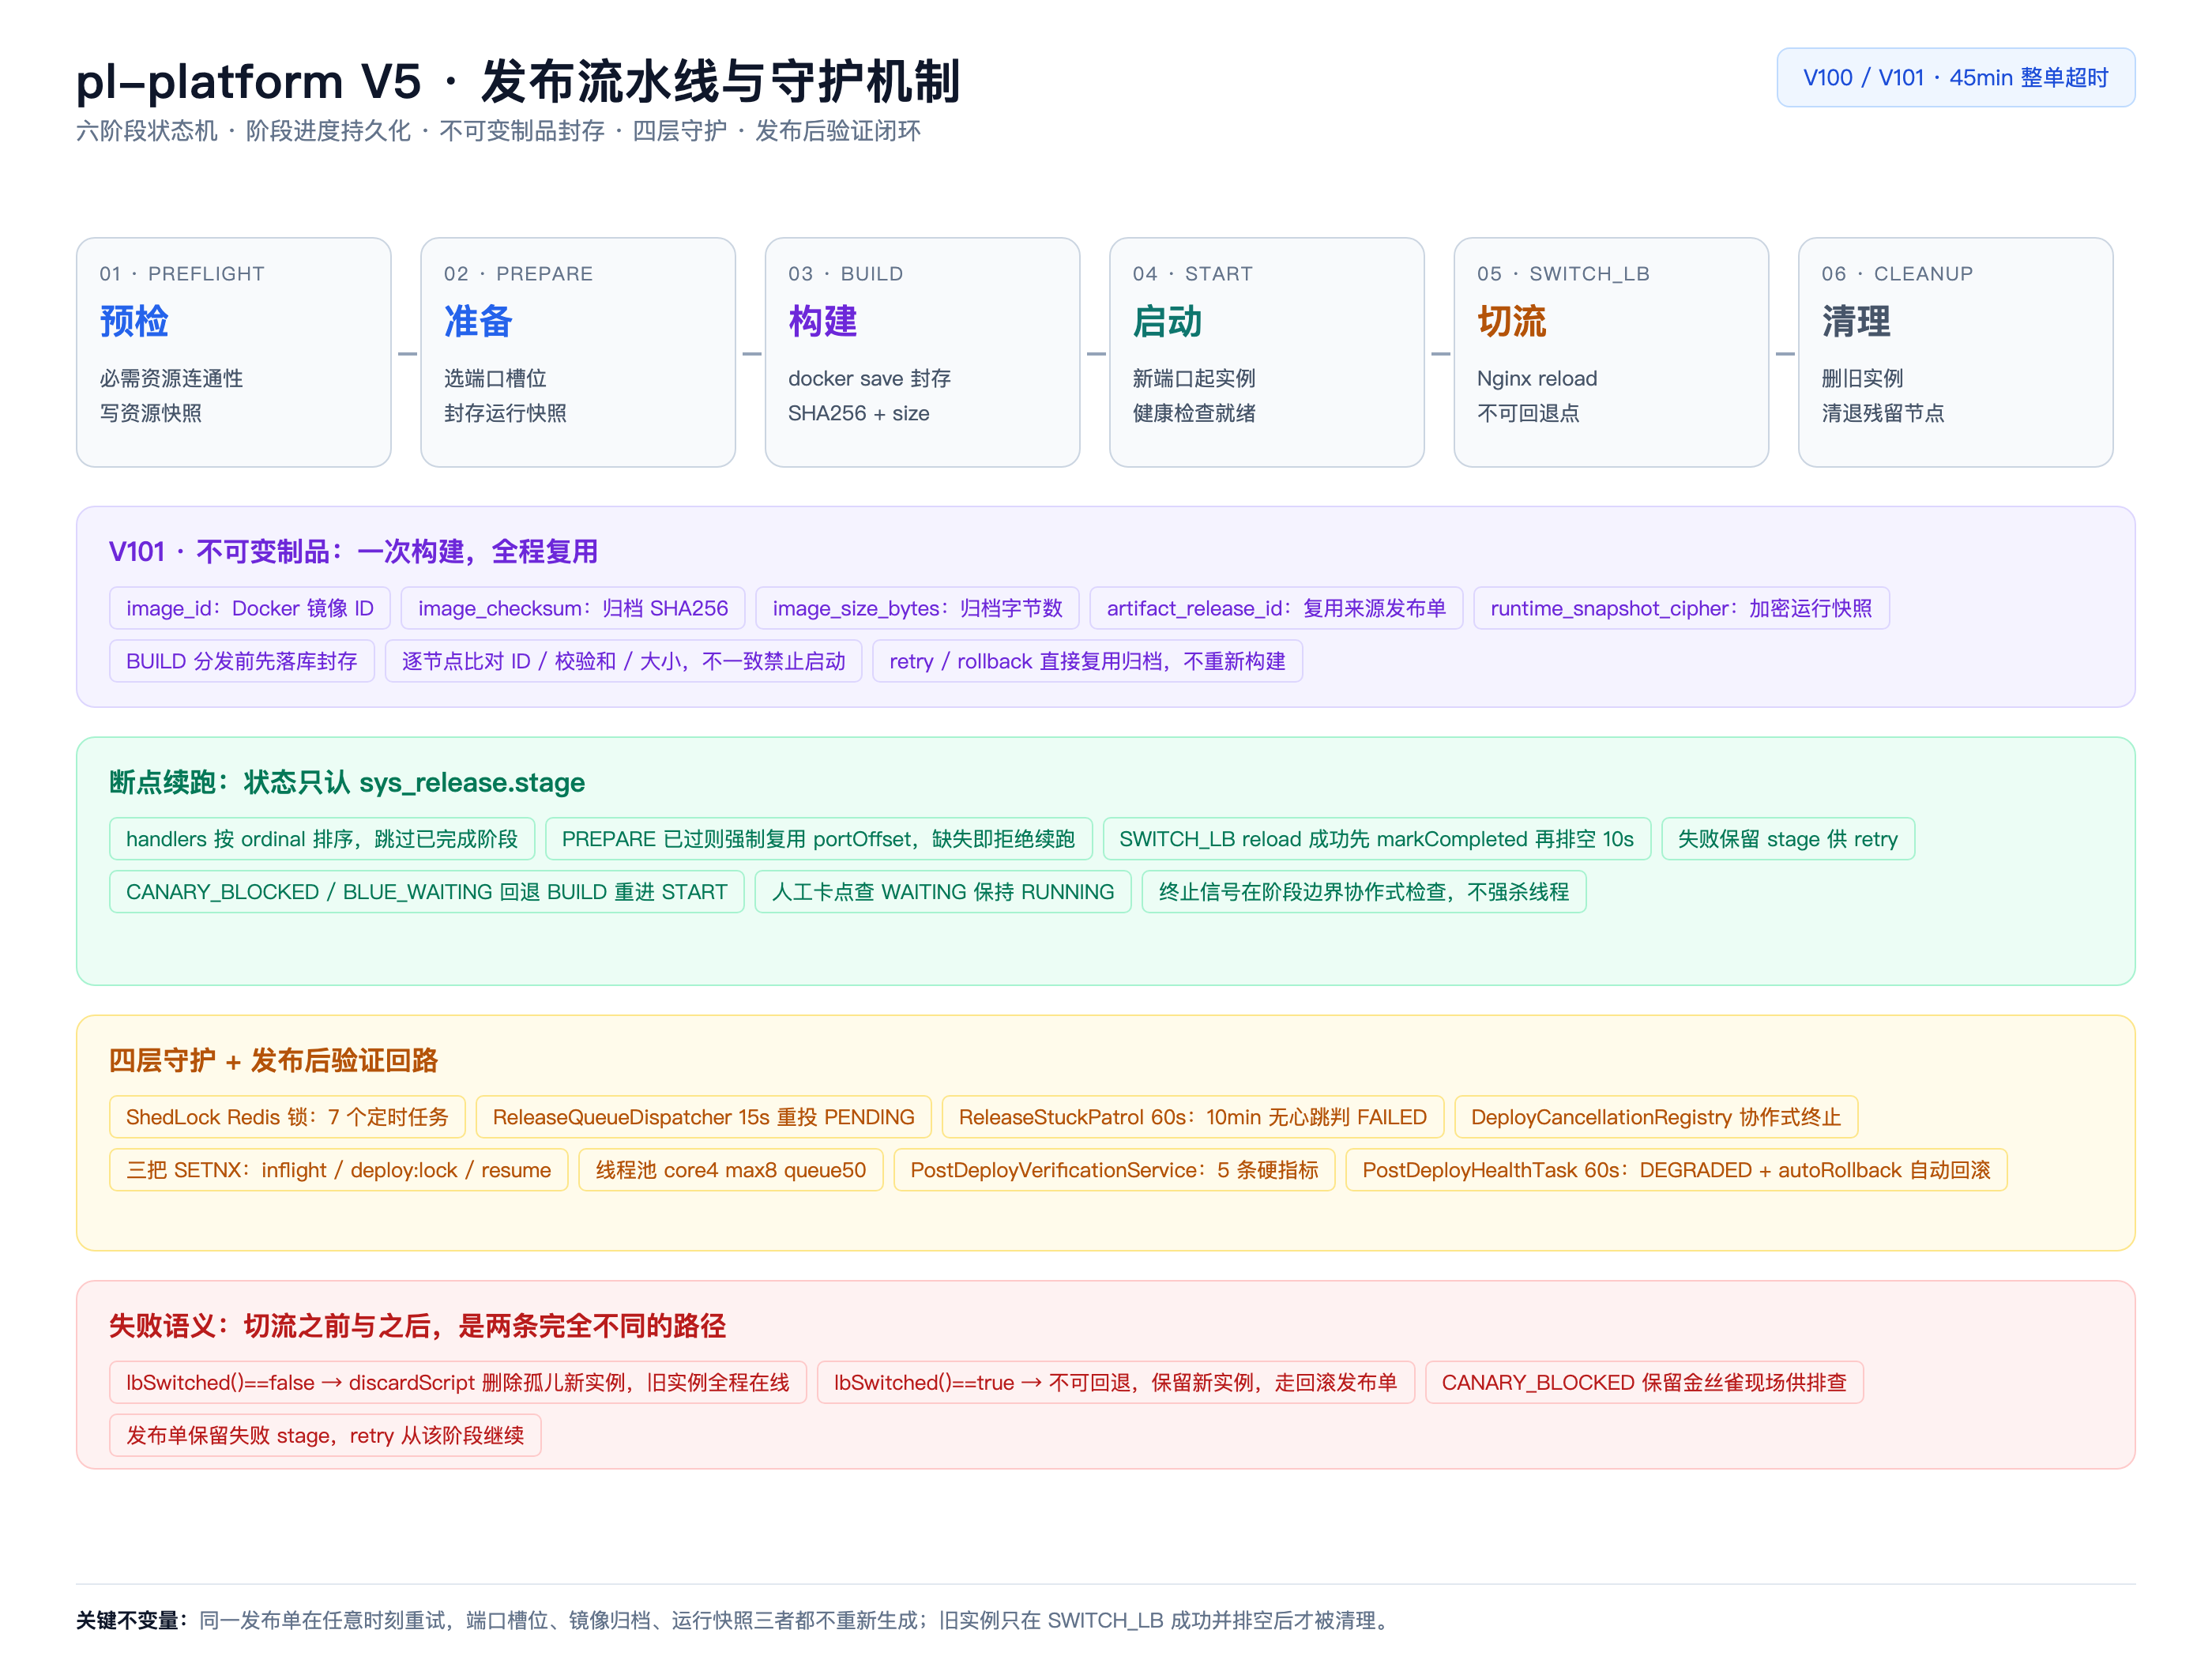
pl-platform 是一套自研的研发运维平台:Spring Boot 3.5 单体 + Vue 3 SPA,通过 SSH 操控目标服务器上的 Docker 与 Nginx,把「拉代码 → 构建 → 起实例 → 切流量 → 清理」收敛成一条六阶段状态机流水线,外围挂资源中心、CI 构建、Pipeline 编排、监控告警、配置中心、安全体系与审计。
先看技术形态,后文不再重复:
这一版最值得说的不是"又加了几个页面",而是三个结构性动作:
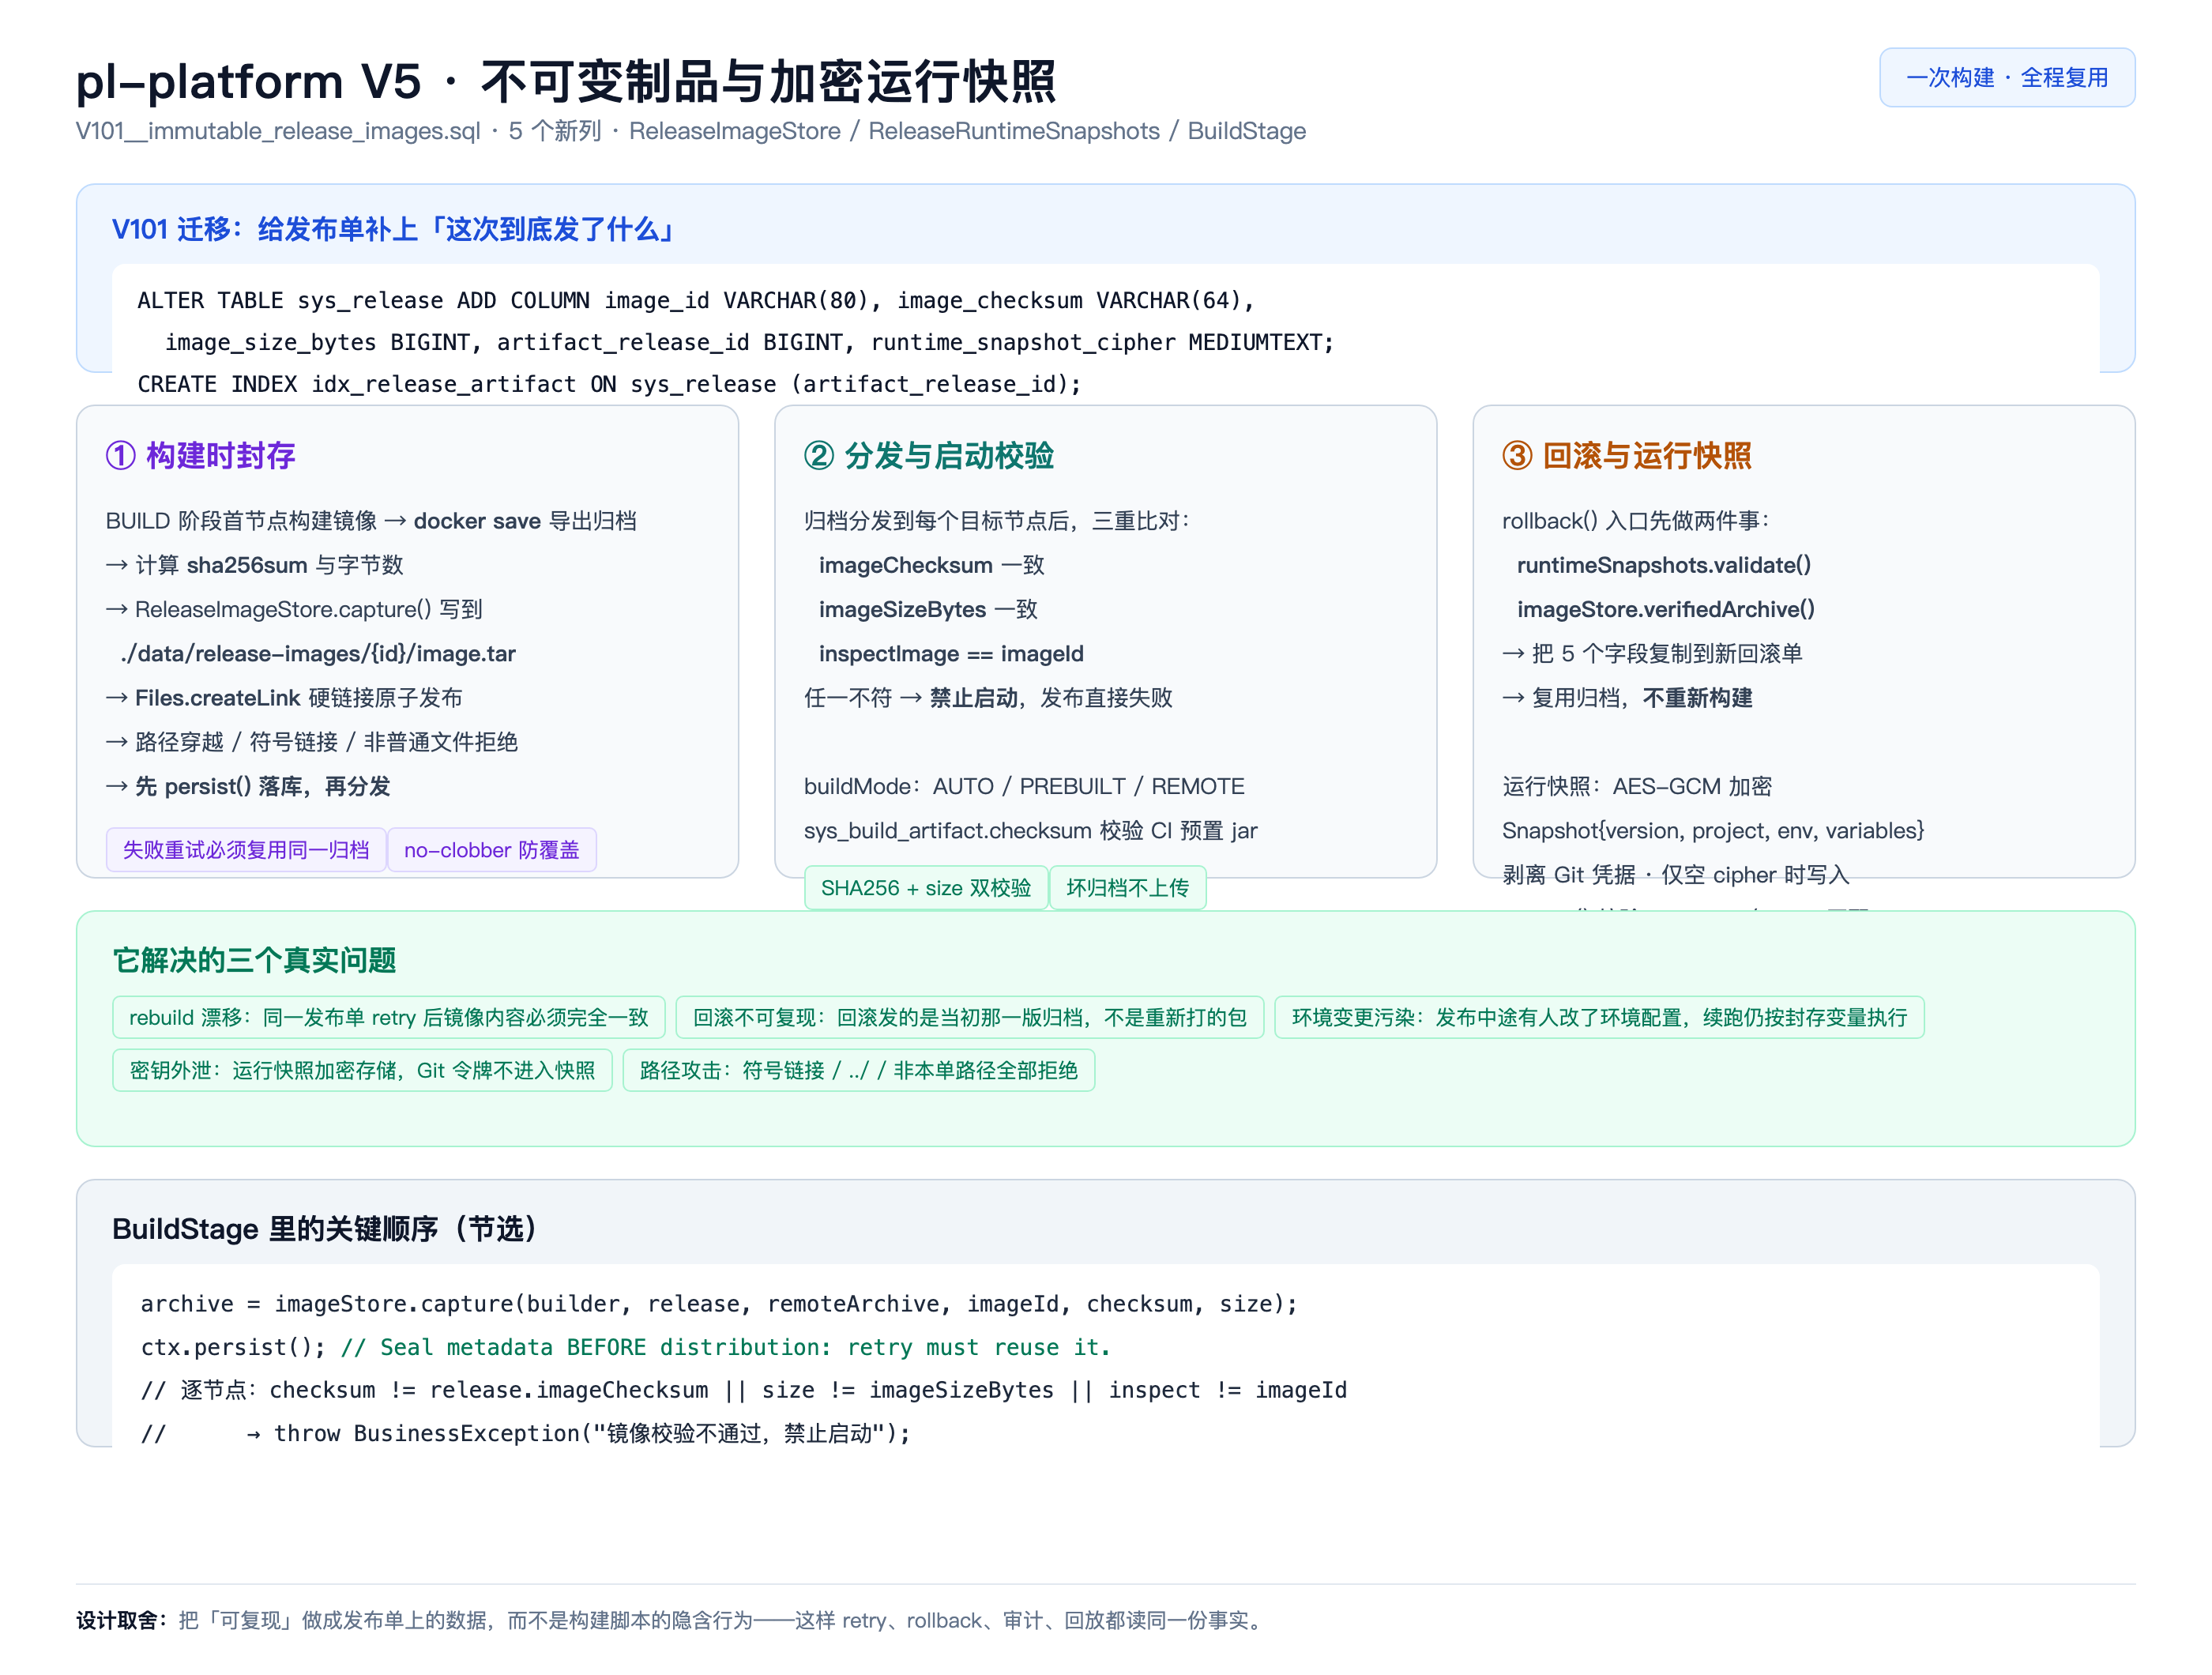
迁移基线重建:把散落的 V1–V26 增量合并成
V100__consolidated_full_snapshot.sql(932 行、39 张表),后续只从 V101 往前走。老库通过baseline-version=99平滑接入,不再背几十个历史版本的包袱。发布即事实:一次发布产出的镜像归档、校验和、运行配置被固化进发布单,retry 与 rollback 都不再重新构建。
零信任补完:从"登录能进"升级到"登录要过几道关、动过什么都留痕、密钥不能是默认值"。
一句话概括 V5:把发布从「一次脚本执行」变成「一组可复现、可校验、可审计的数据」。
二、它做什么:功能全景
按平台实际的菜单结构走一遍,每个模块配一张运行实例的真实截图。
2.1 发布中心与发布详情
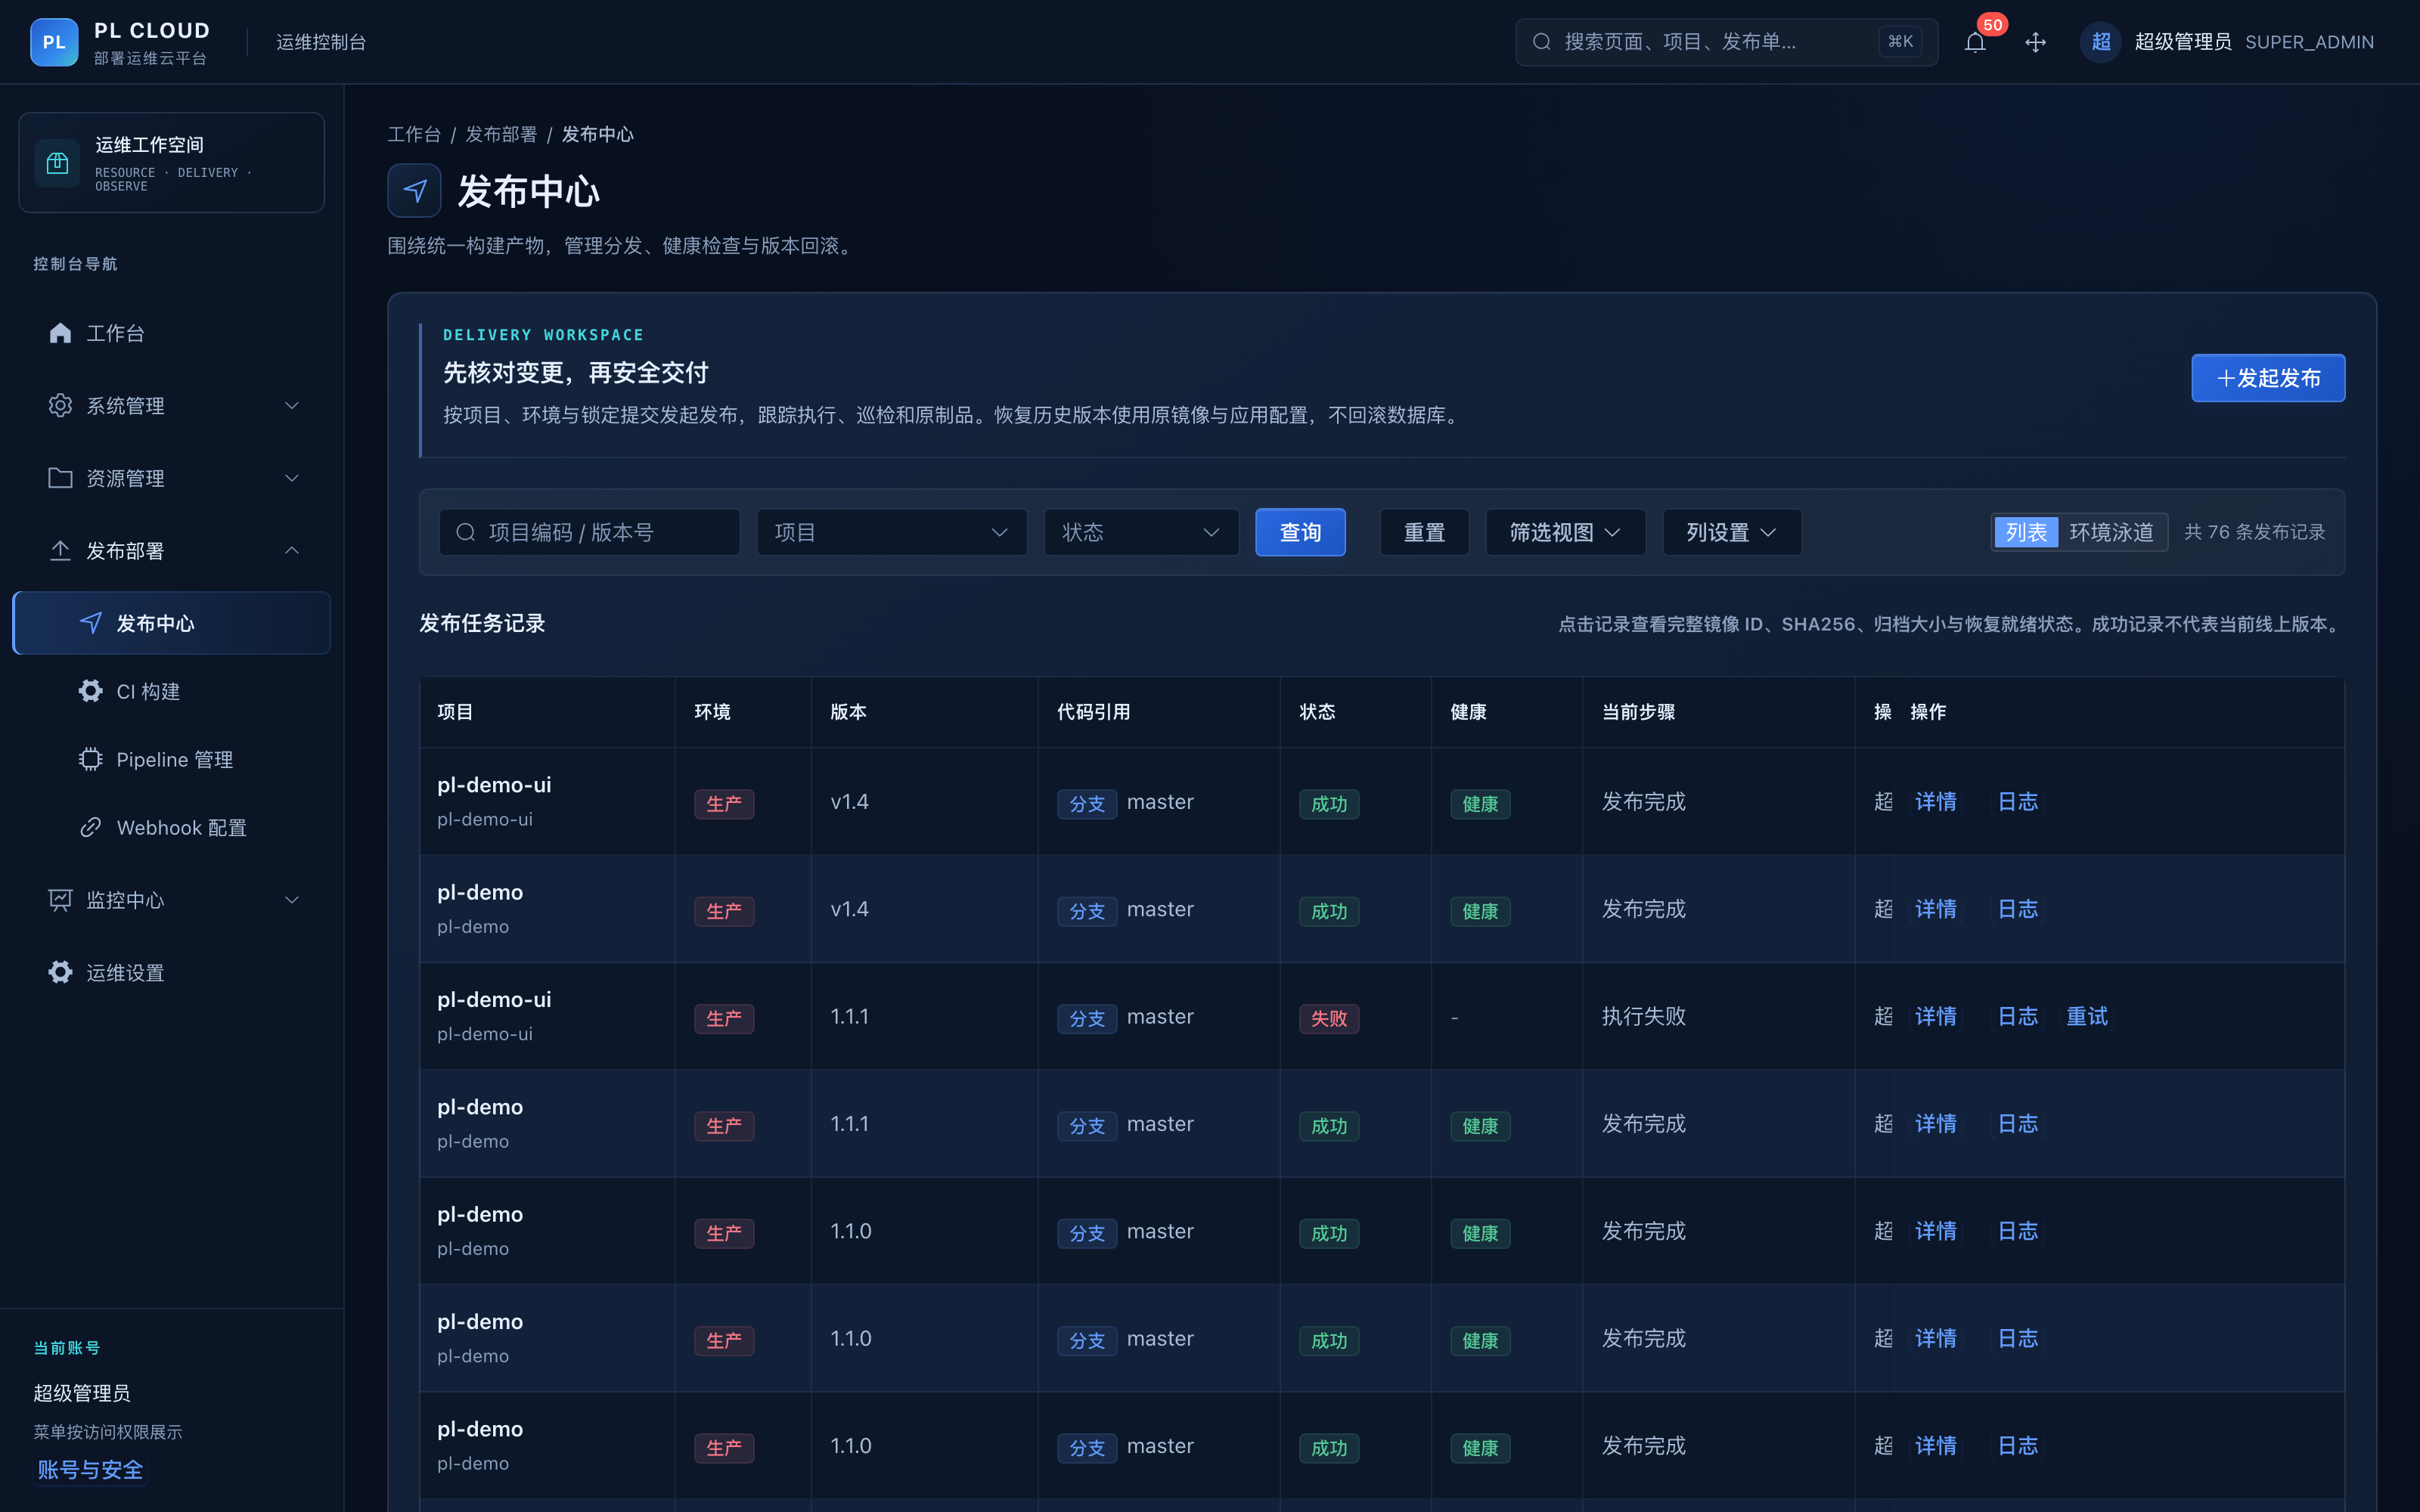
发布中心是主入口:按项目、环境、状态筛选,发起发布、终止、回滚、审批都在这里。列表页已经是 WebSocket 推送,详情页展示六阶段逐段耗时、节点级日志、镜像制品信息与发布后巡检结论。
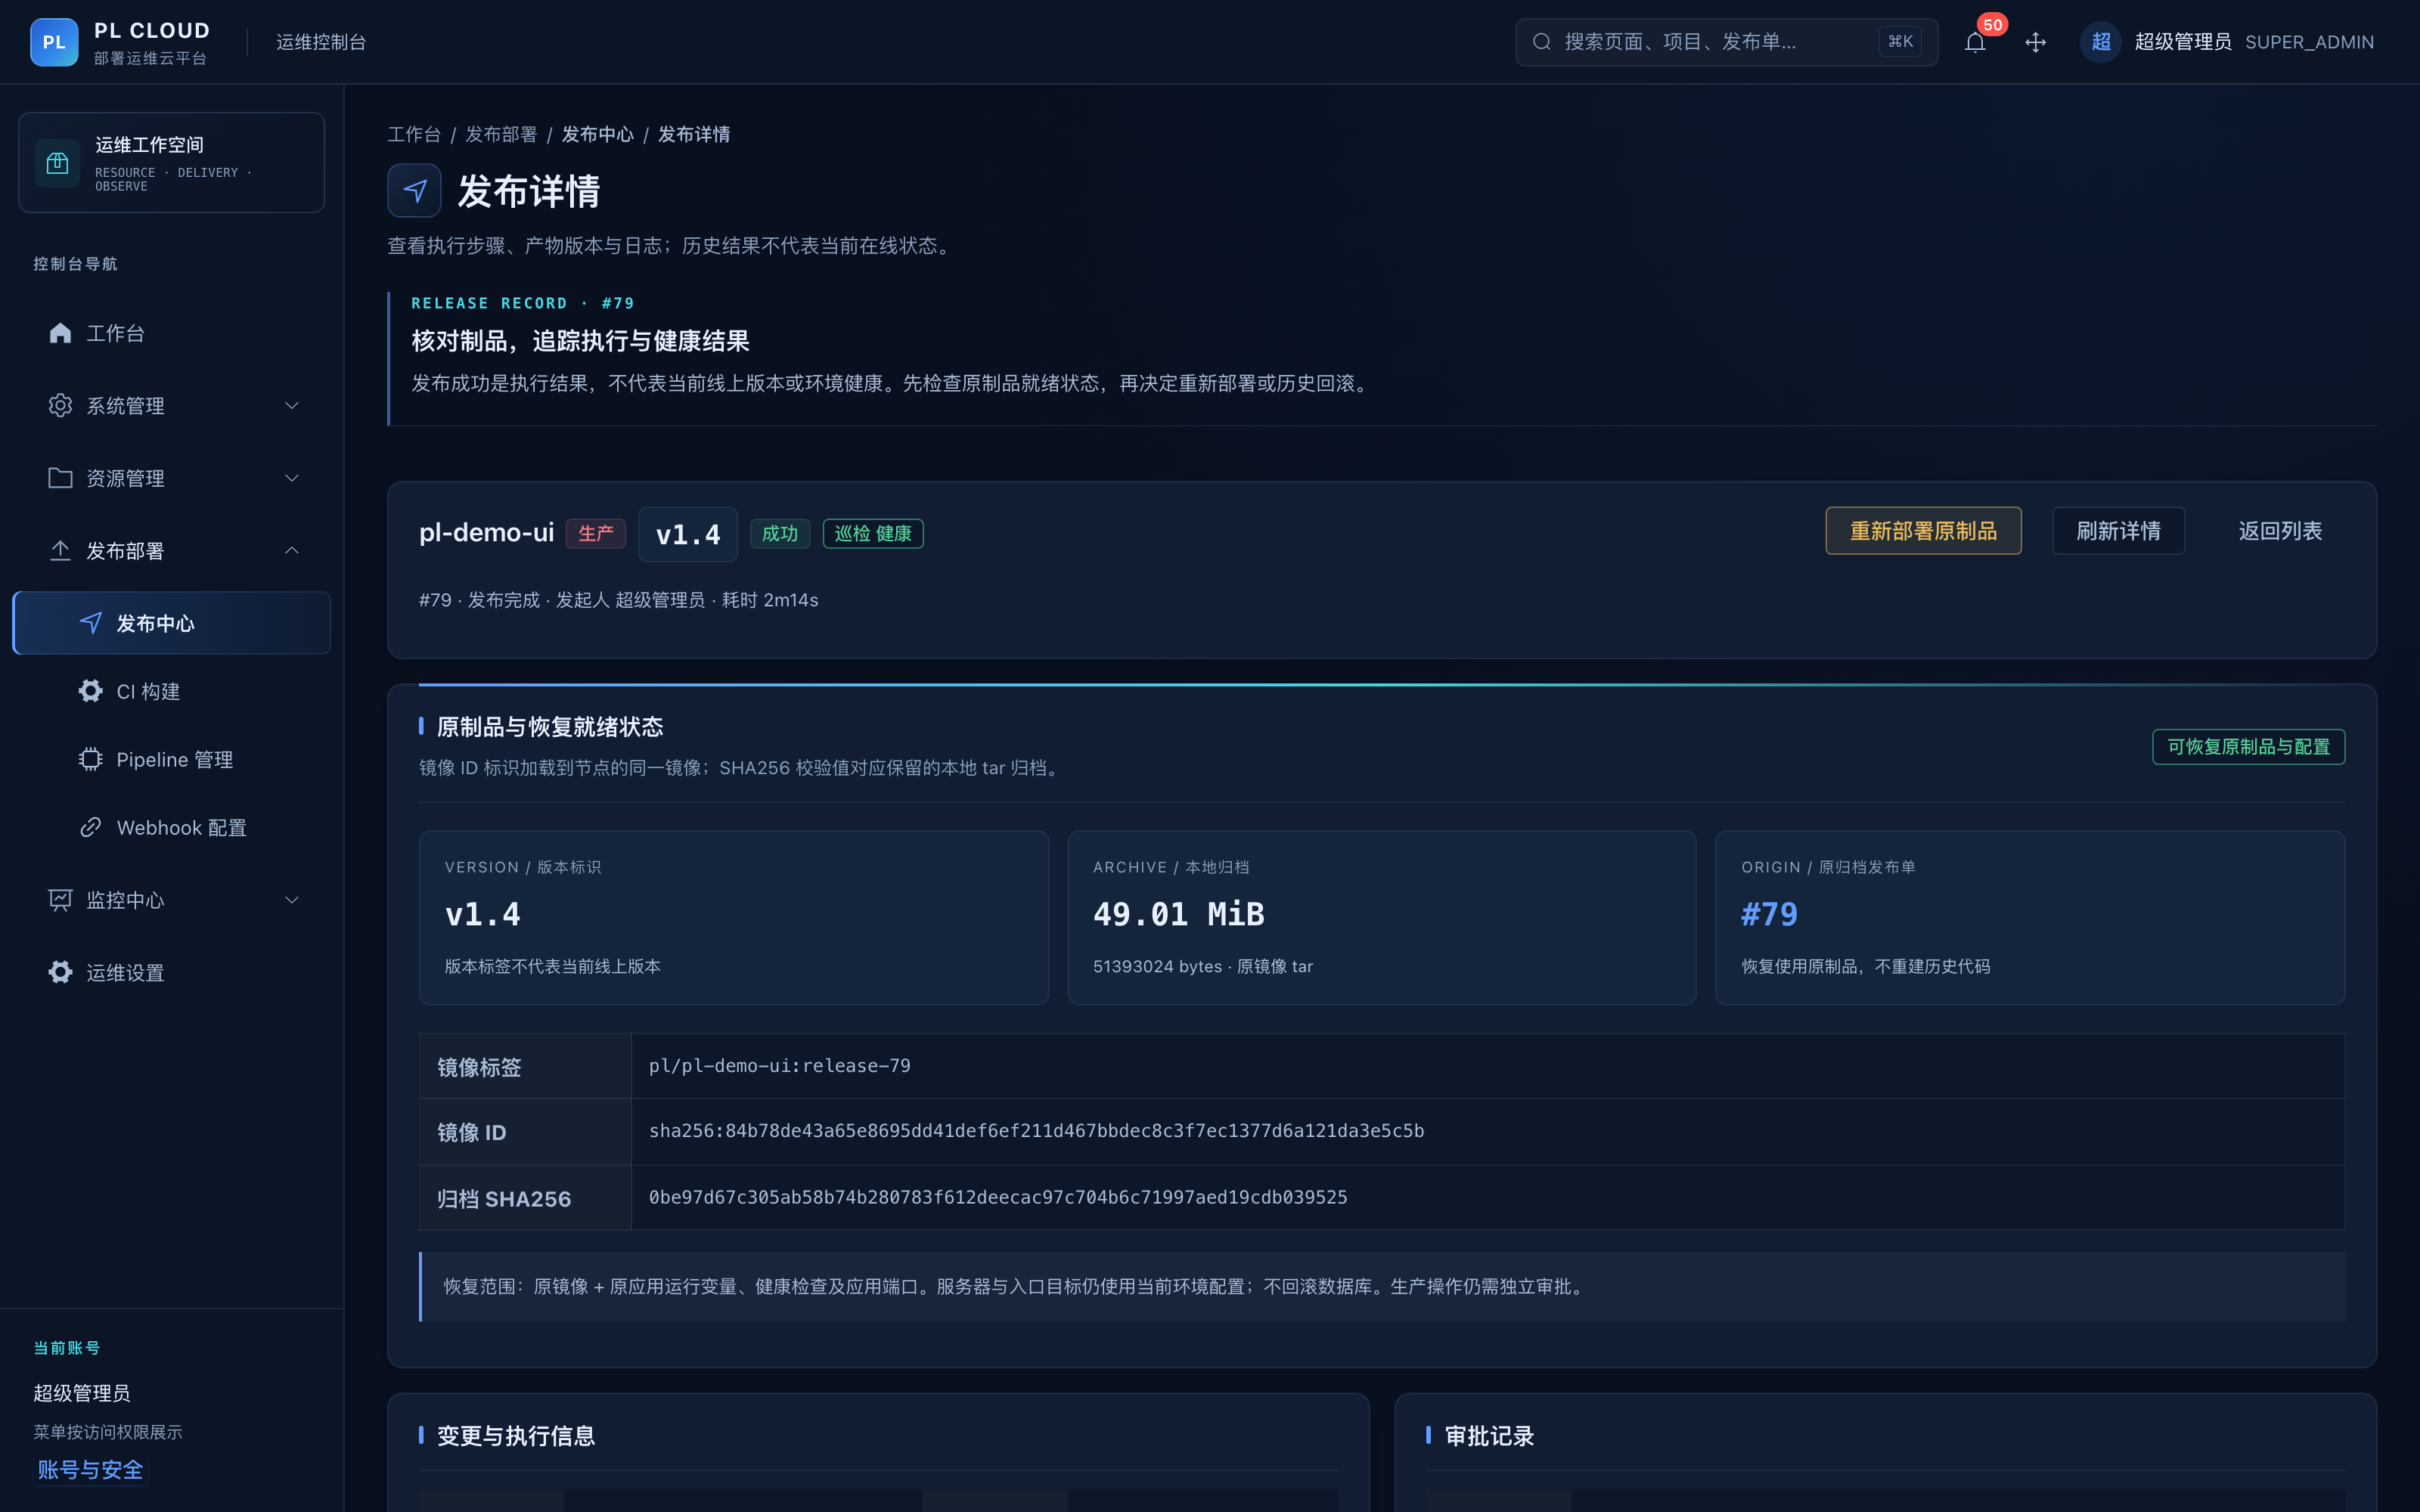
详情页这一张很关键——它已经不是"一个日志面板",而是一次发布的完整证据:版本号 v1.4、镜像 49.81 MB、镜像 ID sha256:d0e1…、提交 SHA 314a5812…、总耗时 77s、生产环境标识、健康检查结论。这正是 V101 想达到的效果。
2.2 流水线编排、CI 构建与发布日历
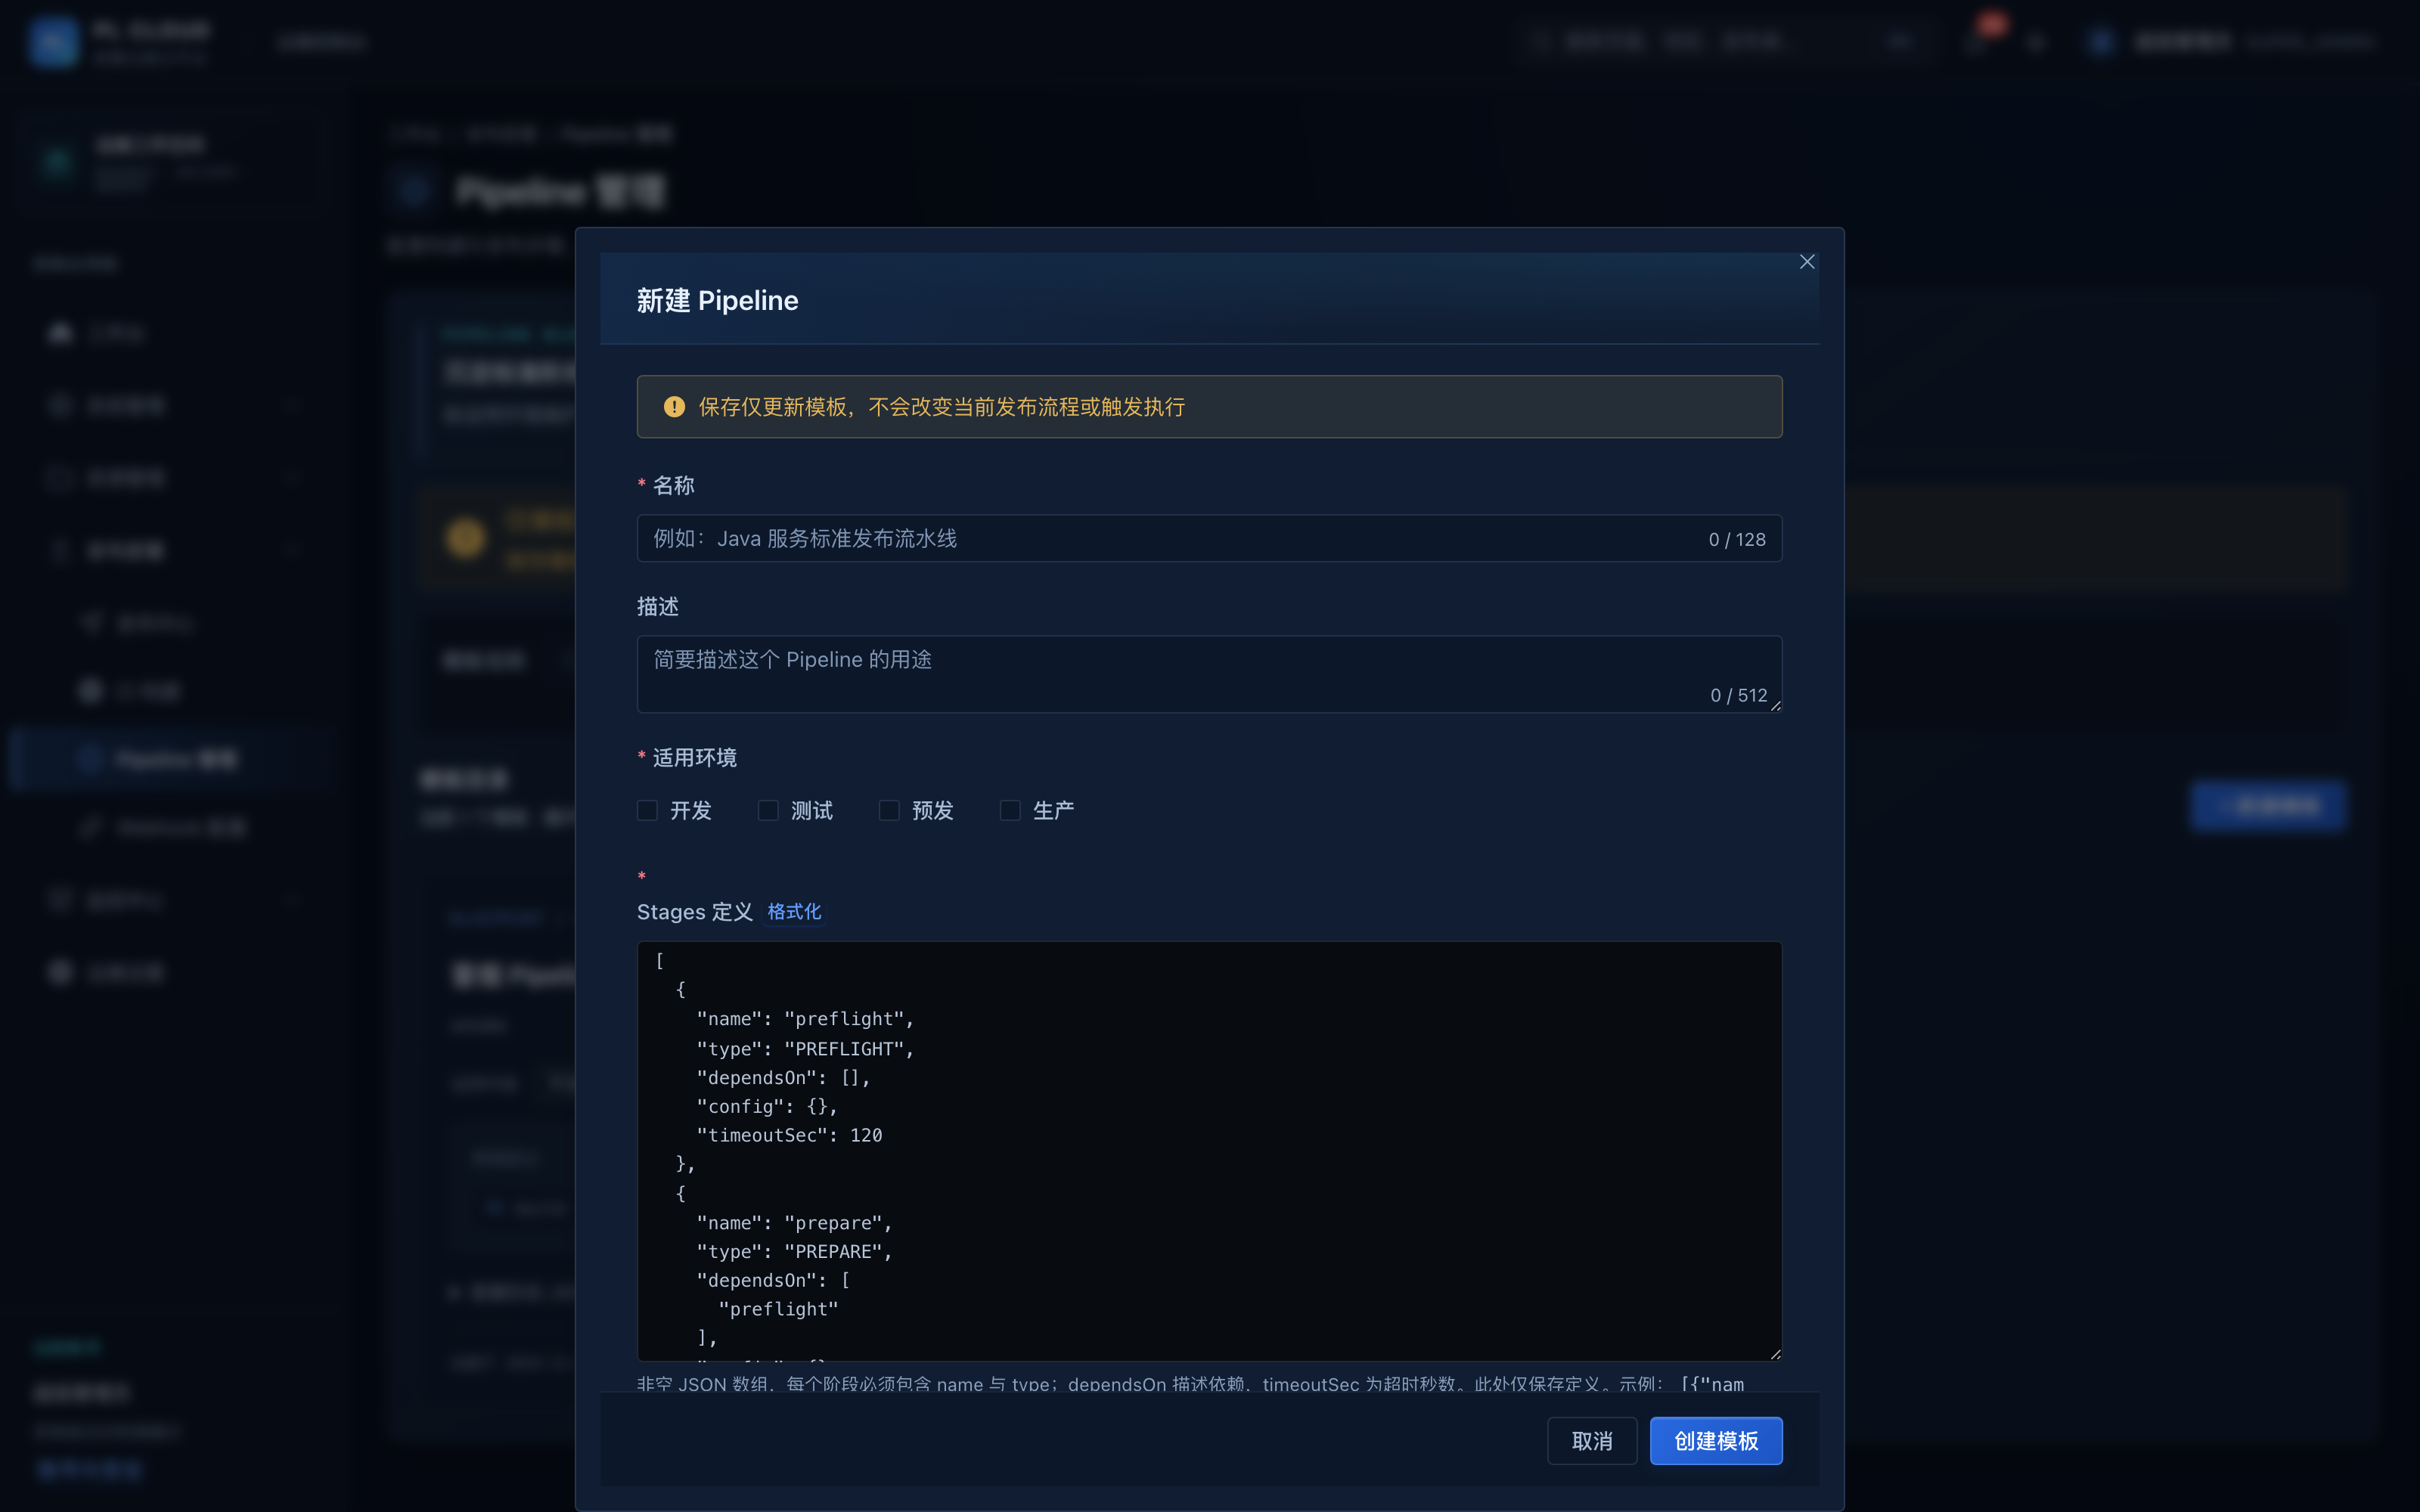
V5 把"发布"从一个固定六阶段,扩展成可编排的能力:Pipeline 管理 允许自定义阶段 DAG(内置 6 个阶段 + 人工审批 / 人工等待 / 自定义脚本共 9 种节点),CI 构建 独立管理构建任务与预置制品,发布日历 按天回看变更节奏,Webhook 配置 接 GitHub / GitLab / Gitee / Gitea 四种验签触发。
2.3 资源、服务器与配置中心
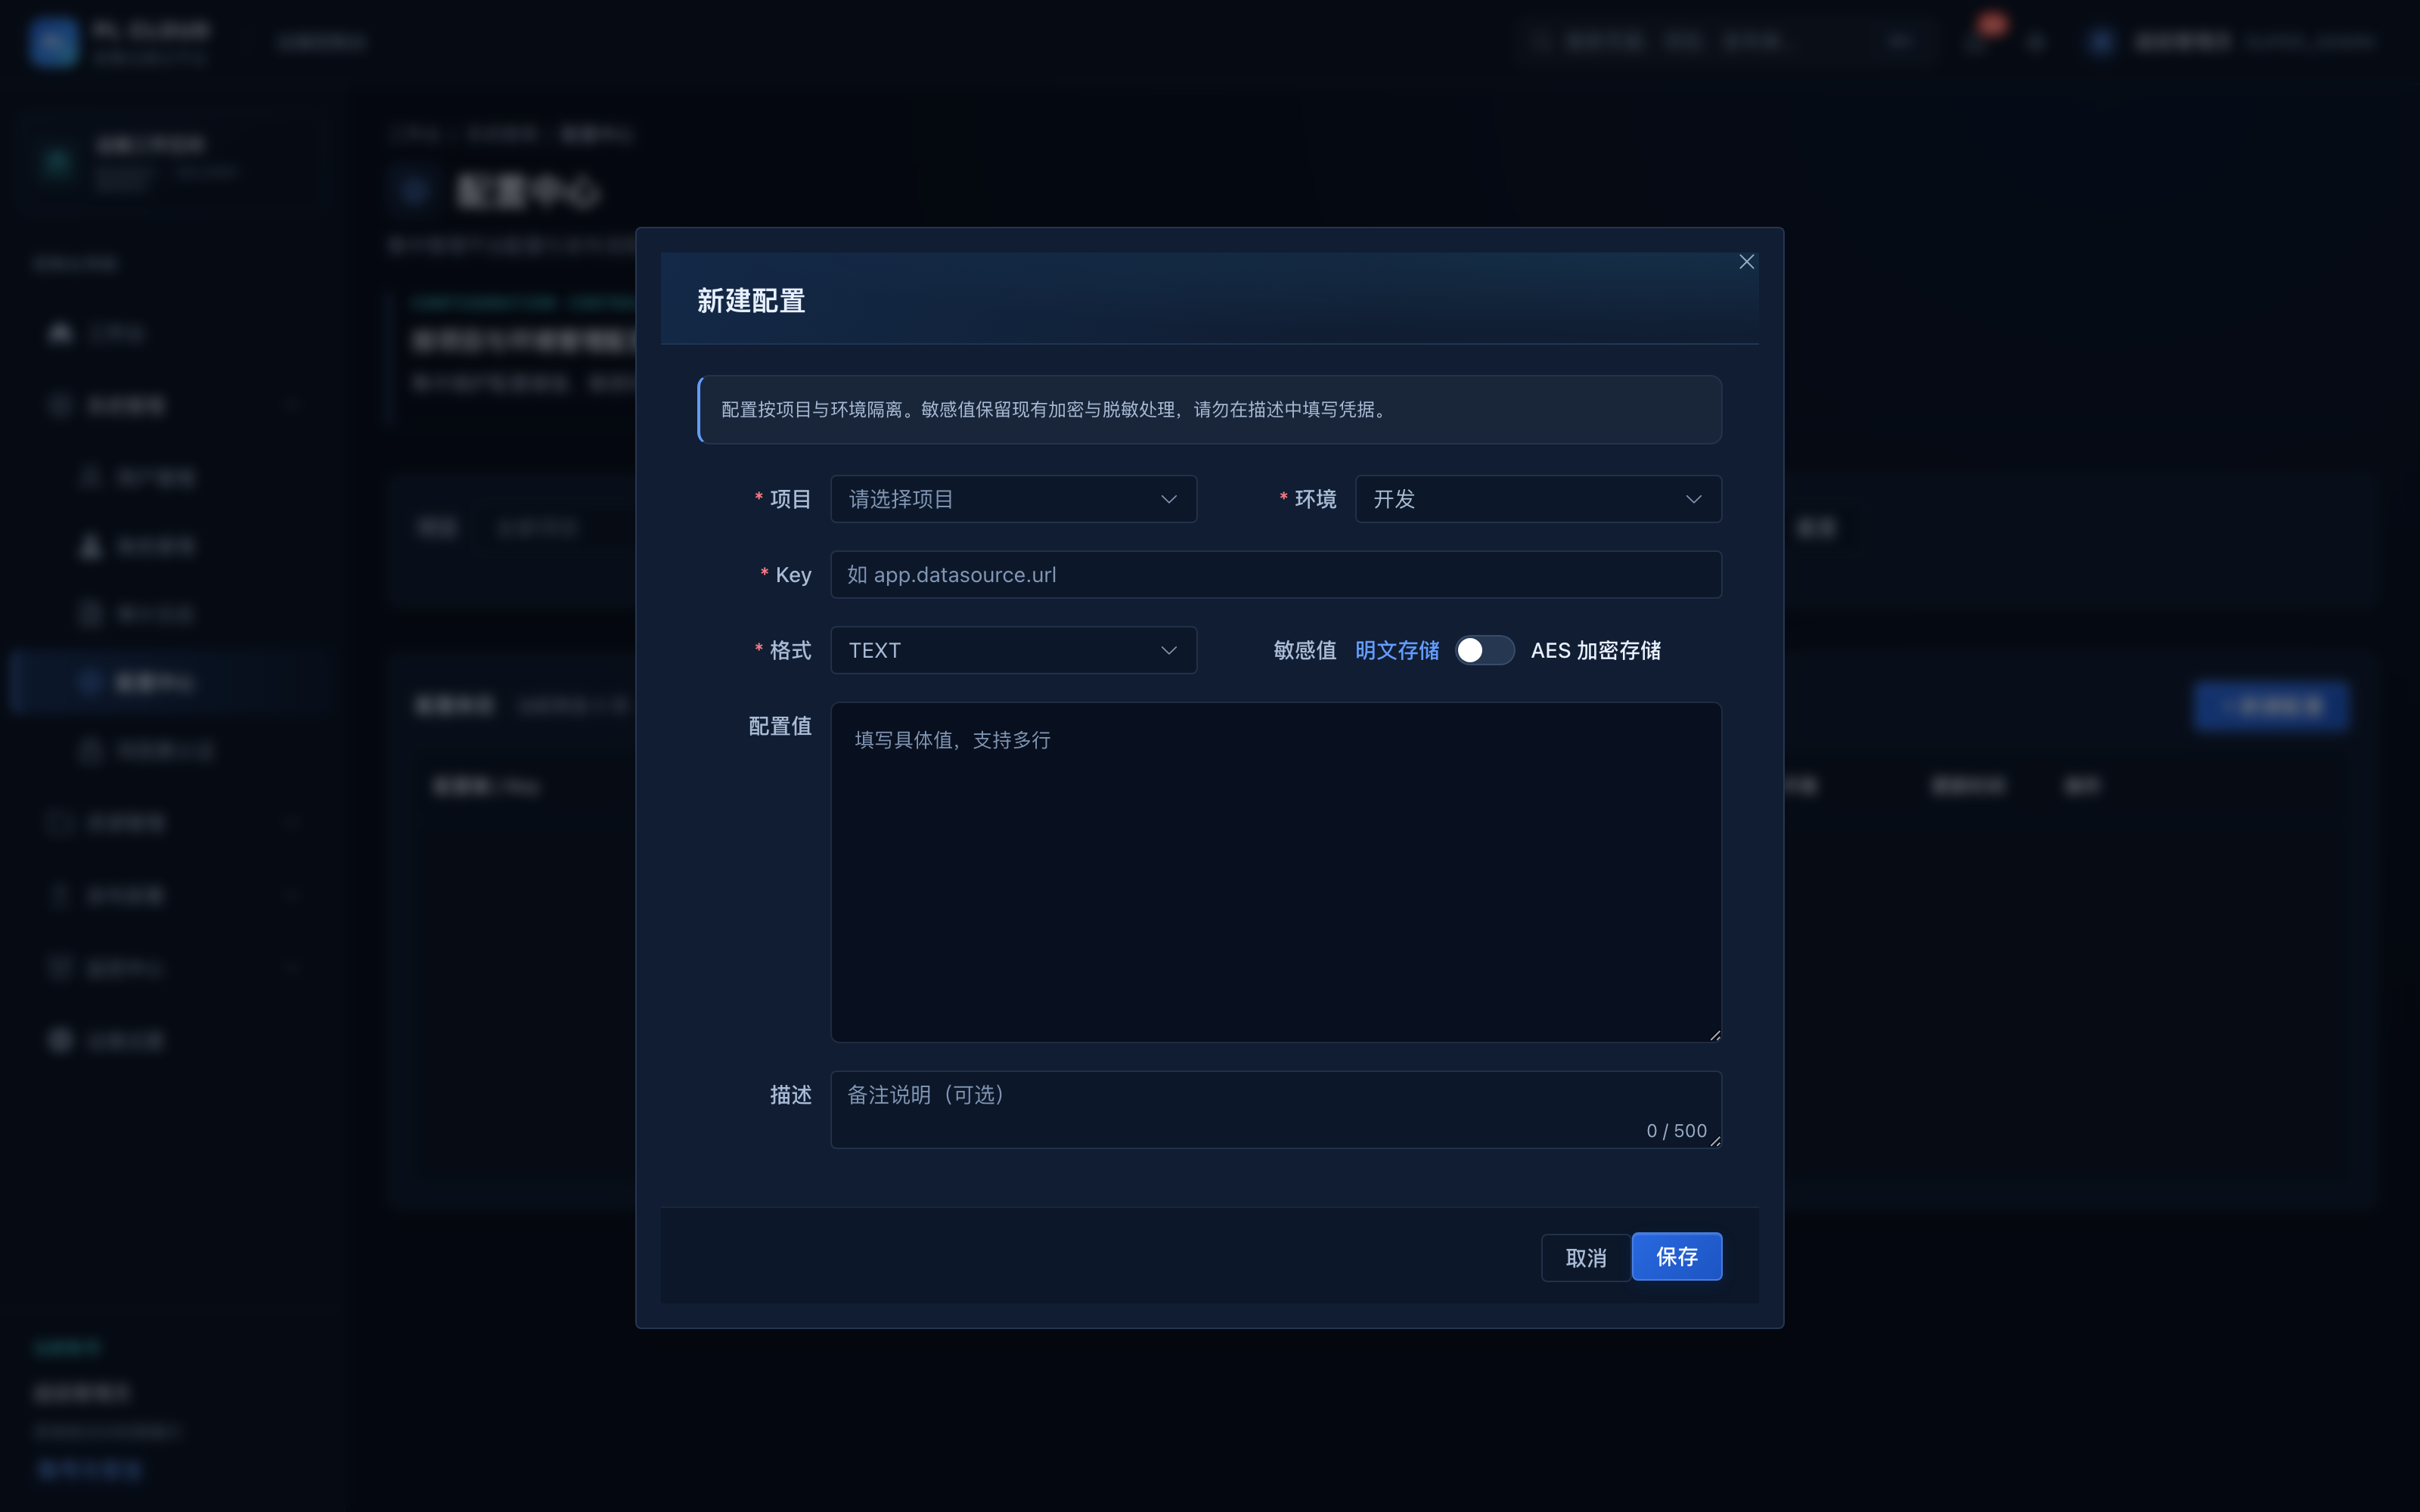
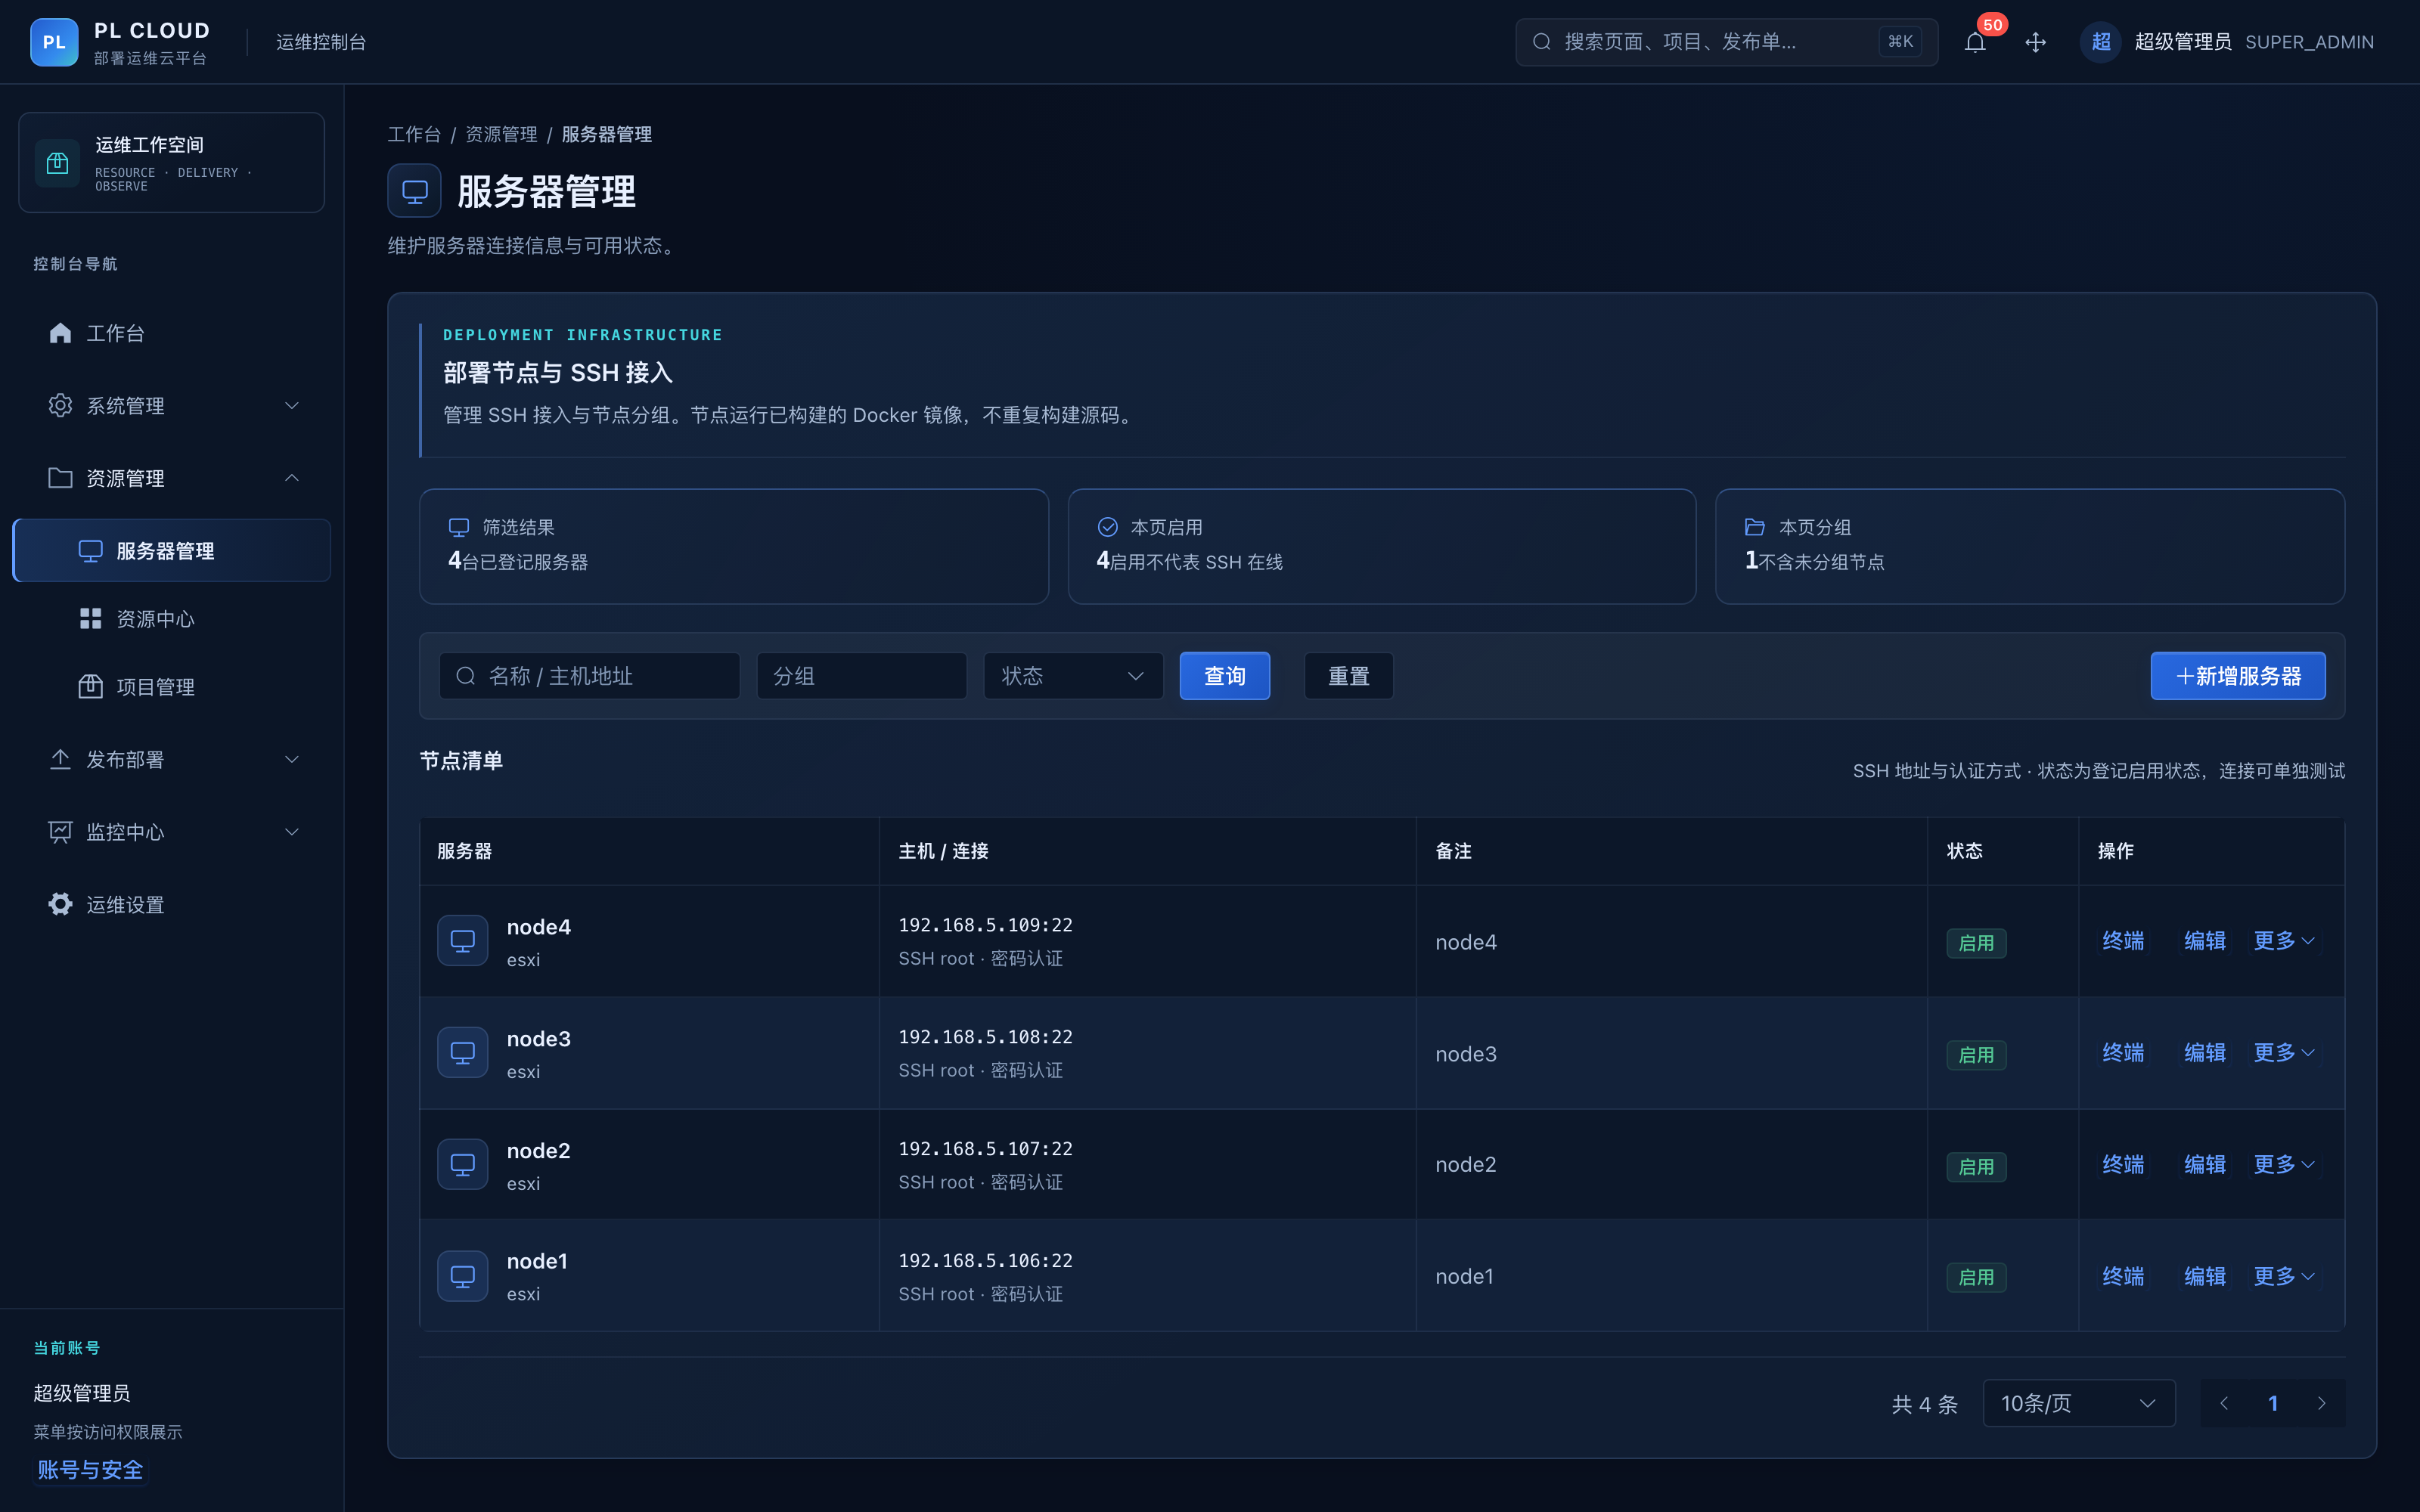
资源中心统一管理 MySQL / Redis / HTTP 等被管资源,服务器管理持有 SSH 凭据(AES-GCM 加密)并提供 xterm.js Web 终端,项目管理绑定 Git 仓库与环境配置。配置中心支持按项目 + 环境存配置项、加密存储、历史版本与一键回滚。
2.4 监控、告警与慢 SQL
监控大盘看服务器 / 实例 / 发布的实时概览,告警中心把阈值、持续时长、静默期、通知渠道全部配置化,数据库监控页除了 QPS / 连接数 / 命中率,还接了 performance_schema 的慢 SQL 摘要与样本。


2.5 安全体系与审计
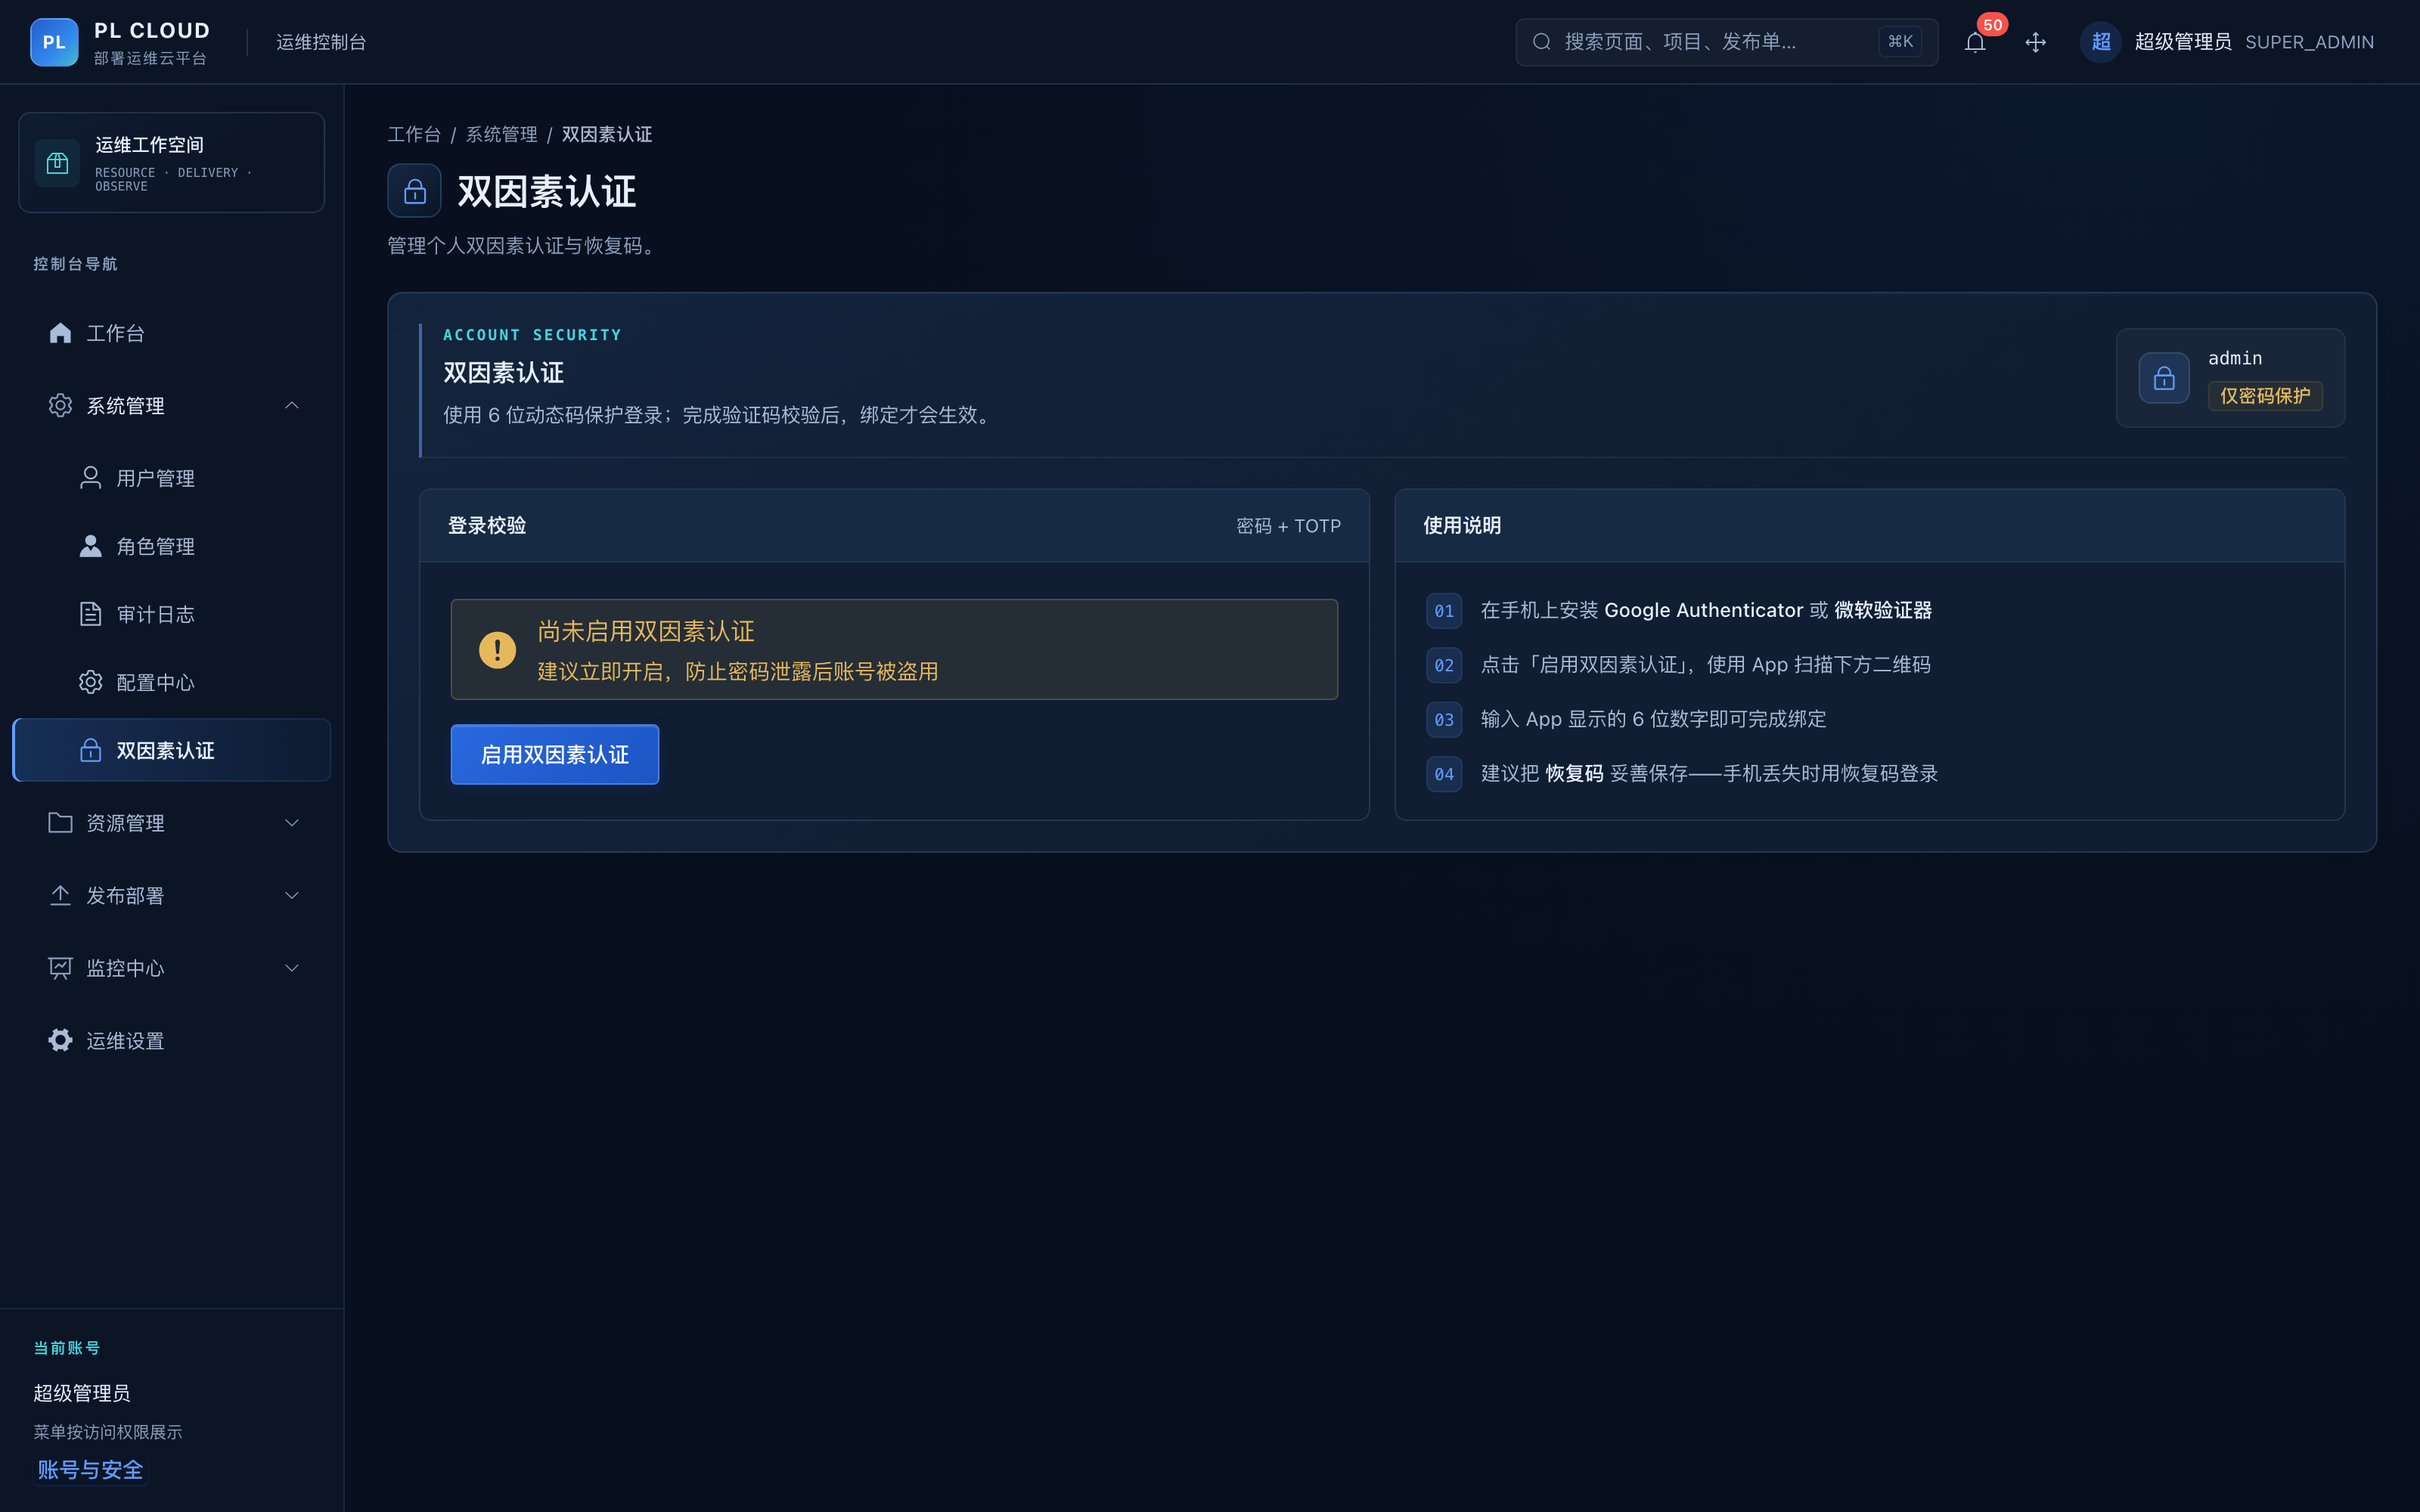
V5 新增的界面集中在系统管理下:双因素认证(TOTP + 恢复码)、运维设置(冻结期 / API Token / 通知渠道 / 安全策略)、用户与角色(RBAC + 数据范围)、审计日志(含变更前后 diff)。

2.6 工作台与 DORA
工作台聚合待办、异常发布、异常实例、未处理告警与异常资源,右上角「当前可发布管理 59 项」。V5 还实现了 DORA 四指标组件与 /api/dashboard/dora 接口——不过这里有个伏笔,见第五节。
三、怎么做的:七个值得展开的实现
3.1 迁移基线重建:先合并,再往前走
历史迁移脚本积累到二十几个版本后,新环境初始化要跑一遍长链,老环境又可能因为某次手工改表与脚本漂移。V5 的做法是把当前完整 schema 冻结成一张全量快照,之后只挂增量:
-- V101__immutable_release_images.sql
ALTER TABLE sys_release
ADD COLUMN image_id VARCHAR(80) NULL,
ADD COLUMN image_checksum VARCHAR(64) NULL,
ADD COLUMN image_size_bytes BIGINT NULL,
ADD COLUMN artifact_release_id BIGINT NULL,
ADD COLUMN runtime_snapshot_cipher MEDIUMTEXT NULL;
CREATE INDEX idx_release_artifact ON sys_release (artifact_release_id);# application.yml(节选)
spring:
flyway:
enabled: true
baseline-on-migrate: true
baseline-version: 99 # 老库标记为 99,只执行 V100+
locations: classpath:db/migration两个细节值得抄:baseline-version=99 让存量库跳过历史脚本,直接以 V100 为准;locations 只扫根目录,历史增量移到 archive/ 子目录(Flyway 默认不递归),既不丢历史也不干扰新环境。V101 只加 nullable 列与一个索引,代码回退时不需要 DROP COLUMN——旧代码忽略这几列即可。
3.2 不可变制品:构建一次,全程复用
上一版回滚是"按版本重新走一遍发布",风险在于重新构建可能拉到不同的依赖、不同的基础镜像。V5 在 BUILD 阶段把镜像导出成原始归档,封存到平台本地,并把身份信息写回发布单:
// service/impl/deploy/BuildStage.java(节选)
String save = "set -e\nset -o pipefail\nmkdir -p " + scripts.sh(ctx.dir()) + "\n"
+ "(set -C; docker save " + scripts.sh(imageId) + " > " + scripts.sh(remoteArchive) + ")\n"
+ "sha256sum -- " + scripts.sh(remoteArchive) + " | cut -d ' ' -f1\n"
+ "wc -c < " + scripts.sh(remoteArchive) + "\n";
SshService.CommandResult saved = sshService.execute(builder, scripts.wrap(save), BUILD_TIMEOUT_MS, null);
String[] metadata = saved.output().trim().split("\\s+"); // [checksum, size]
archive = imageStore.capture(builder, release, remoteArchive, imageId, metadata[0], size);
ctx.persist(); // Seal metadata before distribution: a failed BUILD retry must reuse it.ctx.persist() 这一行是整个设计的支点:先把元数据落库,再分发。否则 BUILD 分发到一半失败,重试时可能重新构建出一个内容不同的镜像,而发布单上记的还是旧 ID。
分发时逐节点做三重校验,任一不符直接拒绝启动:
// service/impl/deploy/BuildStage.java · distribute()(节选)
String verifyAndLoad = "set -e\nset -o pipefail\n"
        + "[ ! -L " + scripts.sh(remoteArchive) + " ] && [ -f " + scripts.sh(remoteArchive) + " ]\n"
        + "[ \"$(sha256sum -- " + scripts.sh(remoteArchive) + " | cut -d ' ' -f1)\" = "
        + scripts.sh(release.getImageChecksum()) + " ] || { echo '[error] 镜像 SHA256 校验失败'; exit 1; }\n"
        + "[ \"$(wc -c < " + scripts.sh(remoteArchive) + ")\" -eq " + release.getImageSizeBytes()
        + " ] || { echo '[error] 镜像大小校验失败'; exit 1; }\n"
        + "docker load -i " + scripts.sh(remoteArchive) + "\n";
if (!release.getImageId().equals(inspectImage(server, release.getImageId()))) {
    throw new BusinessException("加载后的镜像 ID 不匹配,禁止启动");
}
制品仓本身的写入也做了防御,避免了两类常见事故:
// service/impl/deploy/ReleaseImageStore.java · capture()(节选)
if (remotePath == null || !remotePath.startsWith("/") || remotePath.indexOf('\0') >= 0
        || !remotePath.substring(remotePath.lastIndexOf('/') + 1).matches(
                "release-" + release.getId() + "-[a-f0-9-]{36}\\.image\\.tar")) {
    throw new BusinessException("只能下载平台生成的发布镜像归档路径");
}
if (Files.exists(archive, LinkOption.NOFOLLOW_LINKS)) {
    verifiedArchive(metadata);          // 崩溃恢复遇到已封存归档,绝不截断重写
    applyMetadata(release, metadata);
    return archive;
}
Files.createLink(archive, temp);        // 同文件系统硬链接:原子发布且 no-clobber
为什么用 createLink 而不是 ATOMIC_MOVE?注释写得很直白:Unix 下 ATOMIC_MOVE 即使不带 REPLACE_EXISTING 也可能覆盖已有目标,而硬链接在目标存在时必然抛 FileAlreadyExistsException。"绝不能覆盖已封存的制品"是硬约束,不是优化项。
3.3 加密运行快照:让续跑不被中途的配置变更带偏
镜像只解决"代码是什么",环境变量、资源连接信息这些"运行配置是什么"同样需要固化,但里面可能含密钥,不能明文落库:
// service/impl/deploy/ReleaseRuntimeSnapshots.java · capture()(节选)
public void capture(SysRelease release, SysProject project, SysProjectEnv env,
                    Map<String, String> variables) {
    if (StringUtils.hasText(release.getRuntimeSnapshotCipher())) return;  // 只封存一次
    SysProject runtimeProject = objectMapper.convertValue(project, SysProject.class);
    runtimeProject.setGitRepo(null);
    runtimeProject.setGitUsername(null);
    runtimeProject.setGitTokenCipher(null);                    // 剥离 Git 凭据
    Snapshot snapshot = new Snapshot(1, runtimeProject,
            objectMapper.convertValue(env, SysProjectEnv.class), new LinkedHashMap<>(variables));
    release.setRuntimeSnapshotCipher(
            cryptoService.encrypt(objectMapper.writeValueAsString(snapshot)));
}
schemaVersion=1 为将来兼容留了口子;restore() 会校验 projectId / envId 匹配,杜绝把 A 项目的快照拷给 B 项目。回滚入口先 runtimeSnapshots.validate() + imageStore.verifiedArchive() 双校验,再把 5 个字段复制到新回滚单——回滚发的是当初那一版,不是重新打的包。
3.4 断点续跑:所有角色只读一个字段
DeployExecutor 按 DeployStage.ordinal() 排序 handlers,跳过 sys_release.stage 已完成的阶段。这里最容易被忽略的是 PREPARE 的重放:
// service/impl/DeployExecutor.java(节选)
if (DeployStage.completedAtLeast(normalizedCompleted, DeployStage.PREPARE)) {
    if (release.getPortOffset() == null) {
        throw new BusinessException("历史发布缺少端口执行计划,无法安全续跑,请重新发起发布");
    }
    DeployStageHandler prepare = handlers.stream()
            .filter(handler -> handler.stage() == DeployStage.PREPARE)
            .findFirst().orElseThrow(...);
    prepare.execute(ctx);              // 重放计划,但不重新探测端口
}
for (DeployStageHandler handler : handlers) {
    if (DeployStage.completedAtLeast(normalizedCompleted, handler.stage())) continue;
    if (cancellation.isRequested(releaseId)) { finishTerminated(...); return; }
    ...
}三个不变量:端口槽位(0 / +1000 / +2000)一旦选定就写进发布单,续跑绝不重新探测;SWITCH_LB reload 成功后先 markCompleted 再排空 10 秒,因为那一刻起已经越过不可回退点;终止信号只在阶段边界协作式检查,不强杀线程——发布线程手里握着远程容器状态,强杀意味着没人收尾。
3.5 安全:用 Redis Lua 把并发漏洞堵死
V5 的安全体系里,最见功力的不是"支持了 MFA / SSO",而是几个并发场景用 Lua 脚本做原子操作。比如 MFA 挑战的尝试次数限制,如果写成 GET → INCR → 判断 三步,并发请求能绕过上限:
// service/impl/MfaServiceImpl.java
private static final DefaultRedisScript<String> RESERVE_ATTEMPT = new DefaultRedisScript<>(
        "local uid = redis.call('GET', KEYS[1]); if not uid then return '' end; "
                + "local n = redis.call('INCR', KEYS[2]); "
                + "if n == 1 then redis.call('PEXPIRE', KEYS[2], redis.call('PTTL', KEYS[1])) end; "
                + "if n > tonumber(ARGV[1]) then redis.call('DEL', KEYS[1], KEYS[2]); return '' end; "
                + "return uid", String.class);
SSO 的 state 消费同理——比对 provider 与删除必须在一次原子操作里完成,否则 state 可被重放:
// service/impl/OAuth2LoginServiceImpl.java
private static final DefaultRedisScript<Long> CONSUME_STATE = new DefaultRedisScript<>(
        "if redis.call('GET', KEYS[1]) == ARGV[1] then "
                + "return redis.call('DEL', KEYS[1]) end return 0", Long.class);
再配一个"上线前拦一道"的启动检查,把默认密钥这类低级事故挡在启动阶段:
// init/SecurityStartupCheck.java(节选)
boolean prod = environment.acceptsProfiles(Profiles.of("prod"));
checkKey(prod, "JWT secret (PL_JWT_SECRET)", jwtProperties.getSecret(), DEFAULT_JWT_SECRET);
if (cryptoProperties.getKeys() == null || cryptoProperties.getKeys().isEmpty()) {
    unsafe(prod, "缺少独立 pl.crypto.keys 密钥,禁止回退到 JWT 密钥");
} else {
    for (CryptoProperties.Key key : cryptoProperties.getKeys()) {  // 轮换历史 key 也要查
        checkKey(prod, "pl.crypto.keys[" + key.getId() + "]", key.getValue(), DEFAULT_CRYPTO_KEY);
    }
}
prod 下不满足直接 IllegalStateException 起不来,非 prod 只告警。它检查的是全部轮换历史 key,因为少一个历史 key 就意味着一批旧密文解不开。此外还有 159 处 @PreAuthorize("@perm.has('x')")、审计切面的密码脱敏与前后 diff、数据范围 ALL > PROJECT > SELF 的编程式判定、API Token 只存 SHA-256 哈希且明文仅返回一次。
3.6 Pipeline DAG 与策略执行层
自定义流水线要防的是"用户配出一张有环的图"。实现是标准的 Kahn 拓扑排序,加了一个很实在的约束——队列每次排序保证确定性,否则同一份配置两次执行可能得到不同顺序:
// service/impl/PipelineDagService.java · topoSort()(节选)
List<String> order = new ArrayList<>();
while (!queue.isEmpty()) {
    Collections.sort(queue);            // 简单排序保持确定性
    String cur = queue.remove(0);
    order.add(cur);
    for (String next : adj.get(cur)) {
        if (indegree.merge(next, -1, Integer::sum) == 0) queue.add(next);
    }
}
if (order.size() != nodes.size()) throw new BusinessException("DAG 存在环,无法拓扑排序");发布策略这一版终于从配置层落到了执行层(V4 遗留的欠账):StartInstancesStage 按 deploymentStrategy 分支,CANARY 先按 canaryPercentage 算出金丝雀实例数,首批启动后强制跑一次 PostDeployVerificationService,通过才推剩余批次:
// service/impl/deploy/StartInstancesStage.java(节选)
String strategy = resolveStrategy(env);
switch (strategy) {
    case STRATEGY_CANARY     -> executeCanary(ctx, env);
    case STRATEGY_BLUE_GREEN -> executeBlueGreen(ctx, env);
    default                  -> executeRolling(ctx);
}
// CANARY:canaryCount = floor(total * canaryPercentage / 100),最小 1 台
// 第一批启动 canaryCount 台 → waitAndVerifyCanary() → 通过后才推剩余批次
人工卡点预置成 WAITING 状态的 sys_release_stage 记录,执行器遍历到该阶段时 break 保持 RUNNING,等 continue 接口调用后再从断点继续——卡点和断点续跑共用同一套状态机,没有另起一套机制。
3.7 DORA:先定义口径,再谈数字
DoraController 统计近 30 天,四个指标口径都写在代码里,不玩黑盒:
// controller/DoraController.java(节选)
private static final int PERIOD_DAYS = 30;
private static final List<String> FAIL_STATUSES = List.of("FAILED", "REJECTED", "TERMINATED");

// 1. 部署频率:成功数 / 30 * 7(折算周频)
double deployFrequency = Math.round((successCount / (double) PERIOD_DAYS) * 70.0) / 10.0;
// 2. 变更失败率:失败状态数 / 总数
double changeFailureRate = total == 0 ? 0.0
        : Math.round((failedCount / (double) total) * 1000.0) / 1000.0;
// 3. MTTR:失败单 startedAt → finishedAt 均值(小时)
// 4. 前置时间:createdAt → startedAt(当前为近似口径)
四、结果如何
所有数字取自运行中实例(采集时间 2026-11-20),不是压测环境也不是示意数据:
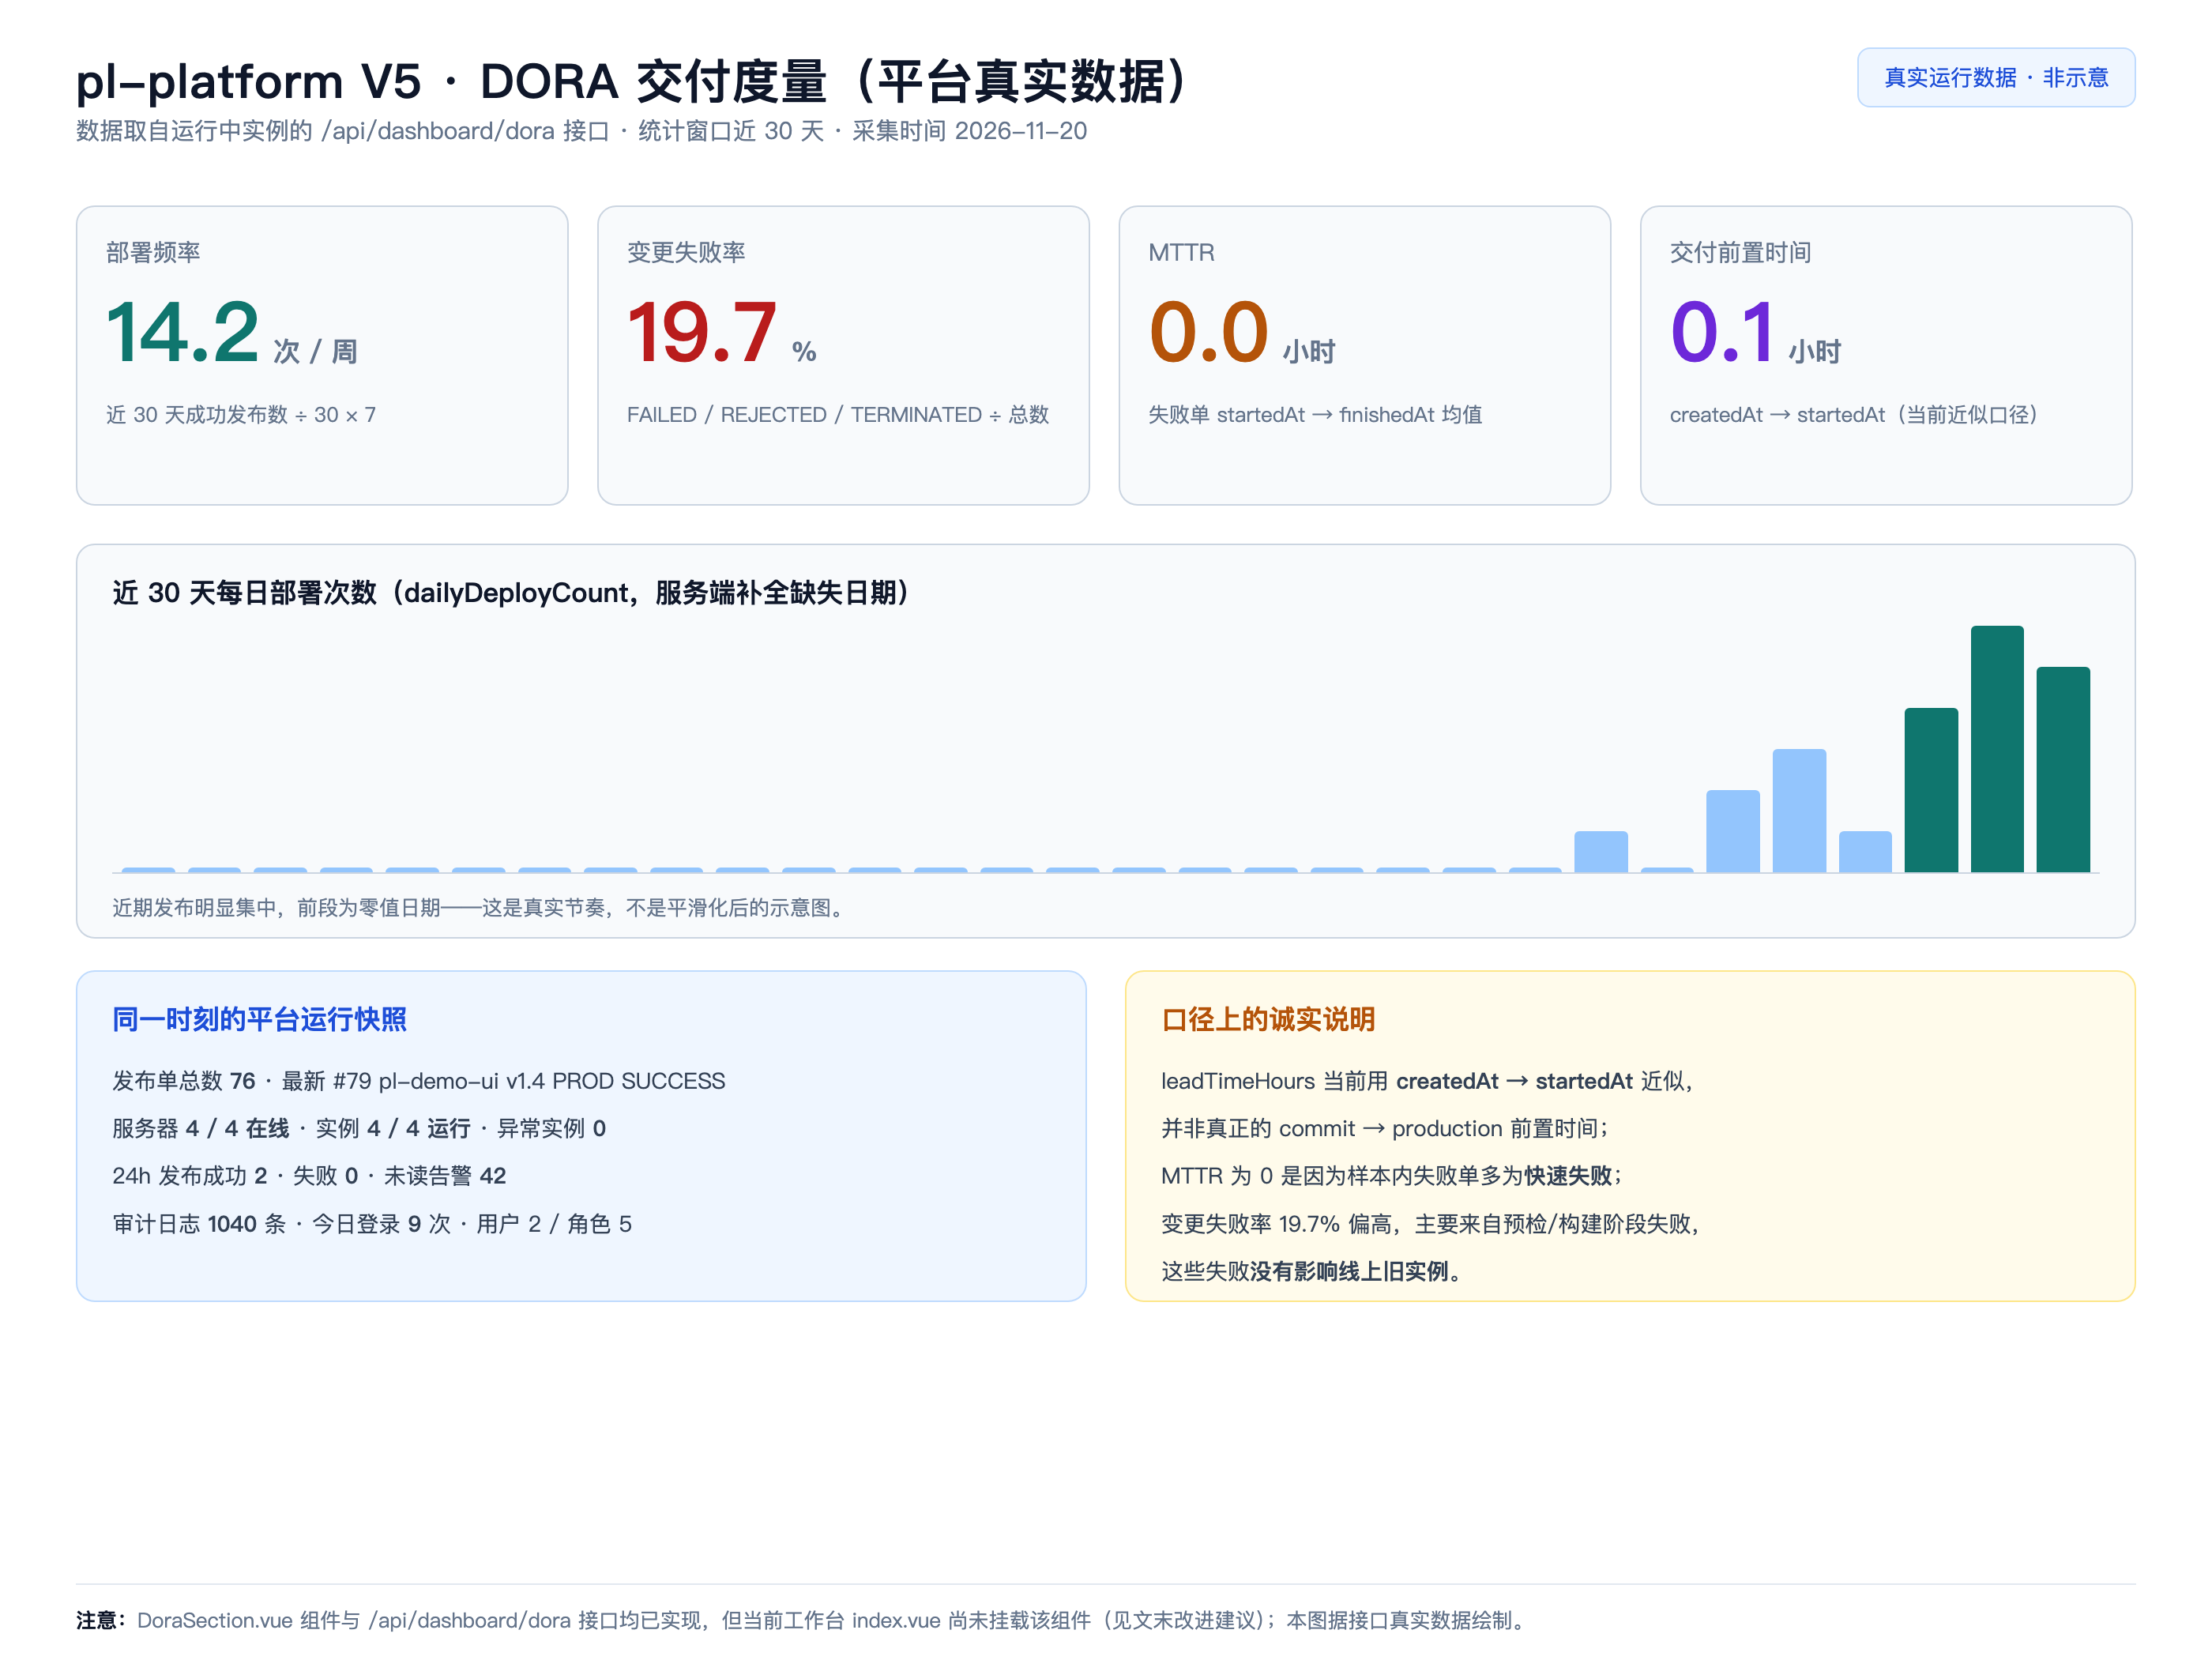
关于 19.7% 这个偏高的失败率,值得多说一句:它不是线上事故率。平台的失败大量发生在 PREFLIGHT(资源不通)和 BUILD(构建失败),此时 lbSwitched()==false,discardScript 只删本次新起的孤儿容器,旧实例全程在线。把"快速失败"和"变更导致故障"混在一个百分比里,是 DORA 落地时最常见的误读,后面改进建议里会再提。
工程侧的变化同样可量化:
代码组织:340 个 Java 类、26 个 Controller、207 个
@*Mapping,发布引擎被拆成deploy/下 10+ 个阶段与支撑类,DeployExecutor从早期 558 行瘦到编排职责清晰的状态机。测试:20 个测试类、219+ 用例,其中安全类占比最高——
BuildExecutorSecurityTest(21)、GitRefResolverTest(23)、DeployServiceImplSecurityTest(18)、BuildStageSecurityTest(13)、ReleaseImageStoreTest(7)、ReleaseRuntimeSnapshotsTest(7)。测的不是 happy path,而是 ref 注入、路径穿越、符号链接、坏校验和、并发恢复码复用这些攻击面。守护:7 个 ShedLock 定时任务(15s 队列重投、60s 卡单巡检、60s 发布后健康、每日 3:30 数据清理等),管理端点独立在
127.0.0.1:8081,不对外暴露。
五、局限与我的改进建议
以下都基于本次读码时确认的事实,不是泛泛而谈的"可以考虑微服务化"。
5.1 流量切分仍是「实例分批」,不是「权重分流」(优先级最高)
StartInstancesStage 的 CANARY 实现是"先起 N 台新实例 → 验证 → 再起剩余实例",但 SwitchLbStage 全文 121 行里没有任何 weight / split_clients / 流量比例逻辑,仍然是 MANAGED / EXTERNAL 两条分支一次性全切。也就是说,配了 canaryPercentage=10,实际得到的是"10% 的实例",而流量在切流那一刻是按 upstream 中的 server 数均分的——配置语义与执行语义不一致。
更需要注意的是,首批 waitAndVerifyCanary() 发生在 SWITCH_LB 之前,此时新实例还没接入外部流量;如果验证服务取的是全局监控数据,它看到的很可能是旧版本的信号。建议:
把「切流量」从
SwitchLbStage抽成可替换的TrafficProvider(snapshot / apply / drain三个方法),接口用声明式apply(plan, stepIndex)而非增量shift(+10%),保证断点续跑重试幂等;策略降级为数据:
ROLLING=[100]、BLUE_GREEN=[100]+hold 300s、CANARY=[10,30,50,100],每步traffic_step落库,只有最后一步才markCompleted;验证钩子移到每一步 apply 之后,确保验证的是真正承接了流量的新版本。
这三点的完整落地路径我单独写过一份《TrafficProvider 抽象与发布策略落地 · 开发计划》,思路仍适用,但需要按 V5 的 V100/V101 基线更新文件清单与 markCompleted 时机。
5.2 DORA 组件已实现,但没挂到工作台上
views/dashboard/DoraSection.vue(275 行,含 ECharts 柱状图与四指标卡)和 /api/dashboard/dora 接口都在,但全项目搜索 DoraSection 只命中组件自身——views/dashboard/index.vue 没有引用它。也就是说用户在工作台看不到 DORA,只能调接口。这是一行 import + 一行标签就能补上的缺口,建议优先修。
5.3 加密配置的历史版本是明文落库(安全)
ConfigServiceImpl.save() 里,isEncrypted=1 的条目主表 config_value 走 cryptoService.encrypt(value),但写历史时:
// service/impl/ConfigServiceImpl.java
String oldPlain = existing.getIsEncrypted() == 1
        ? cryptoService.decrypt(existing.getConfigValue()) : existing.getConfigValue();
...
SysConfigHistory h = buildHistory(existing, oldPlain, value, "UPDATE", ...);
historyMapper.insert(h); // 明文进 sys_config_history结果是:读 sys_config_history 就能拿到所有加密配置的全部历史明文,主表加密等于白做,回滚功能还会把明文再写回主表(虽然会再次加密,但历史已经泄露)。建议 history 表同样存密文,或单独加 value_cipher 列;diffSummary 只保留"已变更"这类不含值的描述。
5.4 DORA 口径需要接真实交付链路
当前 leadTimeHours = createdAt → startedAt,衡量的是"发布单排队时间",不是 DORA 定义的 commit → production 前置时间;changeFailureRate 把预检/构建快速失败与真实线上故障混算,导致 19.7% 这个数字无法直接用于改进决策。建议:
用发布单已记录的
commitSha,结合 Git 提交时间算真正的前置时间;失败率按
lbSwitched()拆成pre-switch failure(不影响线上)与change failure(切流后回滚/失败)两个指标;MTTR 只统计切流后失败单,否则"0.0h"这种数字没有指导意义。
5.5 单体边界与运维细节
340 个 Java 类仍在一个 Spring Boot 工程里,service/impl 顶层已接近 50 个类。短期不必拆服务,但建议按 deploy / security / observability / platform 划清包边界并用 ArchUnit 之类加一条依赖约束,避免继续互相穿透。另外三点小建议:
验证阈值仍是代码常量(CPU 90% / QPS -50% / errorRate 5%),应挪进环境配置或复用告警规则表;
发布详情页仍是轮询,列表页已上 WebSocket,建议复用
/ws/release/{id}通道把阶段与日志统一推;管理端口 8081 绑 127.0.0.1 是好设计,但 Prometheus 抓取需要同机 sidecar 或 exporter,文档里应写明部署形态,否则"接了 Prometheus"实际上抓不到。
六、小结
V1 到 V3 解决的是「发布能不能成」,V4 解决「发布之后好不好」,V5 回答的是更靠前也更基础的问题:这次发布是什么、凭什么可信、出了问题能不能复现。
分水岭在于:前三轮靠状态机,第四轮靠度量,这一轮靠的是把事实固化成数据——镜像 ID 与校验和、加密运行快照、阶段进度、审计 diff、DORA 口径。当一次发布可以被完整描述、被重放、被审计,它才从"运维同学的一次操作"变成"工程系统里的一条记录"。
以及一句不太好听但必须说的:V5 把地基打得很扎实,但流量切分这一层还没跟上。地基已经允许我们做真正的金丝雀了,下一步就该把它补上。
附:本文配图清单
声明:所有界面截图来自本地运行实例(admin 登录后 @2x 采集),所有运行数据取自平台自身 API;架构图与流程图依据
backend/src/main/java与db/migration源码绘制,不含推测性组件。

